把文档变成可核对数据的日语 OCR
用 space-ocr 读取日语票据、发票和送货单:混合文字、全角与竖排、不乱码的中日韩安全 CSV,值在 data.values,位置在 data.cells,需要复核的项列在 data.review.flagged。
日语是普通 OCR 悄悄崩掉的地方。一张票据里混着汉字、假名、半角片假名、全角数字,偶尔还有一段英文,而合计可能竖排在右边缘的一列里。大多数工具要么先让你选语言,要么返回一团丢了版面的扁平文本。真正有用的日语 OCR 必须一次读完这些,并告诉你每个数字来自哪里。
space-ocr 两件事都做。它读 JP 文档,把结构化字段放进 data.values,并把每个值连同它在页面上被读取的确切位置一起返回——data.cells[path] 里有框、四点 quad、判定和依据。没有通过核对的值会作为工作清单出现在 data.review.flagged 里,所以你看的是一条短队列,而不是重读整页。没有语言设置要选,日语、韩语、中文、英文由一个引擎一起处理。
看一次你可以亲自核对的真实日语提取
把鼠标悬停在下方任意字段上。这里读的两张票据是真实数据——合计 2,045 的 KINSHO 布施店和合计 4,286 的 ライフ 国分店,都是 2019 年 8 月的日期。每个值和框都直接读自一次真实的解析结果,而不是摆拍,框会跟随每一行混着汉字、假名和数字的文本。行旁边的字符匹配数值是辅助依据,不是及格线。
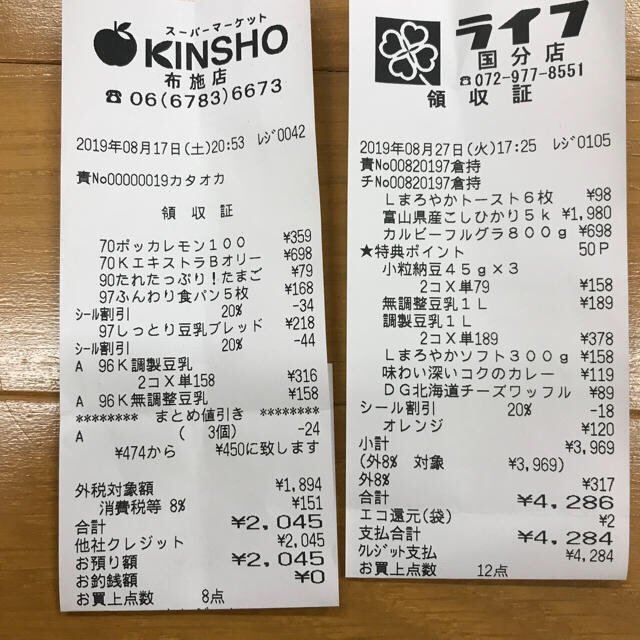
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocr 里的日语 OCR 如何工作
模型不产出坐标。它读文档、返回值,然后由字符匹配器把这些字符与 OCR 在页面上真正检测到的符号比对,这次比对产出框、quad 和每个单元格旁边的依据。verified 是与 review 互为镜像的判定:只要挂上任何理由就是 false,比对跑过且没有任何标记是 true,没有可比对的东西则是 null。字符比对本身在 evidence.text_match,而 evidence.match_ratio 给出字符覆盖率,属于辅助依据而非及格线。两个引擎仍可能在同一个误读上达成一致,所以这条队列告诉你先看哪里,并不是保证。
把 PDF 拖进应用,每一页会先被渲染成图片再读取——对多页发票和送货单很方便。直接调用 API 时,用 URL 或 base64 发送栅格页面图片,返回的结构化结果一样。声明你需要的 fields,或发送 autoFields: true 让响应替你提议;明细行用带 children 的 array 字段描述,路径写作 items[0].amount。
声明在提取之后才检查,也从不传给模型,因此它改变的是复核信号而不是读数。type: "date" 增加一层确定性的 data.normalized——令和8年8月16日 解析为 2026-08-16,而 data.values 保留印刷原样;type: "number" 把 ¥13,220 变成 13220。pattern 针对折成半角后的值比对,所以全角印刷的登记号也能用 ^T[0-9]{13}$ 匹配。对日本单据常见的当事人混淆,可以给收件方声明 near 词汇 御中 或 様,并把 登録番号 / TEL / 〒 声明为 not_near:选错的值就不会悄悄通过,而是以 near_mismatch 或 near_conflict 显示出来。数量栏的 一式、付款期限的 翌月末払い 这类本来就印成非数值写法的字段,留作 string 更好——一旦声明类型,正确的单据每次都会进复核清单。
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/invoice-jp.jpg",
    "imageType": "url",
    "fields": [
      { "name": "issuer", "type": "string", "required": true,
        "near": ["登録番号", "TEL", "〒"] },
      { "name": "bill_to", "type": "string",
        "near": { "terms": ["御中", "様"], "match": "suffix" },
        "not_near": ["登録番号", "TEL"] },
      { "name": "registration_no", "type": "string", "pattern": "^T[0-9]{13}$" },
      { "name": "issue_date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      { "name": "items", "type": "array", "children": [
        { "name": "name", "type": "string" },
        { "name": "qty", "type": "string" },
        { "name": "amount", "type": "number" }
      ] }
    ]
  }'
如何对日语文档做 OCR
- 添加你的文档在应用中拖入票据、发票或 PDF——每一页会被渲染成图片并排队 OCR。使用 API 时,把栅格页面图片(url 或 base64)发送到 /ocr/fields。没有语言设置。
- 声明你的字段列出你需要的 fields,或发送 autoFields: true 让响应提议一份 schema。明细行表格用带 children 的 array 字段,并在单据支持该规则的地方加上 type、pattern、near 或 not_near。
- 读取结构化结果业务数据留在 data.values。data.cells[path] 带着 box、quad、verified、review 和 evidence;data.image 是这些坐标的量度基准;data.normalized 存放已声明标量字段解析出的日期和数字。
- 处理复核队列遍历 data.review.flagged。每一项有 path,以及按排名排列、首项为主要理由的 reasons 数组,flagged.length 就是需要处理的数量。打开对应的单元格即可高亮该值被读取的区域。
- 导出或查询下载 CSV(UTF-8 BOM,日语能干净打开,明细行已展开),或用 GET /view 配合 where、sort、select 读取已存储的表格——读取已存的行不会重跑 OCR,GET /view 也不计费。
简单、可预期的定价
1 点数 = 1 页 = $0.05(含税),每月 100 点数免费,无需信用卡。失败不计费。套餐计划增加每月点数、更多表格和存储空间。