返回结构化字段而不是一堆文字的图像 OCR
用 space-ocr 对 JPEG、PNG 等图像做 OCR:声明你需要的字段,每个值都连同 box 与 quad 坐标一起返回,需要复核的值汇总在 data.review.flagged 里。
大多数图像 OCR只是丢给你一堆纯文本,然后就没了。你拍一张票据,跑一遍,回来的是一团行,你还得自己去读、去拆、再录进对应的列里。原本在页面上一眼就能看清的结构,没了。
space-ocr 把图像读成结构化字段——店名在这、日期在那、合计在那边、明细是一行行的。每个值还带着它在图像上被读取的确切位置:data.cells[path] 里有一个轴对齐的 box 和一个四点的 quad。而与页面核对不上的值,会带着理由出现在 data.review.flagged 里。所以回到你手里的是一份待办清单,而不是一个只能盲信的数字。
看一次你可以亲自核对的真实提取
这是一张图像——拍了两张票据的照片——被读成了字段。把鼠标悬停在下方任意值上,图像上的框就是这个值被读取的位置。这里的每个数字、框和字符匹配比例,都直接读自一次真实的解析结果,而不是摆拍。匹配比例说明的是这个值有多少字符在页面上被定位到,属于佐证,不是通过或不通过的判定分。
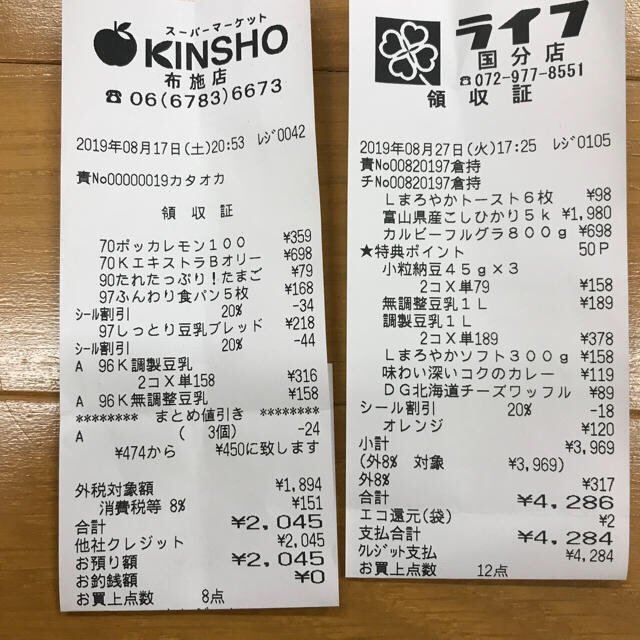
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocr 里的图像 OCR 如何工作
把图像以 URL 或纯 base64 发送到 /ocr/fields——JPEG、PNG、GIF、BMP、TIFF、WebP 都会被直接读取。EXIF orientation 在读取前生效,很大的照片可能会被缩到长边 4000px,所以真正被读的那一版页面尺寸由 data.image 给出,坐标都以它为基准换算。
你想要的结果用 fields 数组来描述:每个字段一个 name 和一个 type(string / number / integer / date / array / object),明细表用带 children 的 array 字段,需要时再声明 required、pattern、min/max 或 enum。想从文档出发,就发 autoFields: true,直接用返回的字段名。声明不会传给模型,因此不会左右读取本身——它决定的是哪些内容会进 data.review.flagged,以及确定性的 data.normalized 层解析出什么。(PDF 走 Web 应用,先把每一页渲染成图片;API 本身读的是图像。)
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/receipt-photo.jpg",
    "imageType": "url",
    "fields": [
      { "name": "store_name", "type": "string", "required": true },
      { "name": "date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      {
        "name": "items",
        "type": "array",
        "children": [
          { "name": "name", "type": "string" },
          { "name": "price", "type": "number" }
        ]
      }
    ]
  }'
如何对图像做 OCR
- 发送你的图像把 JPEG、PNG、GIF、BMP、TIFF 或 WebP 以 URL 或纯 base64 发送到 /ocr/fields,或拖进应用。EXIF 方向会在读取前生效。
- 声明你的字段发送一个 fields 数组,为每个值写明 name 和 type——明细行表格用带 children 的 array 字段。也可以把 autoFields 设为 true,从返回的字段名开始。
- 读取结构化结果业务数据留在 data.values。data.cells 为每个路径给出 box 与 quad、verified 判定和 evidence,data.image 则是把这些坐标换算成像素的基准。
- 处理待复核清单遍历 data.review.flagged:每一项都给出 path 和 reasons。打开 cells[path],把 box 画到图像上,再把值和那里印着的字对照。编辑会保存在原始 OCR 值旁边。
- 导出或查询下载 CSV(UTF-8 BOM,明细行已展开),或用 GET /view 配合 where、sort、select 查询已存储的表格——读取已存储的行不会重跑 OCR,也不计费。
简单、可预期的定价
每张图片 $0.05(含税),每月 100 点数免费且无需信用卡,失败的扫描不计费。套餐计划增加每月点数、更多表格和存储空间。