把扫描文档转成 CSV 的完整方法
教你如何把扫描文档转成 CSV:列只需定义一次,上传照片或扫描件,每份文档自动填入一行。只核对被标记为待复核的值,再导出为带 BOM 的 UTF-8 CSV,Excel 和中日韩文字都能正常打开。
你手头堆着一摞纸——发票、收据、送货单——要把它们变成电子表格里的一行行数据。手动重新录入又慢又容易出错,而普通的 OCR 工具只会吐出一大坨原始文本,还得自己费劲拆成一列列。其实你真正想做的事情更具体、也更有用:把一份文档的照片或扫描件,按事先定好的列变成一行干净的 CSV,而没能核对上的值会在进入文件之前被标记为待复核。
这篇指南讲的正是这件事。你只需把列定义一次,把图片交给 space-ocr,每份文档就会自动填好一行。没能和页面印刷内容对上的值会带着待复核标记返回,所以你只核对这些,而不必把每个单元格都重读一遍。做完之后,把整张表导出为 CSV——带字节序标记(BOM)的 UTF-8,因此 Excel 和中日韩文字都能正常打开。无需重新录入,而且每个值都能追溯到它在页面上的位置。
整个流程长什么样
把扫描文档转成 CSV,可以拆成四步:
- 拍照或扫描你的文档——栅格图像(JPEG、PNG、TIFF 等)。手机随手拍就行;歪着拍也没关系,会自动旋转校正。
- 把列定义一次——给你关心的字段起好名字(
vendor、date、total、明细行……)。这就成了之后每份文档都对照读取的列结构。 - 上传——每张图片被读取,值落入你那些列下面的新一行。无需逐份配置。
- 先看待复核的单元格,再导出 CSV——只处理被标记的值,然后把整张表下载为
<sheetName>.csv。
好处在于一致:因为列在一开始就固定下来,第十张收据落进来的形状跟第一张完全一样,而值得再看一眼的单元格会被点名列出,不用你自己去找。
先看证据:每个值都知道自己从哪来
讲步骤之前,先说说为什么它值得信赖。把鼠标移到下面任意一个字段上——文档上的方框会标出这个值是从哪个位置读出来的。和页面印刷内容对不上的值不会悄悄通过,而是被标记为待复核。一份 CSV,只有当里面的数字都经得起核对时才真正有用,而这里每个单元格都带着它的读取位置。
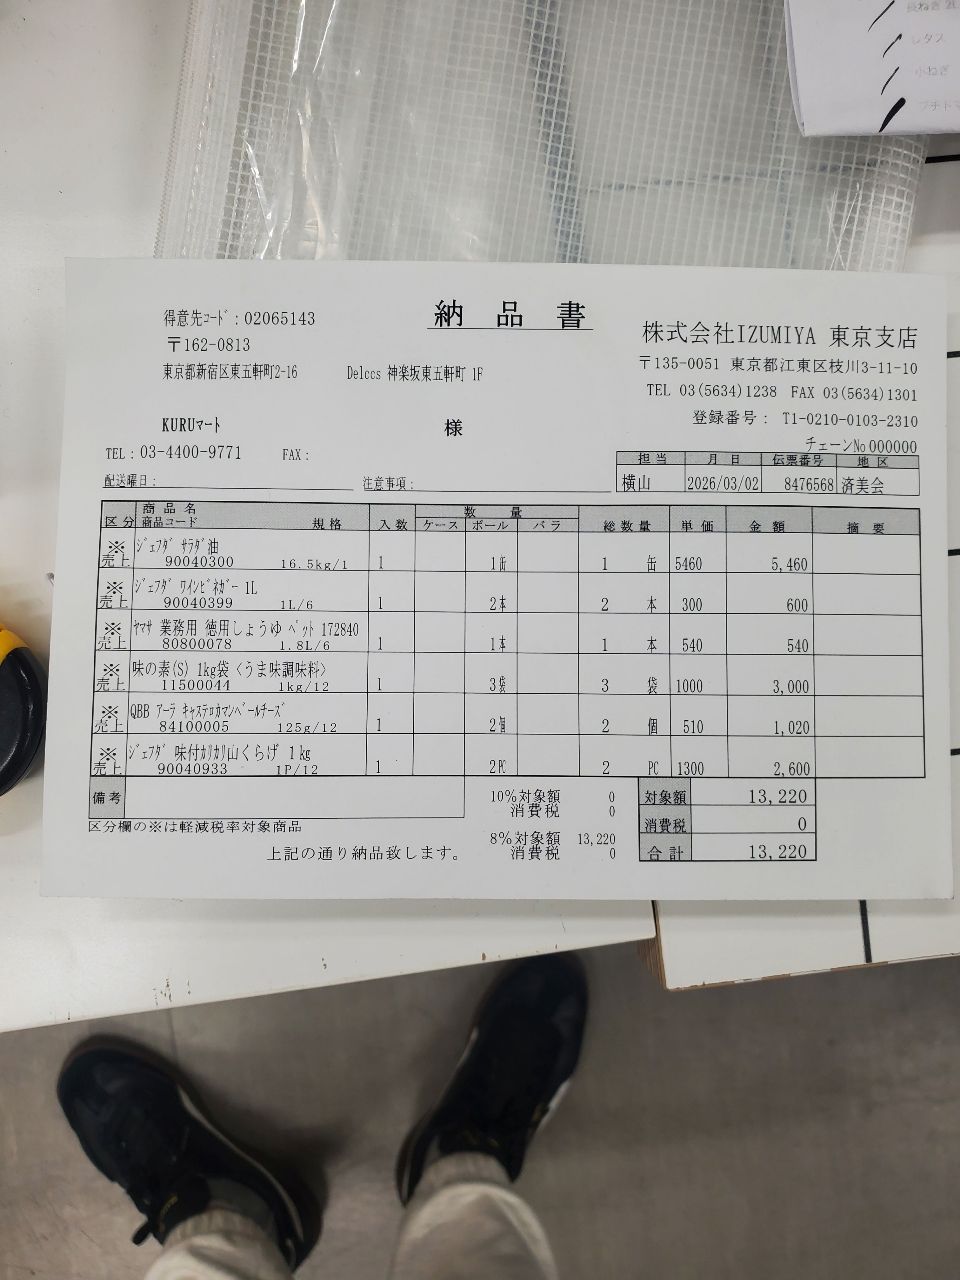
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
手把手:怎么把扫描文档转成 CSV
1. 把文档拍成图片
space-ocr 读取的是栅格图像——JPEG、PNG、GIF、BMP、TIFF 和 WebP。把收据摆在桌上拍照、把发票扫成 PNG,或者从扫描软件里导出页面都行。扫描版 PDF 也可以直接丢进应用,每一页都会自动转成图片。手机歪着拍也没问题:引擎会读取 EXIF 方向信息并校正旋转,所以即使是侧着拍的照片也能正立读取,值依然能锚定到正确的位置。
2. 把列定义一次
正是这一步,把 OCR 变成了一张整洁的表格。建一张表,给它定好列结构——也就是你想作为 CSV 表头的那些字段。标量列是简单的单值(vendor、invoice_date、total);数组列用来装会重复出现的明细行。这个只定义一次,之后你上传的每份文档都会对照同样的列来读取。
vendor        (string)
invoice_date  (string)
total         (string)
items         (array) → name, unit_price, qty
如果你不想手动搭这套结构,表格构建器可以从一张样例照片中检测出列,你再修改它给出的清单。只用 API 的话,POST /ocr/fields 的 autoFields 起同样的作用:先这样读一份文档,再把返回的字段名直接拿来当列。专门针对发票的情况,可以看从发票中提取明细行。
3. 上传——行自己填好
列就位之后,把图片上传到这张表。每份文档变成一行:引擎读取页面,把每个值放进对应的列下。丢进二十张收据,你就得到二十行,形状完全一致。明细行数组会作为该行的结构化子项保留下来,导出时随时可以展开。
值不会被重新格式化,而是保持印刷时的写法返回——7,855 里的逗号保留、全角字符和敬称也一并保留,不会被规范化后的形式覆盖。不过单元格里装的是模型对页面的读取结果,并不是逐字节一致的副本;需要和原件核对的单元格,会在下一步带着标记列出来。
4. 先看待复核的单元格,再导出为 CSV
不是每个单元格都需要再看一遍。每个值都会和页面上实际印的内容做比对,对不上的值,以及被列规则挑出来的值(比如必填列是空的),会被标记为待复核。只打开这些值,对照照片上高亮的位置修正即可;没有任何标记的单元格会照原样进入文件。在 API 中,同一份工作清单就是 data.review.flagged,每个路径都带着自己的 reasons。
然后点击导出,表会下载为 <sheetName>.csv。表头行直接由你的列结构生成:
- 开头一列
#(行号)。 - 每个标量列名按原样列出。
- 每个数组子字段展平为
colName.childName——所以一个带name和unit_price的items数组会生成items.name和items.unit_price两列。
包含明细行数组的行会展开成多个子行——父级的标量值出现一次,每条明细行在其下面各占一行,于是一张有八条明细的发票就变成八行 CSV,共享同一个供应商和日期。文件以带字节序标记(BOM)的 UTF-8 写出,正是这个 BOM 让 Excel——以及日文、韩文、中文——打开时不会出现乱码。
如果你手动改过某个单元格,导出时你手填的值会覆盖原始 OCR 值,所以修正会一路体现到 CSV 里。
下载本身在免费方案和按量付费方案下消耗 1 点数,Starter 与 Pro 则免费。重复下载同一张表不再计费,只有当表里新增了行之后才会再次计费。当前价格见价格页。
CSV 是按你的列生成的,不是猜出来的。 表头来自你的列结构(# + 标量列名 + 明细行的 array.child),数组行展开成子行,文件以 带 BOM 的 UTF-8 输出,所以 Excel 和中日韩文字都能正常打开。导出时手动修改会覆盖 OCR 值——列的形状在你定义它的那一刻就固定了,正因如此每次下载都是可预期的。
用 API 来做
同样的流程也可以无界面地跑。先建一张带列的表,往里上传图片,再用 GET /view 把结构化的行拉出来——在服务端完成,不重跑 OCR,也不计费。没有专门的 CSV 端点:你可以用返回的 JSON 自己写出 CSV,或者从网页应用里下载。GET /view 还允许你在导出前筛选(where)、排序、挑选列,这样就只输出你需要的那些行。
每一行的结构和直接调用时相同:业务数据在 values,坐标(box 与 quad)和校验判定(verified、review)在 cells[path],需要查看的路径清单在 review.flagged。给某一列声明 number、integer 或 date,values 仍然是印刷时的写法,解析后的值会以 normalized 附在每个单元格旁边(直接调用 POST /ocr/fields 时则整棵树作为 data.normalized 返回)。给人看的列写印刷原样的值,给系统计算的列写规范化后的值。
# 1. Create a sheet with the columns you want as CSV headers
curl -X POST https://api.space-ocr.com/create \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "path": "/invoices",
    "type": "sheet",
    "name": "june-invoices",
    "columns": [
      { "name": "vendor", "type": "string" },
      { "name": "invoice_date", "type": "string" },
      { "name": "total", "type": "string" },
      { "name": "items", "type": "array",
        "children": [
          { "name": "name", "type": "string" },
          { "name": "unit_price", "type": "string" }
        ] }
    ]
  }'

# 2. Upload document images — each one fills a row
curl -X POST https://api.space-ocr.com/upload \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -F "path=/invoices/june-invoices" \
  -F "files=@invoice-01.png" \
-F "files=@invoice-02.jpg"行就位之后,GET /view 会把它们以结构化 JSON 返回,你可以直接写成 CSV——或者交给你的会计系统。想完整了解提取端点和字段规格,可以看发票数据提取 API 指南和 API 文档。
扫描版 PDF,以及关于输入的一点说明
space-ocr 的引擎处理的是栅格图像,而不是 PDF 字节——不过在应用里你不用操心这件事:把扫描版 PDF 丢进来,每一页都会在 OCR 之前自动栅格化成图片。只有当你直接调用公开 API 时,才需要先把每一页渲染成图片(PNG 或 JPEG)再上传。如果你的目标明确是 Excel 而不是 CSV,同样这套流程照样适用——具体步骤见把扫描版 PDF 转成 Excel。CSV 是阻力最小的目标:哪儿都能打开,而带 BOM 前缀的 UTF-8 导出意味着不会有编码上的意外。
实例:PC 之外不保存任何数据的批量 CSV 转换
一位参与演示计划的外部开发者,把这套流程做成了一个小型 Windows 桌面应用:选择装有单据照片和扫描 PDF 的文件夹,通过 POST /ocr/fields 批量读取全部页面,需要复核的值对照原图的对应位置(返回的 quad 会框出读取来源)修正后导出 CSV。没有自建服务器,没有数据库,也没有云端存储。
这一架构的关键在于数据的存放位置。POST /ocr/* 是无状态的:处理图像并返回结果,图像和抽取结果都不会保存在 API 侧。所有持久化的数据都留在用户的电脑里——原始照片在文件夹中,复核后的值在应用里,CSV 在指定的保存位置,API 密钥也不是嵌入可执行文件,而是保存在用户自己的配置目录。离开这台电脑的只有 API 调用本身,而且不会在外部留下任何东西。
对于不便把单据再交给一个云服务的财务、行政团队来说,"之后是否需要申请删除"这个问题本身就不存在了——因为从一开始就没有在任何地方保存。两种值的分工也很务实:屏幕显示按印刷原样的值(与原件核对的是人),CSV 输出规范化后的值(做计算的是系统)。
- 把文档拍成图片把每份文档拍照或扫描成栅格图像(JPEG、PNG、TIFF 等)。手机照片就行——EXIF 自动旋转会校正侧拍的照片。扫描版 PDF 也行:把 PDF 丢进 space-ocr 应用,每一页都会自动栅格化(只有直接调用 API 时才需要先把每一页渲染成图片)。
- 把列定义一次建一张表并定好列结构:像 vendor、date、total 这样的标量列,外加用于装重复明细行的数组列。这会成为 CSV 表头,并对每份文档复用。
- 上传图片把你的文档图片上传到这张表。每张图片被读取,值自动填入你那些列下面的新一行——无需逐份设置,而且值会保持印刷时的写法。
- 先看待复核的单元格,再导出为 CSV只打开被标记为待复核的单元格,对照原图上的位置修正(在 API 中同一份工作清单是 data.review.flagged)。然后导出这张表,它会下载为 <sheetName>.csv,表头是 # 加上标量列名,再加上展平为 colName.childName 的数组子字段。明细行会展开成子行,文件是带 BOM 的 UTF-8,所以 Excel 和中日韩文字都能正常打开。