带审计追溯的文档 OCR
大多数 OCR 只丢给你一堆得照单全收的文字。space-ocr 会为每个值附上出处:data.cells[path] 中的 box 与 quad 坐标、支撑这次比对的 evidence,而需要人工过目的路径都汇总在 data.review.flagged 里。
从文档里提取数据,做个演示很容易,要让人放心却很难。模型读了一张发票,返回 total: 2,045,于是你面对一个再高的置信度分数也答不上来的问题:这到底是页面上真正印着的数字,还是模型自己生成出来的? 如果只是临时查一下,那无所谓。但换成记账、理赔、合规,或任何会被审计的场景,“相信模型就好”根本算不上一道控制。
审计追溯正是为此而生。每个字段返回的不再是一个孤零零的值,而是连同一处经过核验的页面定位一起返回——这样一个人(或另一套系统)就能直接跳到这个值被读取的那几个像素上去确认。这就是“一个答案”和“一个你拿得出去、站得住脚的答案”之间的区别。
亲眼看看:每个值都能追溯回原文
把鼠标悬停到下面任意字段上。小票上的方框就是这个值被读取的位置——每个字段也都带着与这处定位对应的核验状态。
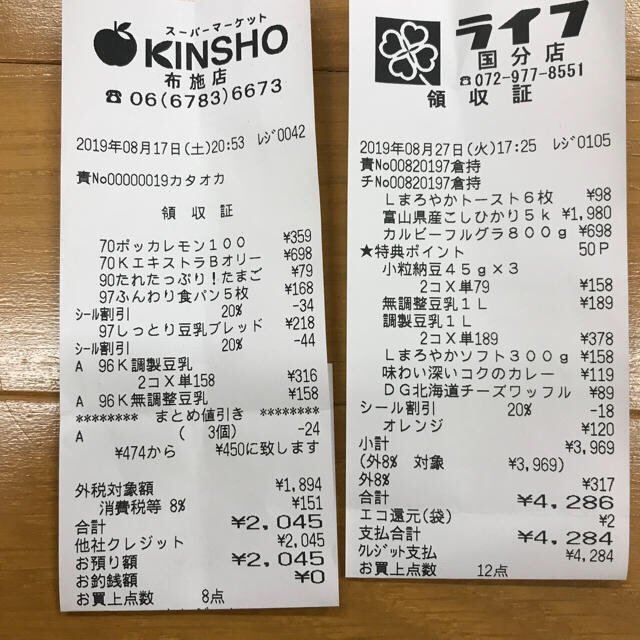
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
一个“经过核验的值”实际带着什么
站得住脚的结果,不是一个数值外加一个分数。POST /ocr/fields 把答案拆成若干层,每一层都能单独存储、查询和引用:
data.values——读到了什么。就是你请求的那套结构,不掺任何保留键,可以直接写进数据库。data.cells[path].box与.quad——从哪里读到的。box是轴对齐矩形{ xmin, ymin, xmax, ymax },位于一张 0–1000 归一化网格上(0,0 = 左上角,1000,1000 = 右下角);quad是四个有序顶点,由于系统从不做倾斜校正,它会一路跟着页面的倾斜角度。路径语法全程统一:total、items[0].price。data.cells[path].evidence——凭什么这样认定。text_match就是逐字符比对本身,source说明坐标是怎么定下来的,match_ratio是这个值的字符里在页面上被定位到的比例(≥ 0.85 视为已可信匹配),printed_text则是 OCR 在那组坐标上读到的字形,可用来与values做精确字符串比对。data.cells[path].verified与.review——能不能不经人工直接采纳。verified是一个判定,而不是字符分数:只要review带着任何理由就是false;跑过检查且没有任何标记时是true;没有任何标记、但压根没有可比对的对象时则是null——比如整行的合并框只有几何信息。review.reasons始终是数组,按排序给出,第 0 项是主要理由。data.review.flagged——留给人看的清单。每一项都是一对{ path, reasons },要复核的条数就是flagged.length。data.normalized——把页面上的写法和用来计算的值分开。只有当某个字段声明了标量类型(或带pattern/enum的 string)时才会出现,它把同一份读数解析成该类型,同时完全不改动values。
因为定位和证据是跟着值一起走的,结果就不再是个黑盒。你可以把方框画出来、引用路径和坐标,或者重新核查一个被标记的字段,全程都不必重新跑一遍 OCR。
这些坐标可不是模型说了算。 语言模型只返回每个值的文本——以及它用了哪些词元(word token)的提示——但从不返回方框本身。随后引擎会把这段文本与视觉 OCR 在页面上实际检测到的符号逐字符匹配,于是方框落在这些字符真正被找到的像素上,每个值也随之得到一个匹配率:它的字符里实际被定位到的那一份比例。模型给的词元提示可能带噪声——它有时会在重复的行之间把提示弄混——因此系统用列一致性和行一致性检查去验证这些提示,而不是盲目信任。重点不在于 AI 不会出错;而在于与页面对不上的值会被摆到复核清单上,而不是悄悄放行。遇到根本没有比对对象的项——整行的合并框只有几何信息——单元格会如实给出 verified: null,而不是谎称通过。
点一下值,就落到对应像素上
在应用里,这变成了一种交互:点击任意单元格,原图就会高亮出这个值所来自的那个方框,配上放大的局部裁切和一条连接线。这是抽查一整批结果最快的方式——你的目光直奔那个位置,而不用把整份文档从头扫一遍。
人工修改也同样可审计
审计追溯不只关乎机器的输出——它还关乎人改了什么。当你编辑一个单元格时,space-ocr 会把你的修改与原始 OCR 值分开存储。一个原始值(Original)提示框始终显示引擎最初读到的内容,这样审核者就能把机器值和人工覆盖值并排对照着看。
这就在 API 里,覆盖每一个值
这不是一个只在 UI 上才有的功能。POST /ocr/fields 返回的 data.cells 是一张以路径为键的扁平映射(total、items[0].price),每一项都带着 box、quad、verified、review 和 evidence。data.review.flagged[].path 用的是同一套路径语法,所以从一条待复核记录可以直接查到它自己的坐标。当你用 GET /view 查询一张已存储的表时,这张映射默认会一并返回——加上 boxes=0 只会去掉行里的 cells 映射,values、review 和 image 照旧返回。
{
  "status": "success",
  "data": {
    "values": {
      "total": "2,045",
      "items": [
        { "qty": "2", "price": "780" }
      ]
    },
    "cells": {
      "total": {
        "box": { "xmin": 595, "ymin": 974, "xmax": 781, "ymax": 1000 },
        "quad": [
          { "x": 594, "y": 975 }, { "x": 781, "y": 972 },
          { "x": 781, "y": 998 }, { "x": 595, "y": 1000 }
        ],
        "verified": true,
        "review": null,
        "evidence": {
          "text_match": true,
          "source": "vision_symbol_match",
          "match_ratio": 1.0,
          "printed_text": "2,045"
        }
      },
      "items[0].price": {
        "box": { "xmin": 693, "ymin": 640, "xmax": 781, "ymax": 668 },
        "quad": [
          { "x": 693, "y": 641 }, { "x": 781, "y": 640 },
          { "x": 781, "y": 667 }, { "x": 693, "y": 668 }
        ],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": {
          "text_match": false,
          "source": "vision_symbol_match",
          "match_ratio": 0.67,
          "printed_text": "180"
        }
      }
    },
    "review": {
      "unit": "field",
      "flagged": [
        { "path": "items[0].price", "reasons": ["text_mismatch"] }
      ],
      "by_reason": { "text_mismatch": 1 }
    },
    "normalized": { "total": 2045 },
    "image": { "width": 1654, "height": 2339 }
  }
}
evidence.source 告诉你每个坐标是怎么定下来的——vision_symbol_match 是常规的逐字符匹配路径(携带它真实的 match_ratio),token_id 表示用到了某个词元提示。这是一份你可以记录、过滤,或呈现给审核者看的元数据。弱匹配并不会藏在这个键里:它会以 low_ratio、weak_source、low_ocr_confidence 这类代码出现在 review.reasons 中,同一条路径也会出现在 data.review.flagged 里。这些理由代码属于 API 契约词汇——请按代码分支处理,并为暂时还不认识的代码留一条通用提示。
实际操作中如何核验一个值
- 打开提取结果打开表格,或调用 GET /view——每个值都由一条路径寻址,data.cells[path] 带着它的 box、quad、review 和 evidence。
- 点击该值点击单元格,高亮出它在原图上被读取的确切区域。
- 查看证据与复核清单match_ratio 为 1.0 表示每个字符都被定位到了,≥ 0.85 即视为已可信匹配。引擎无法定论的值,会连同 low_ratio、text_mismatch 之类的理由一起出现在 data.review.flagged 里。
- 需要时进行修正编辑单元格以覆盖它——为留下审计追溯,原始 OCR 值会被保留在 Original 提示框里。