同样的文档,同样的模式,不同的答案: space-ocr vs Mistral
8个用例、7份文档、463个字段、每个引擎3轮的受控基准测试:字段读取率、多轮稳定性,以及分数表看不到的坐标差距。
space-ocr 是我们做的文档识别 API。你发一张照片和一份想要取出的字段清单,它把这些值作为数据返回,每个值都带着它在页面上被读取的具体位置。这篇文章是把它和 Mistral Document AI 放在一起,用真正难处理的文档跑出来的记录。
每家 OCR 厂商的演示都能把干净的印刷发票读得完美,我们的也一样,而这对你要做的决定没有任何帮助。真正有用的问题有三个:遇到麻烦的文档会怎样;同一页跑两次答案会不会变;以及在不逐个复核的前提下怎么找出读错的值。这三点我们都测了,下面把过程和数字全放出来,包括对我们不利的那些。
我们跑了什么
计分用例 8 个,共 463 个值,来自 7 张照片:3 张日文送货单、一张商品名在上一行而数量与单价在下一行的超市小票、一份通过聊天消息发来的 24 行订单、一份佣金明细,以及一张对着显示器拍下的 22 行批发行情表。它们都是我们自己回归测试里的照片,也就是我们弄坏东西时用来报警的那一套。
照片 7 张而用例 8 个,是因为其中两个用例是同一张聊天订单照片、同一份标准答案。它们在测试里被分开管理,用来走不同的内部路径;对两个引擎来说,只是同一张图片收到了两次。因此这一张照片占了 463 个值中的 144 个,读数字时请把这一点算进去。
三条测试线,收到的图片、字段清单(名称与说明完全一致)以及"照印出来的原样抄"这条指令都相同。
| 测试线 | 调用的是什么 | 字段怎么给的 |
|---|---|---|
| space-ocr | 生产环境 POST /ocr/fields | 带名称和说明的字段清单 |
| Mistral OCR | mistral-ocr-latest,/v1/ocr 加 document_annotation | 同一份清单,作为 strict JSON schema |
| Mistral 视觉 LLM | mistral-medium-latest,聊天里附图 | 同一份清单,response_format: json_schema,temperature 0 |
每份文档每条线跑 3 次,共 72 次,原始响应全部存档。评分是三条线共用的一个脚本:去掉空白后与手写标准答案完全一致才算对。2026 年 8 月。
结果,以及必须一起看的说明
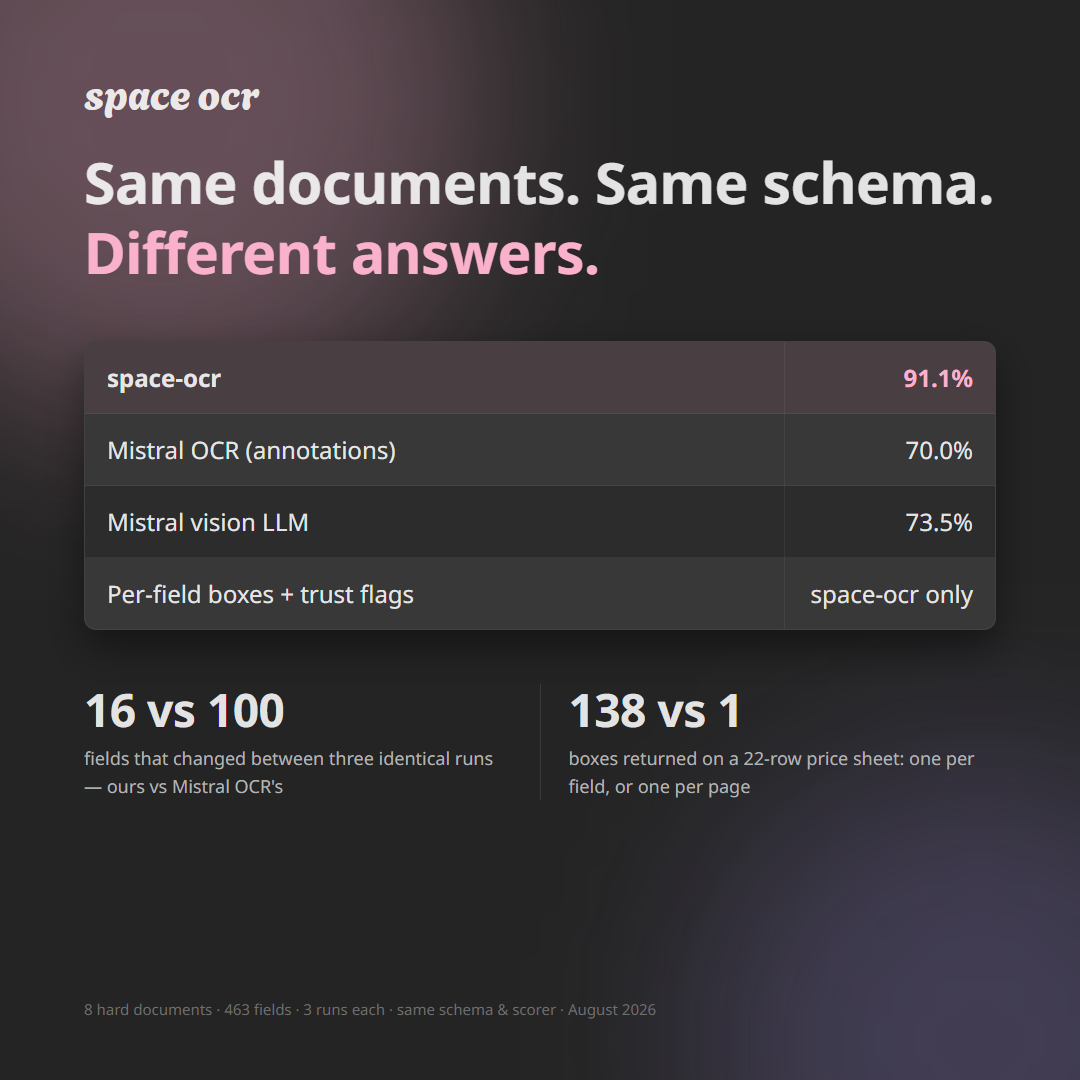
space-ocr 把 463 个值中的 91.1% 读成完全一致(3 次平均)。Mistral 的 OCR 标注是 70.0%,视觉 LLM 是 73.5%。
任何引擎的错项里都有一部分只是格式问题:留了货币符号,或者数字后面带了单位。所以我们又把只差分隔符或空格的不一致全部剔除,只数内容错误:每次 space-ocr 约 23 个,Mistral OCR 119 个,视觉 LLM 93 个。差距依然在。
看数字之前还有一点。标准答案是按我们自己流水线关于"一个值到哪里结束"的习惯抄写的,所以包括我们在内的每个在线引擎都会因为边界理解不同而丢分。该读的是各条线之间的差距,绝对分数是下限,不是成绩。
每份文档,每个分数
3 次平均,答对的值数 / 总数。
| 文档 | 值 | space-ocr | Mistral OCR | Mistral VLM |
|---|---|---|---|---|
| 行情表 22 行,对着显示器拍摄 | 141 | 139.0 (98.6%) | 139.0 (98.6%) | 133.7 (94.8%) |
| 佣金明细 | 44 | 42.7 (97.0%) | 39.0 (88.6%) | 34.7 (78.8%) |
| 送货单 C | 53 | 50.3 (95.0%) | 43.7 (82.4%) | 47.3 (89.3%) |
| 送货单 B | 37 | 34.3 (92.8%) | 18.0 (48.6%) | 24.3 (65.8%) |
| 两行式超市小票 | 13 | 12.0 (92.3%) | 2.3 (17.9%) | 1.3 (10.3%) |
| 聊天订单 24 行(2 个之 2) | 72 | 61.0 (84.7%) | 21.3 (29.6%) | 41.7 (57.9%) |
| 聊天订单 24 行(2 个之 1) | 72 | 58.0 (80.6%) | 39.7 (55.1%) | 42.3 (58.8%) |
| 送货单 A | 31 | 24.7 (79.6%) | 21.0 (67.7%) | 15.0 (48.4%) |
| 合计 | 463 | 422.0 (91.1%) | 324.0 (70.0%) | 340.3 (73.5%) |
先看第一行。在这套里最干净的那份文档、密密麻麻 141 个值的印刷表格上,Mistral OCR 和我们打成平手。认字并不是这些引擎拉开差距的地方,任何遮住这一点的比较都是在卖东西给你。
拉开差距的是表格下半部分,方向也一致:版面越别扭,差距越大。另外请看聊天订单那两行。同一张照片、同一份答案、同一套 schema 发了两次,我们两次相差 3 个值,Mistral OCR 相差 18 个。
同一页跑三次
满分 463,每次的总分。
| 测试线 | 第 1 次 | 第 2 次 | 第 3 次 | 波动 |
|---|---|---|---|---|
| space-ocr | 430 | 414 | 422 | 16 |
| Mistral OCR | 322 | 275 | 375 | 100 |
| Mistral 视觉 LLM | 360 | 329 | 332 | 31 |
100 个值的波动不是均值附近的噪声,而基本上是两个不同的产品。Mistral OCR 有一次在一小时前拿到 72 分之 58 的文档上只返回了 72 分之 3,因为标注层把一张 43 行表格的每一列都打乱了。而响应里没有任何东西能把这一次和好的那一次区分开。
错的时候,究竟是怎么错的
这是差距最大的两行式小票,第 1 次。这张小票把商品名印在一行,数量和单价印在下一行,合计区块紧贴在同一列的下方。
| 值 | 页面上印的 | space-ocr | Mistral OCR |
|---|---|---|---|
| 第 1 项商品名 | ポッカサッポロ果実の | 正确 | 006142 ポッカサッポロ 果実の |
| 第 1 项数量 | 12 | 正确 | 12コ |
| 第 1 项单价 | 98 | 正确 | 単98 ¥1,176 |
| 第 2 项商品名 | 塩パン | 正确 | 011102 塩パン |
| 日期 | 2017年07月30日(日) | 正确 | 2017年07月30日(日) No.2805 |
| 合计 | 1,451 | ¥1,451 | ¥1,451 |
先看最后一行。合计上两个引擎给出了同样的答案,而且都被判错,因为标准答案里没有货币符号。这类错误会把包括我们在内的所有引擎的错误数撑大,这也是上面"只算内容错误"的数字比原始数字更有用的原因。
其余几行则是另一回事。Mistral 在那里并没有认错字,它是把货架编码粘到了商品名上、把价格粘到了数量那一行,因为它始终没弄明白印出来的两行其实是一条记录。
24 行聊天订单的失败值得整段看完,因为这是下游代价最高的一种失败。
| 行 | 印的 | Mistral OCR 返回 |
|---|---|---|
| 第 1 行 备注 | ヒチョウ | (空) |
| 第 2 行 品名 | クエ | ヒチョウ |
| 第 2 行 备注 | 頭落とし | 背 |
| 第 3 行 品名 | ブリ | クエ |
| 第 3 行 备注 | サクラブリ | (空) |
每一行都往上错位了一格。单看每个值,都是页面上真实存在、拼写正确的字符串;当成表格看,从第二行起全错,而响应的样子毫无异常。
同一页上我们也有错,只是规模小些:ヒチョウ 读成 ヒチョウ背,冷凍 读成 冷凍 2L,是把相邻单元格并进来了,而不是整表错位。在送货单 B 上,我们把单价 1510 读成 510,漏掉了从旁边一列粘过来的那一位。
分数表显示不出来的东西
在行情表上向两个引擎要同样的 141 个值,返回的两份答案看起来一样能用,直到你问每个值从哪里来。
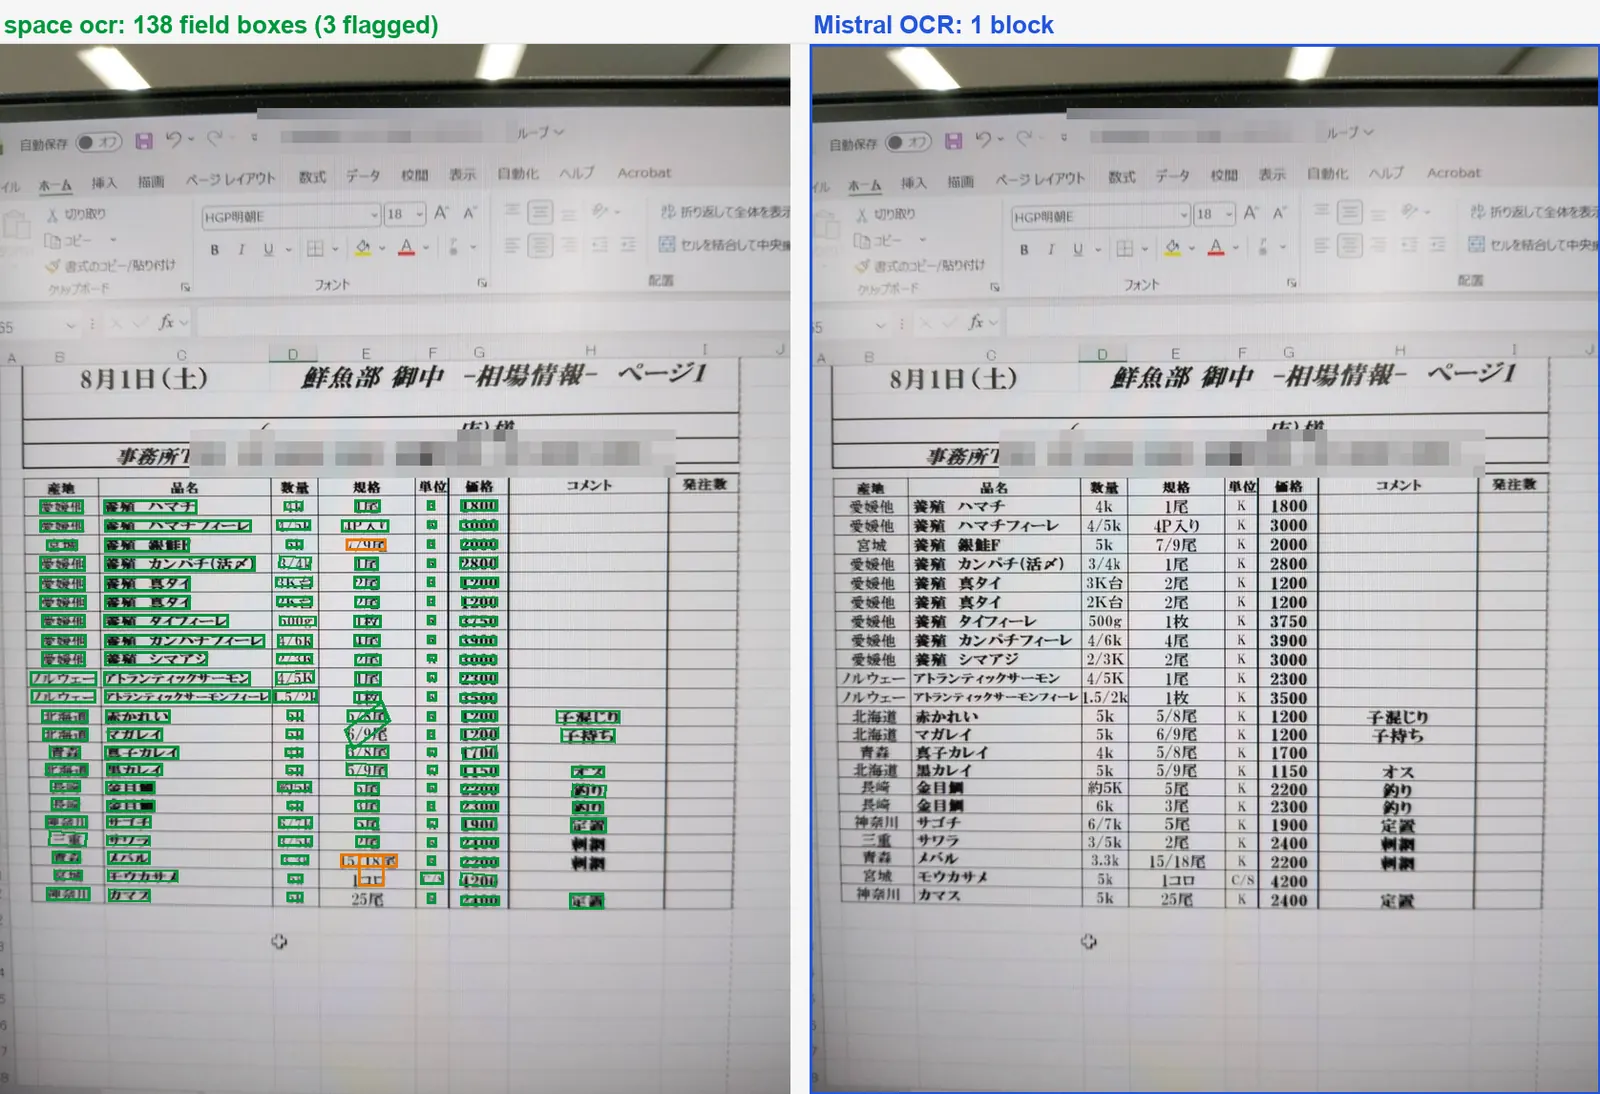
space-ocr 为每个值返回一个方框,方框贴在这个值被读取的真实像素上。在我们为这次基准测试存档的 Mistral 响应里(mistral-ocr-latest,2026 年 8 月),同一张行情表返回的是覆盖整张表的一个矩形。那批响应里没有值一级的坐标,我们看到的最细粒度就是段落块。至于它现在返回什么,动手设计之前请对照 Mistral 的最新文档确认。
那批响应里也没有校验信号。space-ocr 的每个值都装在 data.cells[path] 里返回:0 到 1000 网格上的 box 与 quad、作为判定的 verified、用机器可读代码列出哪里没通过的 review.reasons,以及装着字符比对本身(text_match)、其依据 match_ratio、识别端能给出时的 ocr_confidence 的 evidence。需要人看的值集中在 data.review.flagged 一处。同一个值在页面上重复出现时,字段声明里的 label 决定取哪一次出现。verified: true 请照字面读:跑过的检查没发现问题,而不是保证这个值就是你要的那个。
这才是真正改变工作方式的地方。有方框和复核清单,悄悄读错的值会被摆到台面上,人可以从被标出的那几个开始,而不是把 141 个重看一遍。它不是一张能捞起一切的网:两次读法给出同样答案的值,比对就没有东西可立,上面那行合计正是这个样子。但带标记的错值只花你一眼,没有标记的错值花的是你在它上面搭起来的全部。
整套文档,两个引擎
7 张照片全在这里。左右是同一张图,方框直接取自基准测试第 1 次运行的存档响应。绿色是 space-ocr 的一个值,橙色是那次运行里引擎标记为需要复核的值,蓝色是 Mistral OCR 的一个块。第三方的商号、地址、电话、账号和经办人姓名在发布前都做了马赛克,所以有些方框压在灰色矩形上。
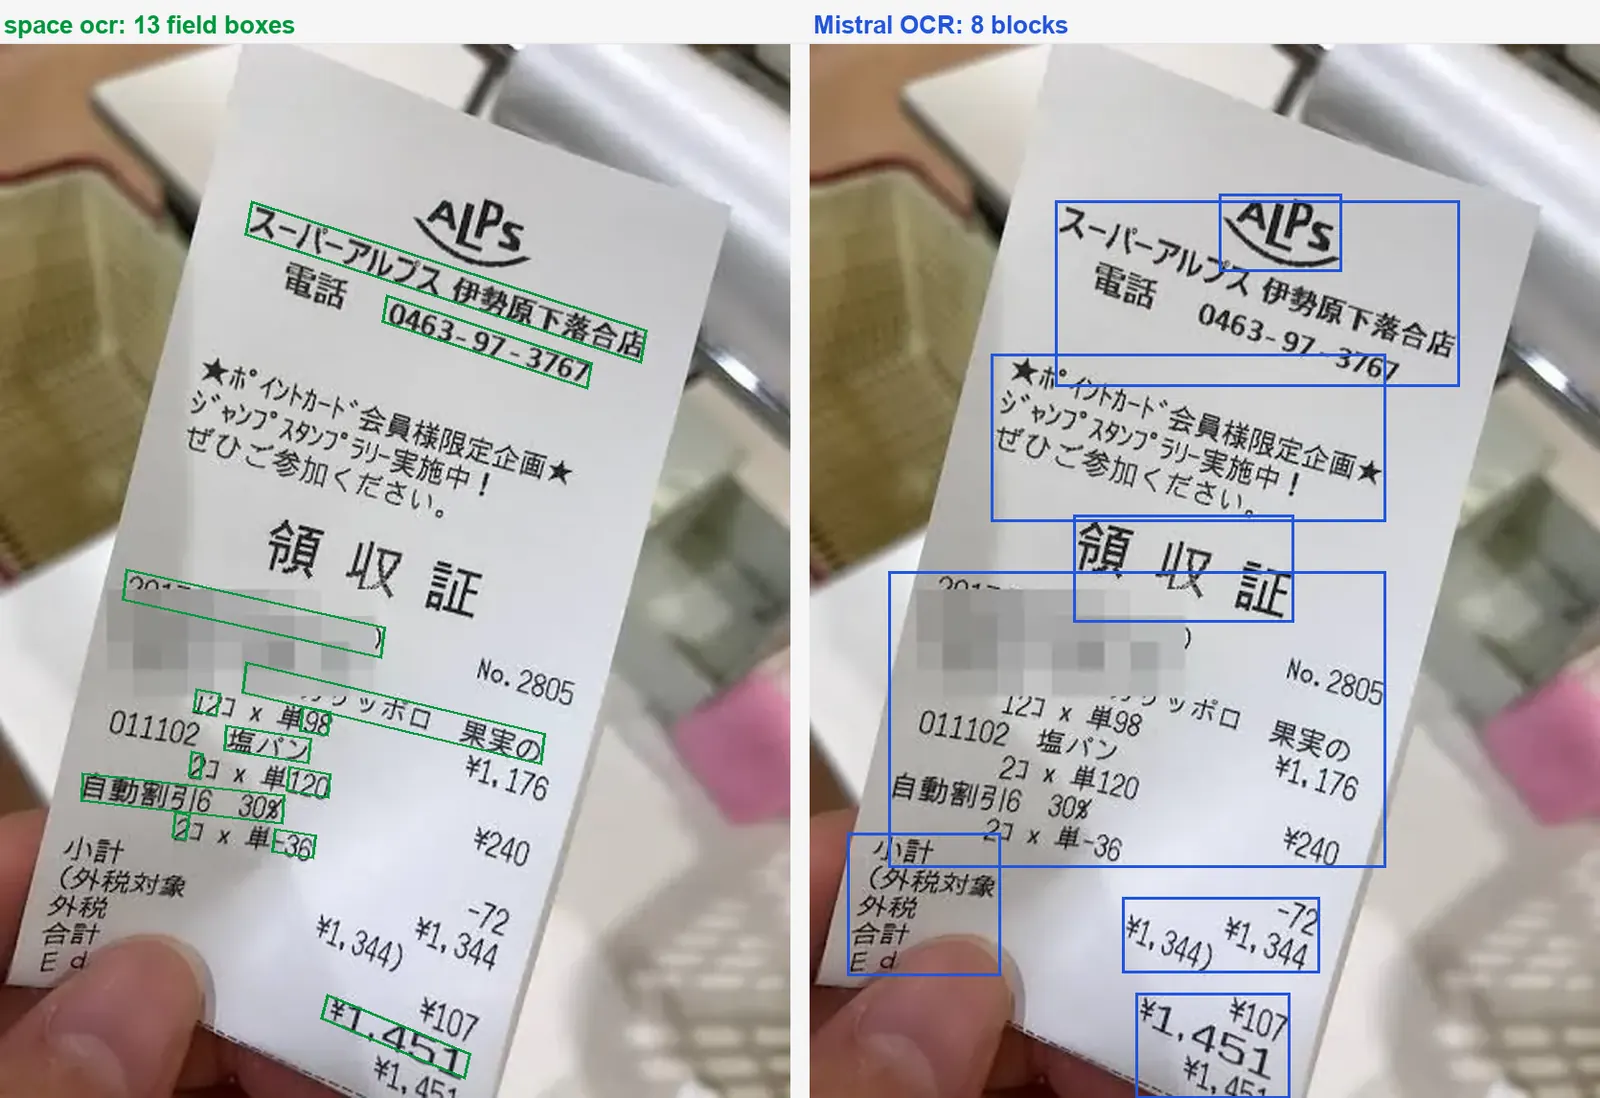
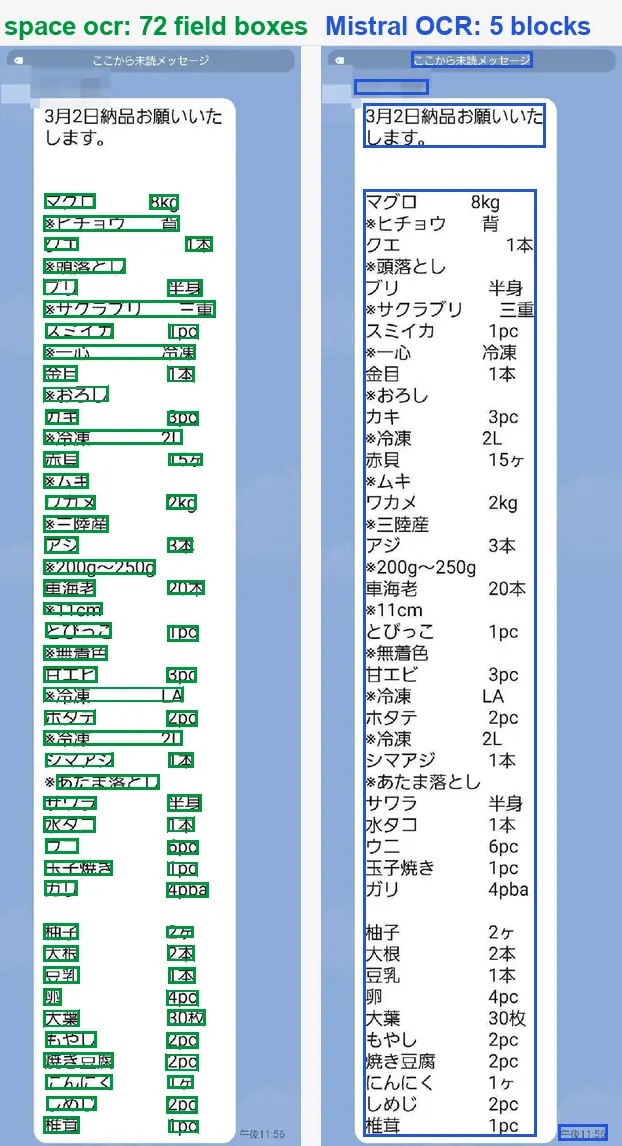
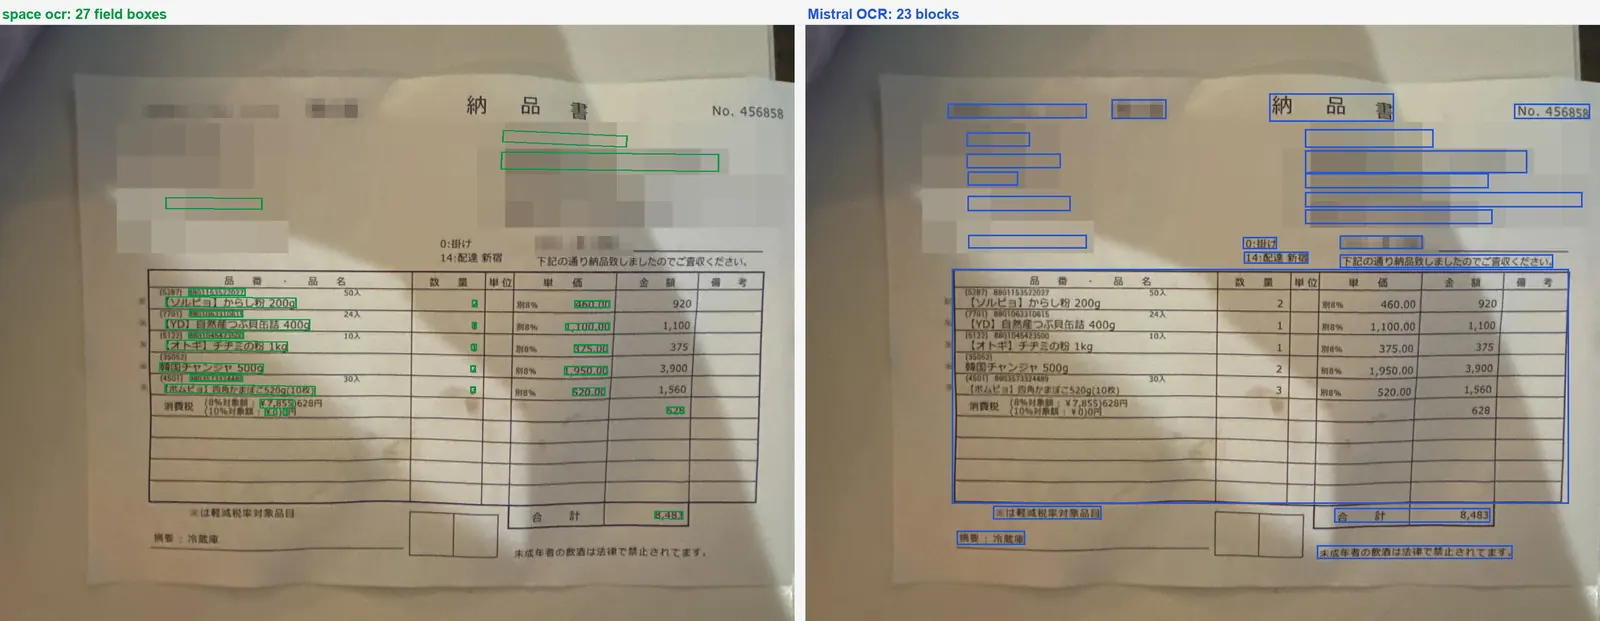
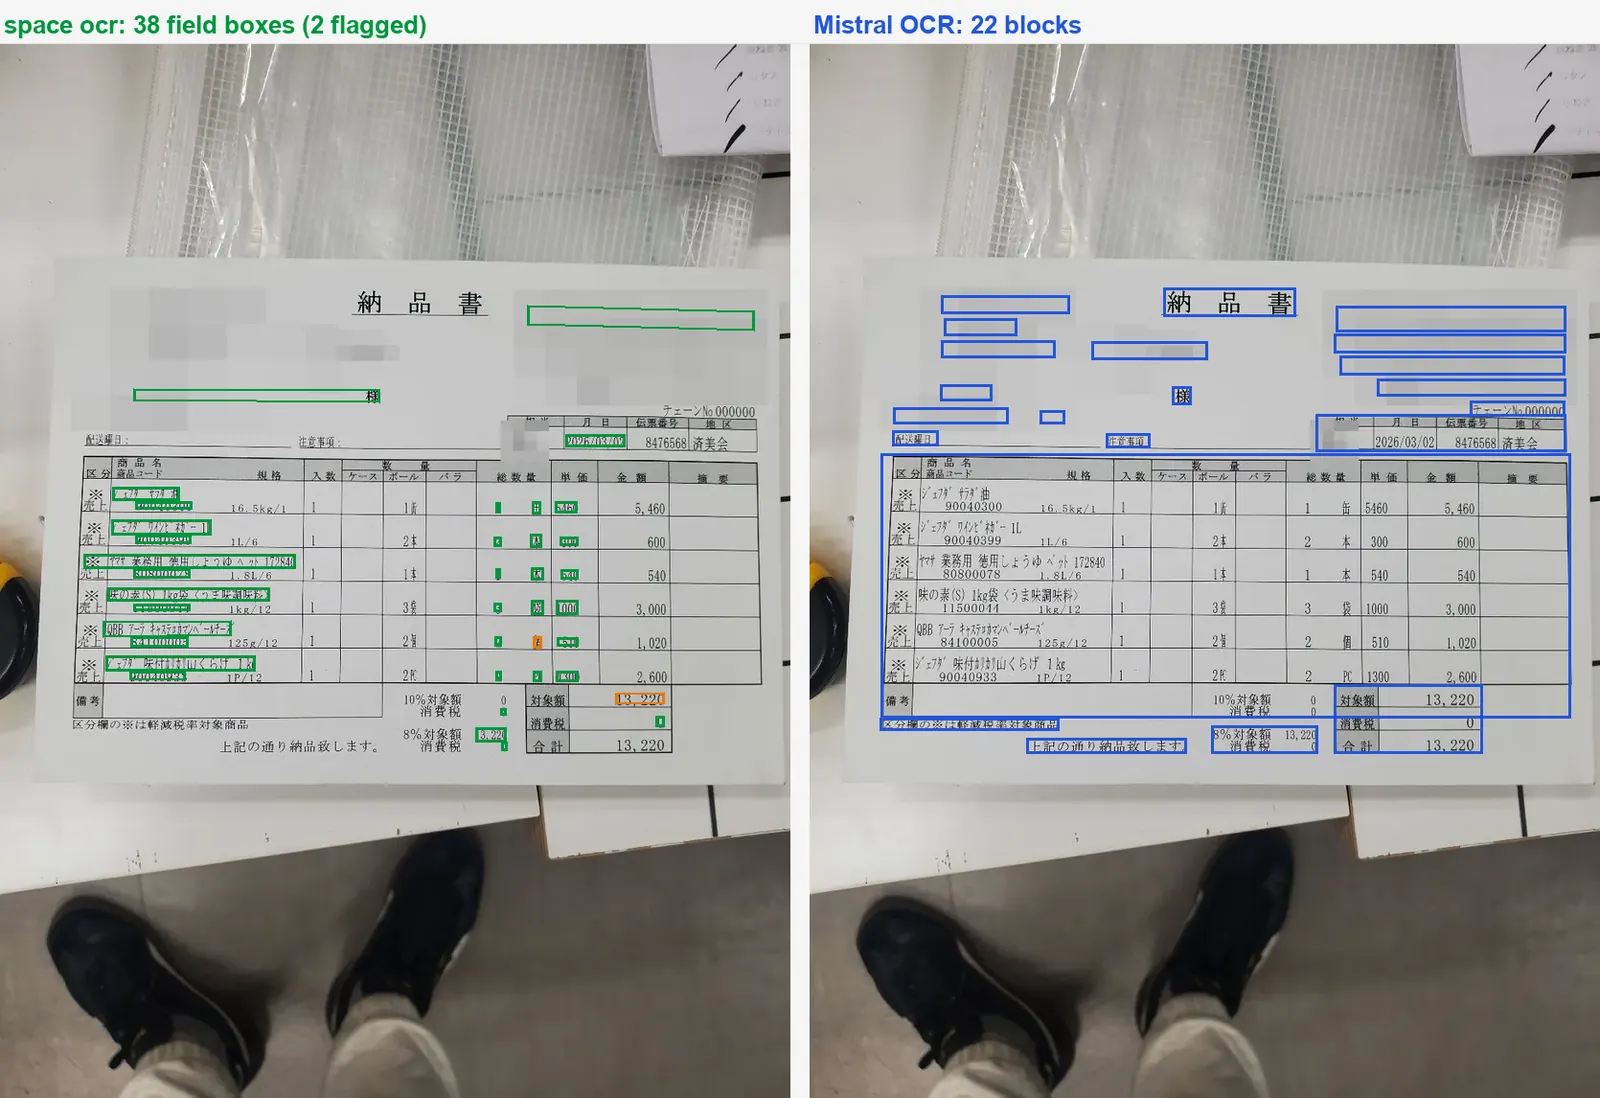
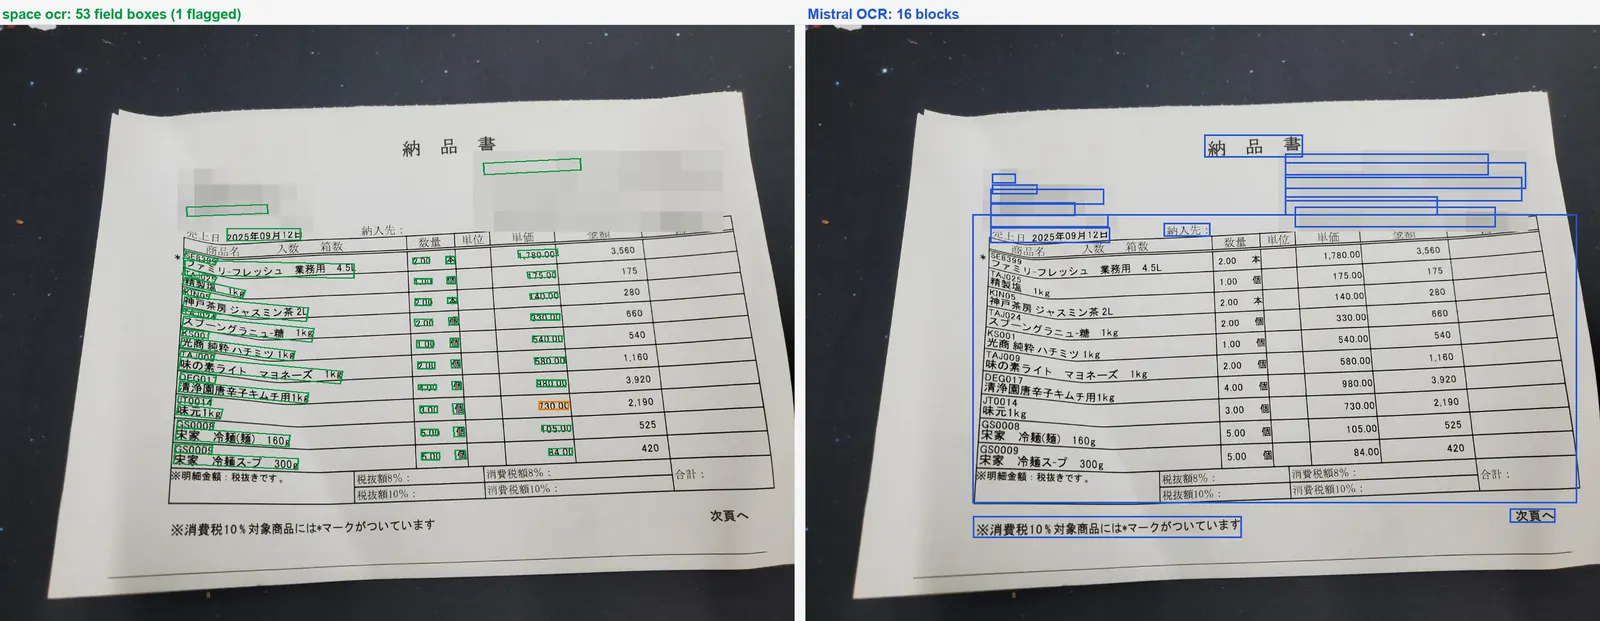
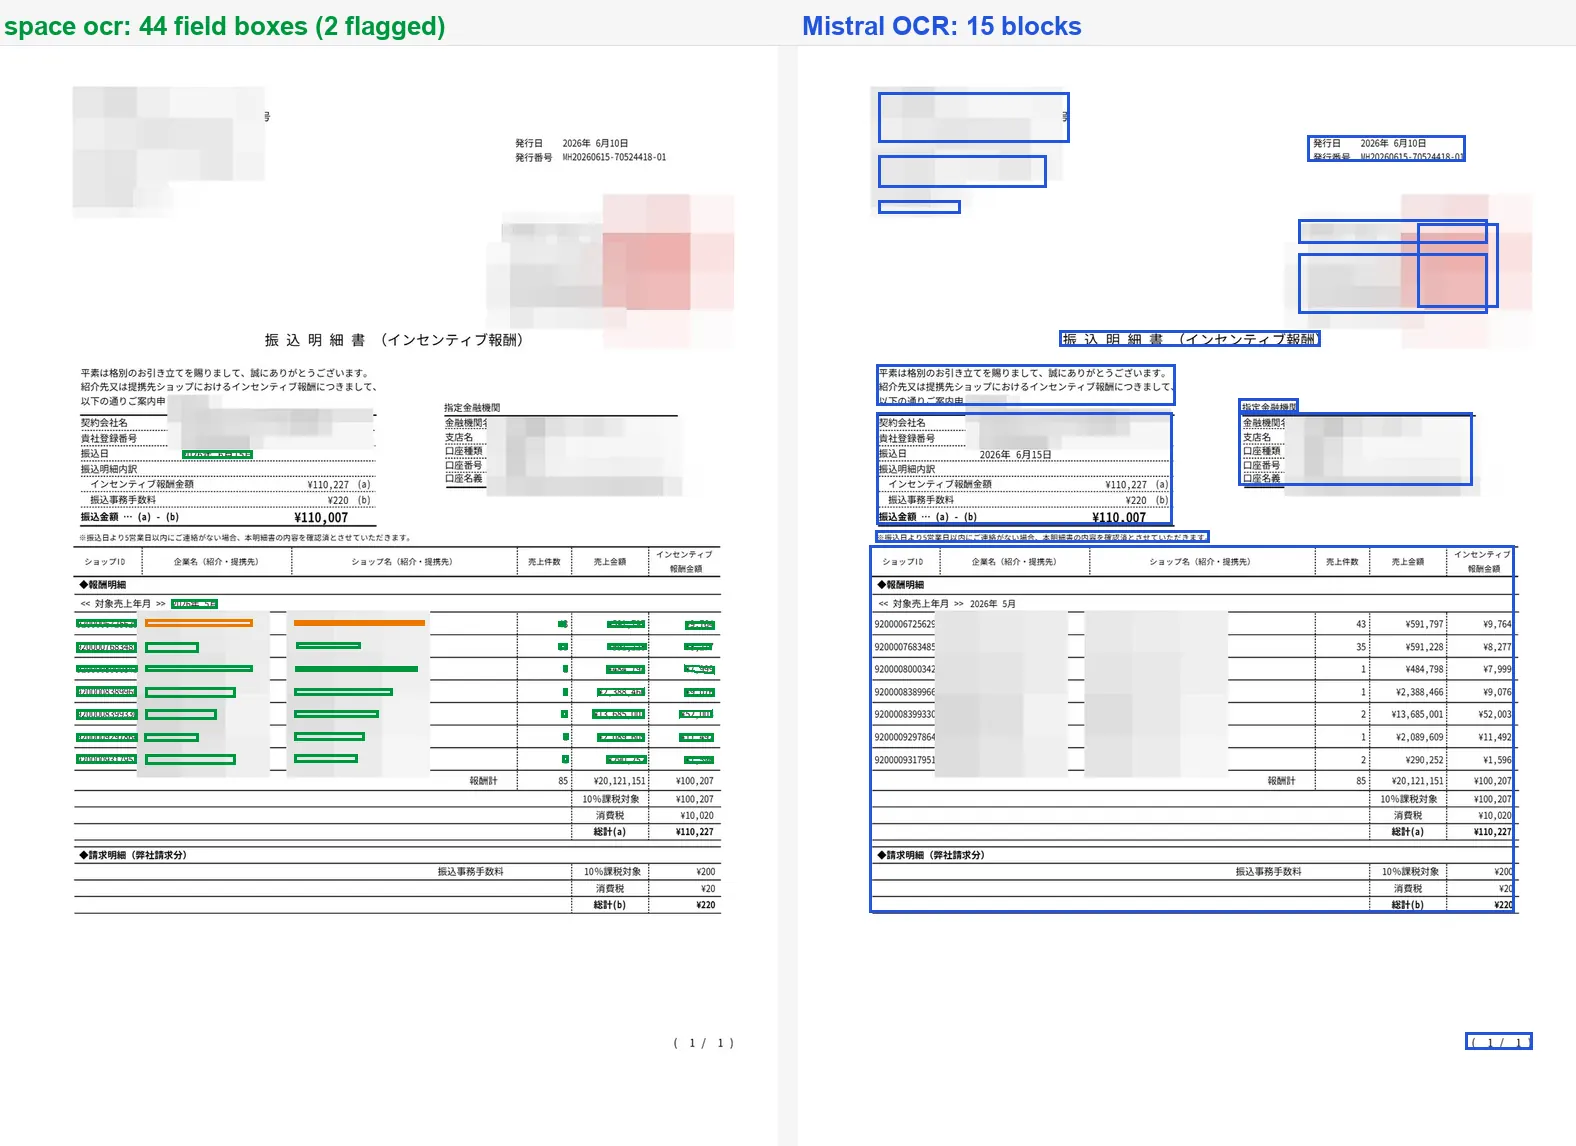
校验是怎么运作的,其实就是这篇文章的全部论点:语言模型只返回值和词级提示,从不生成坐标。引擎再把每个返回值与页面上实际检测到的字符逐字比对,把方框落在那些字符上,并用 evidence.match_ratio 给匹配打分(0.85 及以上算可信匹配)。这个比值是支撑判定的证据之一,本身不是闸门:两次读法不一致时,review.reasons 会记下 text_mismatch 之类的原因代码,verified 变成 false,该值进入需要查看的清单 data.review.flagged。坐标按值返回:box 是 0 到 1000 网格上的 xmin/ymin/xmax/ymax,quad 是四个有序顶点,用于倾斜的页面。
这篇文章没有测的东西
测的是 2026 年 8 月、8 个用例上的字段抽取。没测速度,没测价格,也没测 Mistral 的 markdown 转换——那是做另一件事的另一个产品,本次任何一次运行都没有涉及。这也不是关于文档识别的一般结论:来自一家公司回归集的 8 个用例是个小样本,而且是故意挑刁钻的,偏向日文商务表单和光线不好的照片。
原始材料全部保留:运行脚本、评分过的 72 次运行、两家厂商的原始响应,以及画出上面这些图的脚本。
不过最有用的基准仍然是你自己的。挑 5 份平时让你头疼的文档,先手写标准答案,把同一份字段清单发给两个 API,各跑三次。下面的步骤就是我们的做法。一次成功扫描 $0.05,失败不计费,每月前 100 页免费,所以自己验证一遍几乎不花钱。
- 挑难啃的文档,不要演示样张选5到10页真正折磨人的:多行记录、重复的值、拍屏照片、密集表格。干净的样张分不出厂商高下。
- 固定一套模式和指令字段清单只写一次,用同样的名称和描述原样发给每个引擎。要求按印刷原样返回值。
- 先手写标准答案在跑任何东西之前,把每个字段的期望值抄下来,之后不再修改。
- 每个引擎至少跑3轮只跑一轮会掩盖不稳定。所有轮次用同一个脚本评分,看波动而不是只看平均。
- 单独统计无声的错误每个错误值都记下引擎是否给了标记。带标记的错值只花你一眼,没有信号的错值花的是你在它上面搭的整个流程。