2026 年实战:用边界框搭建结构化字段 OCR API
2026 年结构化字段 OCR API 实战指南:用边界框实现可核验、可审计的文档数据管道。
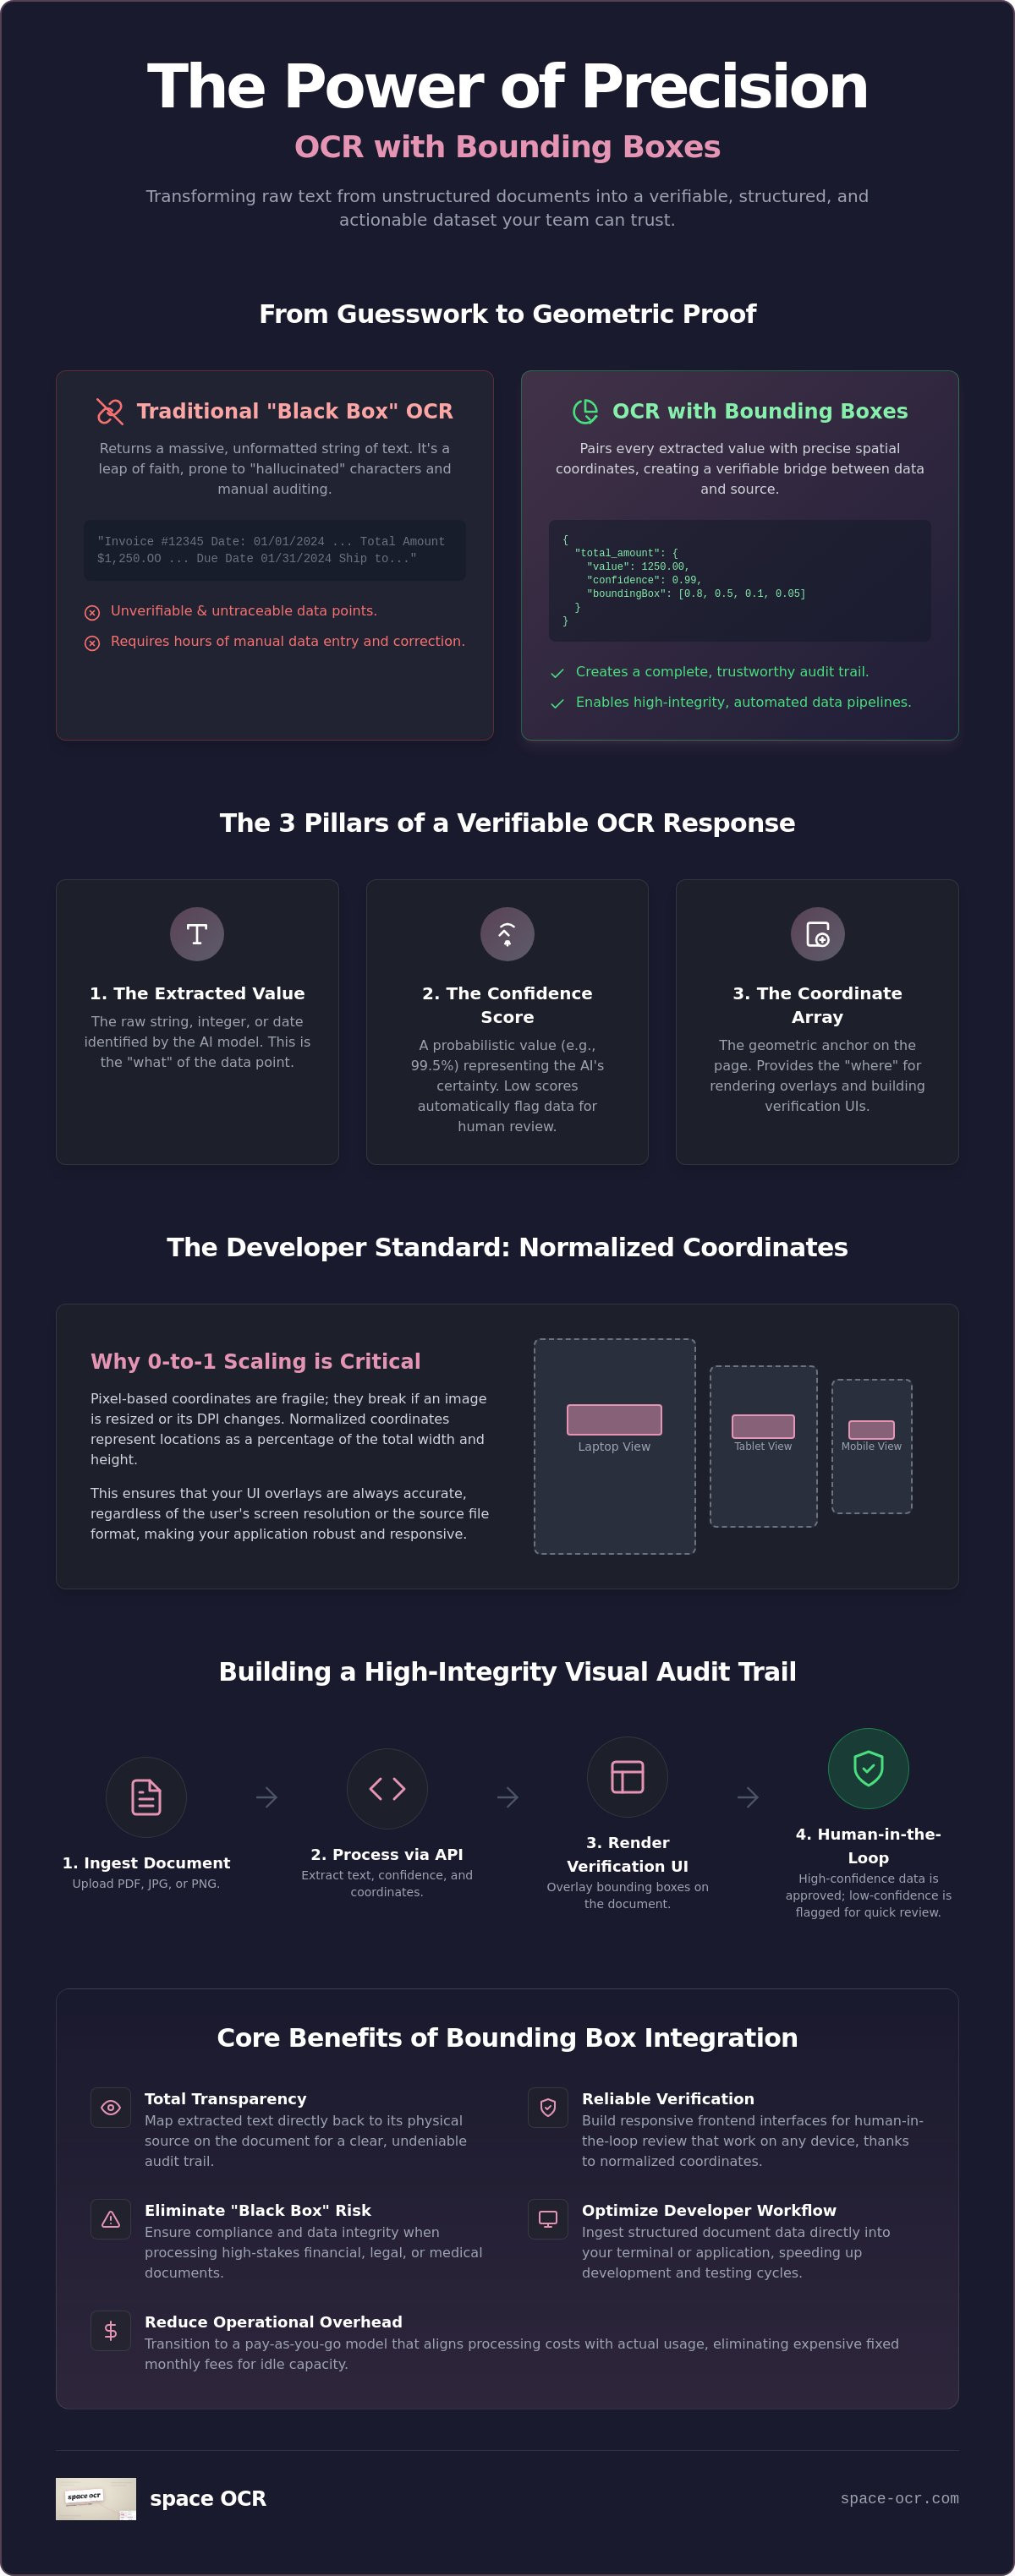
一串没有坐标的文本,只是一次猜测,算不上一个数据点。如果你曾花好几个小时人工核查某个黑盒提取器"凭空捏造"出来的字符,你就会明白:对生产级自动化来说,光有纯文本远远不够。你得能确切看到数据到底来自哪里。接入一个带边界框的现代 OCR API,能把你的工作流从"闭眼相信"变成一条可核验的审计轨迹。这也是摆脱固定订阅费用、告别僵化又无法伸缩的处理模式的技术基础。
你会看到如何用这些空间坐标,搭建高可信、结构化的数据管道,支撑可靠的人在环(human-in-the-loop)核验。我们会走一遍把 JSON 输出直接映射到文档区域的机制,以及如何搭建一套能随实际工作量伸缩的系统。这份指南会拆解结构化字段提取、2026 年向视觉语言模型的转向,以及把人工录入压缩到"只需复核"所需的逻辑。读完之后,你会拿到一份蓝图,把非结构化文档变成团队真正信得过、可直接落地的精确数据集。
要点速览
- 了解带边界框的 OCR API 如何用精确的空间坐标,把提取出的文本直接映射回它在文档上的物理来源,做到完全透明。
- 理解为什么一套归一化的 0–1000 坐标网格,能让前端核验叠加层在不同屏幕尺寸和图像 DPI 下保持稳定。
- 落地可视化审计轨迹,消除"黑盒"风险,让高风险的财务或法务文档处理始终可审计。
- 借助 Claude Code 插件直接从终端调用 REST API——两行命令装好一个零依赖的 Python 客户端。
- 转向按量付费模式,让成本对齐实际处理量,而不是固定月费,从而削减运营开销。
目录
什么是带边界框的 OCR API?
一个标准的光学字符识别(OCR)引擎,通常会返回一大段没有格式的文本字符串。这对简单的搜索索引没问题,但在自动化数据管道里就行不通了。带边界框的 OCR API 是一种专门的接口,它给每一个提取出的字段都配上它在文档上的精确空间位置。通过为每个值返回坐标——归一化 0–1000 网格上一个由 xmin、ymin、xmax、ymax 组成的整数框——这个 API 在数字数据与物理来源之间架起了一座桥。你拿到的不只是一个像 "$1,250.00" 这样的值,还有这个值在页面上的确切位置。
这个区别对结构化提取至关重要。传统 OCR 把文档当成一个扁平的文本文件,而结构化 OCR 把它当成一组数据对象。到了 2026 年,行业已经从"倒出纯文本"转向了可核验的数据结构。如果你的系统提取了一个税号,你需要能在核验界面里以编程方式高亮出那个字段。没有边界框,除了把整页重读一遍,你根本没办法审计模型的工作。在高风险的工作流里,一串没有坐标的文本就是一份负债。
边界框 vs. 边界区域
大多数实现依赖标准的四点矩形。这类边界框计算开销很低,对数字原生的页面或干净扫描的表单效果不错。但现实中的文档常常是歪的、转过角度的,或者有褶皱。对这些情况,单纯一个与坐标轴对齐的框就不够了。space-ocr 会同时返回一个与坐标轴对齐的 box(整数的 xmin/ymin/xmax/ymax)和一个四点定向的 quad——顶点按左上、右上、右下、左下排列——它会跟随文档的倾斜。这样对变形或旋转的版面,你能拿到普通矩形给不了的精度,同时其余场景仍可以用那个简单的框。
现代 OCR 响应的关键组成
POST /ocr/fields 返回的 data 由四层组成。每一层回答的问题不同,其中只有一层可以原样写进数据库,所以值得分开来看:
data.values—— 业务数据本身,形状与你声明的 schema 完全一致,不掺任何保留键,可以原样保存。但它不是印刷内容的逐字节副本,而是模型对页面的读取结果;需要精确字符串比对时,请用cells[path].evidence.printed_text,也就是 OCR 环节在那组坐标上读到的字符。data.cells[path]—— 以 path 为键,逐个记录每个值来自哪里、各项检查得出了什么结论,比如total、items[0].amount。每个条目都带着box(整数的xmin/ymin/xmax/ymax)和四点quad、判定verified、取值为null或{ reasons }的review,以及作为依据的evidence(text_match、source、match_ratio、ocr_confidence、printed_text)。data.review—— 整页文档的汇总,其中flagged是一份机器可读的待复核清单,形如[{ path, reasons }],path 的写法与cells的键完全相同。需要复核的条数就是flagged.length,没有另外的计数器。by_reason会统计每个被标记字段上的所有理由,所以它的总和可能大于条数。data.normalized—— 确定性的类型化读数,只在某个字段声明了标量类型(number、integer、date)或带pattern、enum的string时才出现。它是一棵与values形状完全相同的稀疏树,normalized.total就挨着values.total。解析是确定性的,不额外调用模型;解析不了的叶子返回null,原因写在cells[path].normalized.error里。
这四层旁边还有 data.image(以像素为单位的 width 和 height),所有坐标都是以它为基准量出来的。
提取之所以透明,正是因为把这几层分开了。真正该拿来做闸门的不是一个需要你调的阈值,而是一个条件:某个单元格的 review 为 null,就说明跑过的检查全部通过——这也正是它的 verified: true 所说的事。match_ratio 并没有消失,它作为判定背后 evidence 里的一个信号仍然在,只是它本身不是判定。至于一个值应该来自页面的哪个位置,请求这一侧就能说:label 会把坐标锚定到指定标签旁边的那次出现,near / not_near 则声明值旁边必须(或不得)出现的词汇。正是这种控制力,把基础的字符识别和一个结构化字段 OCR API 区分开来。
技术架构:坐标、JSON 与置信度
搭建一条文档管道,需要的不只是字符检测,还需要对数据的空间理解。当你接入带边界框的 OCR API 时,最重要的架构决策就是如何处理坐标。原始像素坐标很脆弱。如果你的源图像在预处理中被缩放、重新编码或按 DPI 调整过,绝对像素值就没用了。这也是为什么 space-ocr 返回的坐标落在归一化的 0–1000 网格上,而不是像素上:(0,0) 是左上角,(1000,1000) 是右下角,与图像的实际像素尺寸无关。要画一个框,你把它按比例放大回去——pixel_x = xmin / 1000 * image_width——这样你的前端就能在任意分辨率下渲染叠加层,而不必重新计算底层几何。式子里的 image_width 取自 data.image,这一点值得说准确:data.image 描述的是实际被读取的那一页——EXIF 方向已经烘进像素之后(发 4000×3000 上去,可能拿回 3000×4000),以及服务端缩放之后的尺寸,而不是你发过去的那个文件。以 data.image 为准去画,框就对得上;用原文件的尺寸去画,旋转或缩放过的页面就会差出那一截。系统也不做倾斜校正,所以歪着拍的照片,它的 quad 会顺着倾斜走,而不是被扶正。
引擎和 API 处理的是栅格图像,而不是 PDF 字节。当你把一份多页 PDF 拖进 space-ocr 网页应用时,它会用 pdf.js 把每一页渲染成 PNG,再对这些页面图片跑 OCR;直接调 API 时,你每个请求发一张图片,需要先把 PDF 各页转成图像。每个坐标都对应它来源的那张页面图片——不存在需要拆解的按页码嵌套的载荷。为了把坏数据挡在数据库外,请对判定而不是对某个数值设闸门:单元格的 review 为 null(也就是 verified: true)意味着跑过的检查全部通过,而带理由的那些会连同理由一起列进 data.review.flagged。理由词汇是固定且有文档的(text_mismatch、low_ratio、weak_source、nobox、missing 等),所以队列可以按理由分流,而不是按分数。判定背后的依据落在 evidence 里:source(例如 vision_symbol_match)、ocr_confidence,以及 match_ratio——该值的字符中,有多少在 OCR 环节于页面上检测到的符号里被重新找到,范围 0.0 到 1.0。这个比例是相对页面的覆盖度,而不是模型的自我置信度分数;达到或超过 0.85 视为可信匹配,但它是判定的一项输入,而不是闸门本身。这样设闸门,既能阻止未核验的值进入数据库,又让高覆盖度的提取自动流转。
结构化 JSON 响应的构造
字段级提取把特定的键,比如发票号或税号,映射到精确的几何锚点。到了表格里的明细行,事情会更复杂一些:一个数组字段会展开成多行,每个单元格都在 data.cells 里按带下标的 path 拿到自己的条目,这样行与列之间的关系就保持完整。像 items[0] 这样的行 path 是整行的并集框,里面的一格则是 items[0].amount。这套写法和 review.flagged[].path 完全一致,所以被标记出来的 path 直接就是查 cells 的键。
下面是一份能同时看到四层的响应。请求里声明的是 invoice_no、date、items[] 和 total;cells 每个 path 一个条目,这里只保留了正在讨论的两个。
{
  "status": "success",
  "data": {
    "values": {
      "invoice_no": "",
      "date": "2025-04-10",
      "items": [
        { "name": "牛奶", "qty": "1", "amount": "$1.99" }
      ],
      "total": "$4.94"
    },
    "cells": {
      "items[0].amount": {
        "box": { "xmin": 693, "ymin": 460, "xmax": 738, "ymax": 488 },
        "quad": [{ "x": 693, "y": 460 }, { "x": 738, "y": 460 }, { "x": 738, "y": 488 }, { "x": 693, "y": 488 }],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": { "text_match": false, "source": "vision_symbol_match", "match_ratio": 0.62, "ocr_confidence": 0.88 }
      },
      "total": {
        "box": { "xmin": 380, "ymin": 720, "xmax": 530, "ymax": 742 },
        "quad": [{ "x": 380, "y": 720 }, { "x": 530, "y": 720 }, { "x": 530, "y": 742 }, { "x": 380, "y": 742 }],
        "verified": true,
        "review": null,
        "evidence": { "text_match": true, "source": "vision_symbol_match", "match_ratio": 1.0, "ocr_confidence": 0.98 },
        "normalized": { "value": 4.94, "type": "number", "method": "deterministic" }
      }
    },
    "review": {
      "unit": "field",
      "declared": 6,
      "returned": 5,
      "boxed": 5,
      "verified": 4,
      "flagged": [
        { "path": "items[0].amount", "reasons": ["text_mismatch"] },
        { "path": "invoice_no", "reasons": ["missing"] }
      ],
      "by_reason": { "text_mismatch": 1, "missing": 1 }
    },
    "normalized": { "total": 4.94 },
    "image": { "width": 1654, "height": 2339 }
  }
}顺着读下来,契约就显出来了。values 是数据本身。cells 说明每个值坐在哪里、检查得出了什么结论——items[0].amount 和印刷内容对不上,于是带着 verified: false 和理由 text_mismatch 返回,而 total 对得上,并带着它的依据。review.flagged 是那份工作清单:除了这笔金额,还有声明为 required 却始终没有返回的 invoice_no。从未返回的值没有可比对的对象,这是字符互校在原理上够不到的唯一一类。至于 normalized,它在不改动 values 里那个字符串的前提下,给出 total 的类型化读数。正是这套形状,让应用可以把文档当成一个可查询的数据集,而不是一张扁平的图片。
核验就在提取旁边
坐标能说清一个值来自哪里,却说不了它是否该出现在这一栏。回答后一个问题的,是同一次请求。除了 name 和 type,FieldSpec 还接受一组声明,每一项都在 review 里有对应的理由:
required—— 返回为空、或干脆没有返回的字段,会以理由missing列出来。这是字符互校在原理上永远够不到的一类。label—— 印在值旁边的标签。当同一个值在页面上出现多次时,坐标会锚定到该标签旁边的那次出现。它只在标签在页面上恰好印了一次时生效;找不到就退回常规查找,并把这件事以label_unresolved写进review.notes。pattern—— 值必须满足的正则(仅限 string 字段;与 JSON Schema 一样是部分匹配,要校验整个值请加^…$)。违反时抛出pattern_mismatch。enum—— 你业务侧已经拥有的取值集合:供应商主数据、品目表、单位表。落在集合之外会抛出pattern_mismatch。它同时是两个引擎在同一处误读上达成一致这一类问题的唯一抓手——当双方犯同样的错时,字符互校在结构上说不出任何话。min/max——number/integer的取值范围(含两端),按归一化后的数值判定,超出范围抛出out_of_range。near/not_near—— 必须(或不得)印在值旁边的词汇:收件方用["御中", "様"],开票方区块用["登録番号", "〒", "TEL"]。理由是near_mismatch、near_ambiguous和near_conflict,它们够得到模型读得完全正确、却从错误的位置取了值这一类。它们不会让选择变正确,只会让错误的选择显形。
这些声明没有一项会被交给模型。并不是因为你声明了,提取就更准——不管声明与否,值都一样返回。它们产生的是复核信号(label 则还产生一个坐标锚点),而那正是程序能拿来处理的部分。
落地异步任务处理
批量处理大量文档需要一条异步路径,以避免超时和资源耗尽。借助用于文档处理的 REST API,你可以批量提交文件,并为每张图片拿回一个任务 ID(每个任务初始状态为 "pending")。轮询是检查是否完成的一种简单方式,但生产环境应该用 webhook。webhook 会在处理一结束的那一刻,把最终的 JSON 载荷——包括所有边界框数据——推送到你的服务器。正是这种事件驱动的方式,让你能在按量付费的架构上扩展到成千上万张图片。如果你想在不预先承诺的前提下测试这些工作流,space-ocr 处理波动的工作量,也没有最低用量要求。
为什么可核验性成了文档数据的新标准
盲目相信一个模型,是个合规问题。如果你的系统在没有来源引用的情况下摄入数据,你就是在黑盒里运作。带边界框的 OCR API 把模型从盲目信任转向基于证据的提取:它提供一条可视化的审计轨迹,确切显示一个数据点来自哪里。这对高风险的财务和法务文档很关键,因为一个读错的字符就可能带来真实的法律责任。你需要确知那个 "Total Due" 来自右下角,而不是页面上别处一段无关的日期字符串。
有了人在环的界面,你把这些框直接叠加到文档图像上,操作员就能快速核对模型的工作。人工数据录入的错误率通常在个位数低段,而框级核验缩短了发现这些错误所需的时间:操作员不必为找一个发票号或税号而扫读整页,而是直接跳到被高亮的区域。你搭建的系统不只是能用——它是可审计的。正是这种透明度,让自动化工作流在受监管的场景里变得可行。
面向财务合规的 OCR
审计人员需要证据。当你把边界框元数据和提取出的字段一起存进 "Spaces" 时,你就在数字记录与原始图像之间建立了一条永久链接——审计时可核验的证据。为了给管道加固,用 HMAC 签名的 webhook(签名头 X-Spaceocr-Signature,HMAC-SHA256)来接收数据,这样你就能确认载荷在从 API 到你内部数据库之间没有被篡改。对财务基础设施来说,可靠性不是可有可无的加分项,而是底线。
手写文本转结构化数据
手写对传统引擎来说是出了名的难。提取手写文本转结构化数据之所以复杂,是因为版面非标准、笔迹各异。边界框在这里很关键:它让你能可视化模型在杂乱手写便签或传真件里的识别路径。如果某个字段在复杂表单上落错了位置,坐标数据让你能以编程方式纠正对齐。你不是在猜——你是在用几何锚点来修正错误、让最终数据集保持诚实,而每个锚点都在 cells 里带着自己的判定和依据。实在没能锚定到页面某处的值也不会悄悄消失,它会以理由 nobox 出现在待复核清单里。
把边界框接入开发者工作流
原始 JSON 只是起点。要充分发挥带边界框的 OCR API 的价值,就把它接进你现有的开发环境。工作流已经从手动上传文件,转向了由 CLI 驱动的自动化。通过在终端里调用 OCR,你省去了在浏览器标签页和 IDE 之间来回切换的摩擦,还能即时地用字段的空间坐标去筛选或转换特定字段。
把图片自动变成结构化表格,是高吞吐团队的常见用例。你可以用从 PDF 提取表格数据的 API识别行边界和列表头,把它们映射到 CSV 或数据库模式。这不只关乎文本,还关乎结构性的几何。当你的脚本知道某个表格单元格的框坐标时,它就能验证一个值是否属于某个特定的列。在服务端,GET /view API 用 where、sort 和 select 过滤器查询一张已保存的表格——不重跑 OCR,也不额外计费——而在应用里,"Spaces" 是一张可搜索、可编辑的表格,支持全局关键词搜索和键盘网格导航。
Claude Code 插件
Claude Code 插件两行就能装好——/plugin marketplace add oisidonut/claude-space-ocr-skill,然后 /plugin install space-ocr@space-ocr——并在你的会话里放入一个零依赖的 Python 客户端。跑这个客户端本身不需要 pip install、不需要 SDK,也不需要 MCP 服务器——它就是一个只用标准库的脚本,直接调用 REST API。(如果你更想让智能体走 MCP,space-ocr 也在 https://mcp.space-ocr.com/mcp 提供了端点;只是这个插件不走那条路。)在终端里,你把一张文档图片(发票、收据、名片、证件、表单)发给 space-ocr REST API,就能拿回结构化字段,每个字段都带着 cells 里的 box、quad 和一个 verified 判定;或者查询你已经扫描过的文档。对那些想用 API 又不想离开自己环境的开发者来说,这是个很实用的工具。
Webhook 与自动化
扩展需要事件驱动的逻辑。webhook 让你能在文档处理完成的那一刻触发下游动作。举个例子,你可以通过监听 "ocr.completed" 事件,把从收据提取数据的 API的输出送进你的记账工作流。无论你用的是 Zapier、Make,还是自建的 Node.js 后端,载荷本身就带着核验层:review.flagged 已经是一份值得再看一眼的 path 清单,脚本不必自己造一套评分,就能把干净的文档直接入账,只把其余的转给人处理。想今天就开始搭这些管道,就开始使用 space-ocr,把可核验的数据接进你的技术栈。
space-ocr:零摩擦、按量付费的结构化数据
那种僵化、只有统一固定费率的订阅时代已经过去了。如果你的文档量会波动,为用不上的容量付费就是你不需要的开销。space-ocr 每张成功处理的图片收费 $0.05,所以你的成本随实际用量线性增长——而且只对返回结果的提取计费。这份务实还延伸到功能层面:有些服务商把空间元数据当成高级附加项,而 space-ocr 把带边界框的 OCR API 作为标准能力返回。可核验性是数据完整性的底线要求,而不是升级套餐才有的特权。
用上结构化字段 OCR API 不该要跨过一道采购门槛。你可以从免费层起步——每月 100 次扫描,无需信用卡——用你自己的文档类型测试坐标精度。从注册到你第一份成功的 JSON 载荷,路径很短。无论你是处理几百张发票的初创团队,还是处理量大得多的团队,价格都保持可预测,数据都保持可核验。
在 Spaces 里管理数据
在应用里,"Spaces" 是原始 API 输出与团队日常工作之间的桥梁。它是一张可搜索、可编辑的表格,每个提取出的字段都始终与它在原始文档上的框保持关联。你可以复核提取结果、做人工修正,而每个值始终连着它来自的那个框。全局关键词搜索能在一张表格里找到任意值,键盘网格导航让你快速移动。当你需要以编程方式过滤时,GET /view API 会在服务端用 where、sort 和 select 查询一张已保存的表格——比如 total>=40000 或 vendor~ABC——只返回匹配的行,不重跑 OCR,也不计费。
几分钟内上手
集成为即刻可用而设计。你可以生成一个 API key,几分钟内处理你的第一张图片。要走基于 CLI 的提取路径,Claude Code 插件让你从终端发送本地文件,不离开环境就能拿到结构化数据。从原始图片到一个经过校验的数据对象,路径很短。如果你准备好削减人工录入、搭建一条高可信的管道,就在 space-ocr 上免费开始处理带可核验边界框的文档。
扩展可核验的文档工作流
从提取纯文本,走向高可信的数据对象,对生产级自动化来说已经不再是可选项。你已经看到空间坐标如何充当审计轨迹,把一次"黑盒"提取变成一条可核验的记录。通过落地带边界框的 OCR API,你为团队提供了快速人在环核验和精确字段映射所需的几何锚点。这一转变消除了非结构化数据的模糊性,用一条可审计的管道取代了人工录入。
可靠性不必背着一个限制性的固定费率价签。凭借每张成功图片 $0.05 和对 Claude Code 插件的原生支持,你可以毫无摩擦地从 CLI 或后端服务调用这些能力。可核验的边界框是现代数据完整性的标准要求,所以它们默认包含,每个值都始终可对照页面核查。是时候搭建一套邀请核验、而不是躲在不透明界面背后的系统了。免费开始使用 space-ocr,今天就开始部署高精度提取。
常见问题
OCR 里的边界框(bounding box)和边界区域(bounding region)有什么区别?
边界框是一个与坐标轴对齐的矩形。space-ocr 用四个整数——xmin、ymin、xmax、ymax——表示它,落在归一化的 0–1000 网格上,计算开销小,对干净的数字原生文档表现很好。对于倾斜、旋转或起皱的扫描件,space-ocr 还会额外返回一个四点定向的 quad(按左上、右上、右下、左下的顺序排列),它会跟随文档的倾斜方向,对物理形变的页面提供普通矩形给不了的精度。
在 Python 里怎么用边界框坐标在图片上画框?
space-ocr 返回的坐标在 0–1000 网格上,所以要用图片尺寸把它换算回像素。对于一张宽 1000 像素的图,xmin 为 500 对应第 500 像素(pixel_x = xmin / 1000 * image_width);对于宽 2000 像素的图,同样的 xmin 500 就对应第 1000 像素。尺寸请取自 data.image,而不是你上传的那个文件——那是应用了 EXIF 旋转和服务端缩放之后、实际被读取的那一页的尺寸。先把 xmin、ymin、xmax、ymax 都换算成像素,再用 Pillow 或 OpenCV 调用 draw.rectangle 画出叠加框,供人工核验。
带边界框的 OCR API 能识别手写文字吗?
能。手写便签和传真件走的是与印刷文档相同的结构化字段路径,每个字段都带着 cells 里的坐标返回,让你能把潦草的字迹映射到具体的键上。手写恰恰是锚定最难的场景,而响应并不掩盖这一点:没能锚定到页面某处的值会以理由 nobox 出现在 review.flagged 里,字符与印刷内容对不上的则会拿到 text_mismatch。正是这种几何上下文,加上一份哪些没通过核验的明确清单,让你能发现并纠正非标准、手工填写表单上常见的错位。
space-ocr 支持多页 PDF 文档吗?
space-ocr 网页应用支持多页 PDF:它会把每一页渲染成一张 PNG,然后对这些页面图片跑 OCR,所以每一页都作为独立的栅格图像来处理。OCR 引擎和 REST API 处理的是图像,而不是 PDF 字节——直接调 API 时,你需要先把 PDF 各页转成图片,每个请求发一张。坐标始终对应它来源的那张页面图片,所以不存在需要对齐的页码嵌套。
用带边界框的 space-ocr API 要花多少钱?
space-ocr 按量付费:每张成功处理的图片 $0.05,而且只对返回结果的提取计费——失败的不收费。每个账户每月还有 100 次免费扫描。没有按页或按字段计价,所以你的成本随实际用量走,而不是固定的月度最低消费。
space-ocr 有 Claude Code 插件吗?
有。两行就能装好——/plugin marketplace add oisidonut/claude-space-ocr-skill,然后 /plugin install space-ocr@space-ocr——它会加入一个零依赖的 Python 客户端,直接调用 space-ocr REST API:跑它不需要 pip install、不需要 SDK,也不需要 MCP 服务器。(如果你更想让智能体走 MCP,space-ocr 在 https://mcp.space-ocr.com/mcp 提供了端点;插件只是另一条路。)在终端里,你就能把一张文档图片变成结构化字段,或查询已经扫描过的文档,全程不用切到浏览器。
所提供边界框的准确度如何?
每个值拿到的不是一个孤零零的分数,而是一个判定。cells[path].verified 在跑过的检查全部一致时为 true,有东西被标记时为 false,没有可比对的对象时为 null;同样这些字段也会连同理由出现在 review.flagged 里。evidence 里的 match_ratio 是该值的字符中,有多少在 OCR 环节于页面上检测到的符号里被 space-ocr 重新找到(0.0–1.0)——它是相对页面的覆盖度,而不是模型的自我置信度分数;达到或超过 0.85 就当作可信、经符号匹配锚定的结果。把 review 为 null 的值自动接受,把被标记的那些转到复核界面即可。
怎么把带边界框的数据导出成 CSV 或 JSON 文件?
API 默认返回结构化 JSON,你可以解析成任何格式。想走无代码路径,Spaces 网页应用会把你的文档展示为一张可搜索的表格,并导出为带 UTF-8 BOM 的 CSV,这样中日韩文字和货币符号在 Excel 里能正确打开;数组(明细行)会被展开成子行。CSV 是一种通用格式,可以加载到电子表格或数据库里——没有任何专有锁定。