把文件變成可核對資料的日語 OCR
用 space-ocr 讀取日語收據、發票與送貨單:混合文字、全形與直書、不亂碼的中日韓安全 CSV,值在 data.values,位置在 data.cells,需要複核的項目列在 data.review.flagged。
日語是普通 OCR 悄悄崩掉的地方。一張收據裡混著漢字、假名、半形片假名、全形數字,偶爾還有一段英文,而合計可能直書在右邊緣的一列裡。大多數工具要麼先讓你選語言,要麼回傳一團丟了版面的扁平文字。真正有用的日語 OCR 必須一次讀完這些,並告訴你每個數字來自哪裡。
space-ocr 兩件事都做。它讀 JP 文件,把結構化欄位放進 data.values,並把每個值連同它在頁面上被讀取的確切位置一起回傳——data.cells[path] 裡有框、四點 quad、判定與依據。沒有通過核對的值會以工作清單的形式出現在 data.review.flagged,所以你看的是一條短佇列,而不是重讀整頁。沒有語言設定要選,日文、韓文、中文、英文由一個引擎一起處理。
看一次你可以親自核對的真實日語擷取
把滑鼠移到下方任一欄位上。這裡讀的兩張收據是真實資料——合計 2,045 的 KINSHO 布施店與合計 4,286 的 ライフ 国分店,都是 2019 年 8 月的日期。每個值與框都直接讀自一次真實的解析結果,而不是擺拍,框會跟隨每一列混著漢字、假名與數字的文字。列旁邊的字元比對數值是輔助依據,不是及格線。
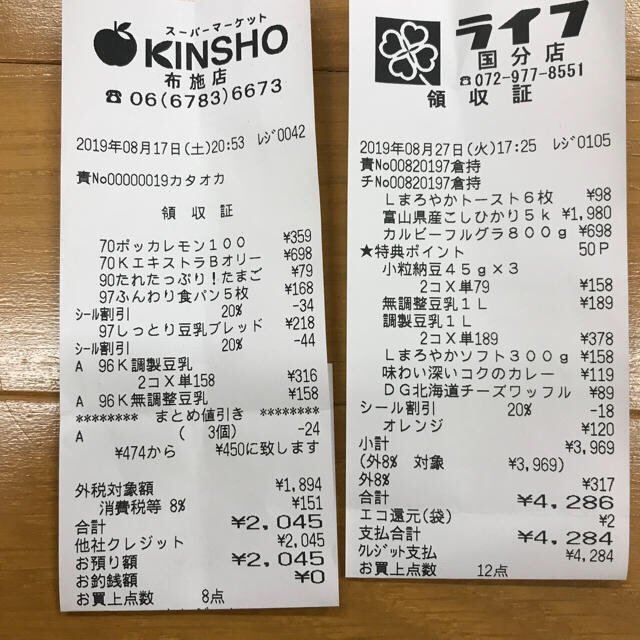
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocr 裡的日語 OCR 如何運作
模型不產出座標。它讀文件、回傳值,然後由字元比對器把這些字元與 OCR 在頁面上真正偵測到的符號比對,這次比對產出框、quad 與每個儲存格旁邊的依據。verified 是與 review 互為鏡像的判定:只要掛上任何理由就是 false,比對跑過且沒有任何標記是 true,沒有可比對的東西則是 null。字元比對本身在 evidence.text_match,而 evidence.match_ratio 給出字元覆蓋率,屬於輔助依據而非及格線。兩個引擎仍可能在同一個誤讀上達成一致,所以這條佇列告訴你先看哪裡,並不是保證。
把 PDF 拖進應用程式,每一頁會先被算繪成圖片再讀取——對多頁發票與送貨單很方便。直接呼叫 API 時,用 URL 或 base64 傳送點陣頁面圖片,回傳的結構化結果一樣。宣告你需要的 fields,或傳送 autoFields: true 讓回應替你提議;明細列用帶 children 的 array 欄位描述,路徑寫作 items[0].amount。
宣告在擷取之後才檢查,也從不傳給模型,因此它改變的是複核訊號而不是讀數。type: "date" 增加一層決定性的 data.normalized——令和8年8月16日 解析為 2026-08-16,而 data.values 保留印刷原樣;type: "number" 把 ¥13,220 變成 13220。pattern 針對摺成半形後的值比對,所以全形印刷的登記號也能用 ^T[0-9]{13}$ 比對。對日本單據常見的當事人混淆,可以給收件方宣告 near 詞彙 御中 或 様,並把 登録番号 / TEL / 〒 宣告為 not_near:選錯的值就不會悄悄通過,而是以 near_mismatch 或 near_conflict 顯示出來。數量欄的 一式、付款期限的 翌月末払い 這類本來就印成非數值寫法的欄位,留作 string 更好——一旦宣告型別,正確的單據每次都會進複核清單。
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/invoice-jp.jpg",
    "imageType": "url",
    "fields": [
      { "name": "issuer", "type": "string", "required": true,
        "near": ["登録番号", "TEL", "〒"] },
      { "name": "bill_to", "type": "string",
        "near": { "terms": ["御中", "様"], "match": "suffix" },
        "not_near": ["登録番号", "TEL"] },
      { "name": "registration_no", "type": "string", "pattern": "^T[0-9]{13}$" },
      { "name": "issue_date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      { "name": "items", "type": "array", "children": [
        { "name": "name", "type": "string" },
        { "name": "qty", "type": "string" },
        { "name": "amount", "type": "number" }
      ] }
    ]
  }'
如何對日語文件做 OCR
- 加入你的文件在應用程式中拖入收據、發票或 PDF——每一頁會被算繪成圖片並排入 OCR 佇列。使用 API 時,把點陣頁面圖片(url 或 base64)傳送到 /ocr/fields。沒有語言設定。
- 宣告你的欄位列出你需要的 fields,或傳送 autoFields: true 讓回應提議一份 schema。明細列表格用帶 children 的 array 欄位,並在單據支援該規則的地方加上 type、pattern、near 或 not_near。
- 讀取結構化結果業務資料留在 data.values。data.cells[path] 帶著 box、quad、verified、review 與 evidence;data.image 是這些座標的量度基準;data.normalized 存放已宣告純量欄位解析出的日期與數字。
- 處理複核佇列走訪 data.review.flagged。每一項有 path,以及按排名排列、首項為主要理由的 reasons 陣列,flagged.length 就是需要處理的數量。開啟對應的儲存格即可高亮該值被讀取的區域。
- 匯出或查詢下載 CSV(UTF-8 BOM,日語能乾淨開啟,明細列已展開),或用 GET /view 搭配 where、sort、select 讀取已儲存的工作表——讀取已存的列不會重跑 OCR,GET /view 也不計費。
簡單、可預期的定價
1 點數 = 1 頁 = $0.05(含稅),每月 100 點數免費,免信用卡。失敗不計費。方案計畫增加每月點數、更多工作表與儲存空間。