用 API 從發票中擷取資料
space-ocr 發票資料擷取 API 的開發者指南:用 curl 與 Python 呼叫 POST /ocr/fields、宣告 fields 結構或改用 autoFields,以及每個值的來源座標(box·quad)與 review 契約。
從發票上抓出結構化資料 —— 廠商、發票號碼、日期、明細金額、稅額 —— 是最常見的文件自動化工作之一,卻也是最費工、最難自己手刻的一種。對 OCR 文字跑 regex,只要某家廠商一改版面就立刻失效。而範本比對工具又要你為每一家供應商手動框格子。你真正想要的,是一個能讀懂任何版面、回傳乾淨且有型別欄位的發票資料擷取 API —— 而且關鍵在於,它還要告訴你每個值在頁面上的哪個位置被讀出來的,這樣你才敢相信結果。
最後這一點才是整件事的重點。一個只回傳 total: 2,045、卻沒有任何來源依據的發票擷取端點,放進應付帳款流程裡就是個隱患。本文將帶你走過 space-ocr 的 POST /ocr/fields 端點:一次同步呼叫,接收一張發票影像,套用你宣告的欄位結構(或交由 autoFields 自動提議),並讓每個值都帶著來源座標與明確的驗證判定回傳。
還沒寫半行程式碼,先看輸出長什麼樣
下面是一張真實解析出來的收據。把游標移到任一欄位上,影像上對應的方框就會亮起 —— 那個方框正是該值被讀取出來的位置,而且每個值都帶著自己的驗證判定與佐證。發票的運作方式一模一樣:你擷取的每個欄位,都會回到它原本所在的像素上。
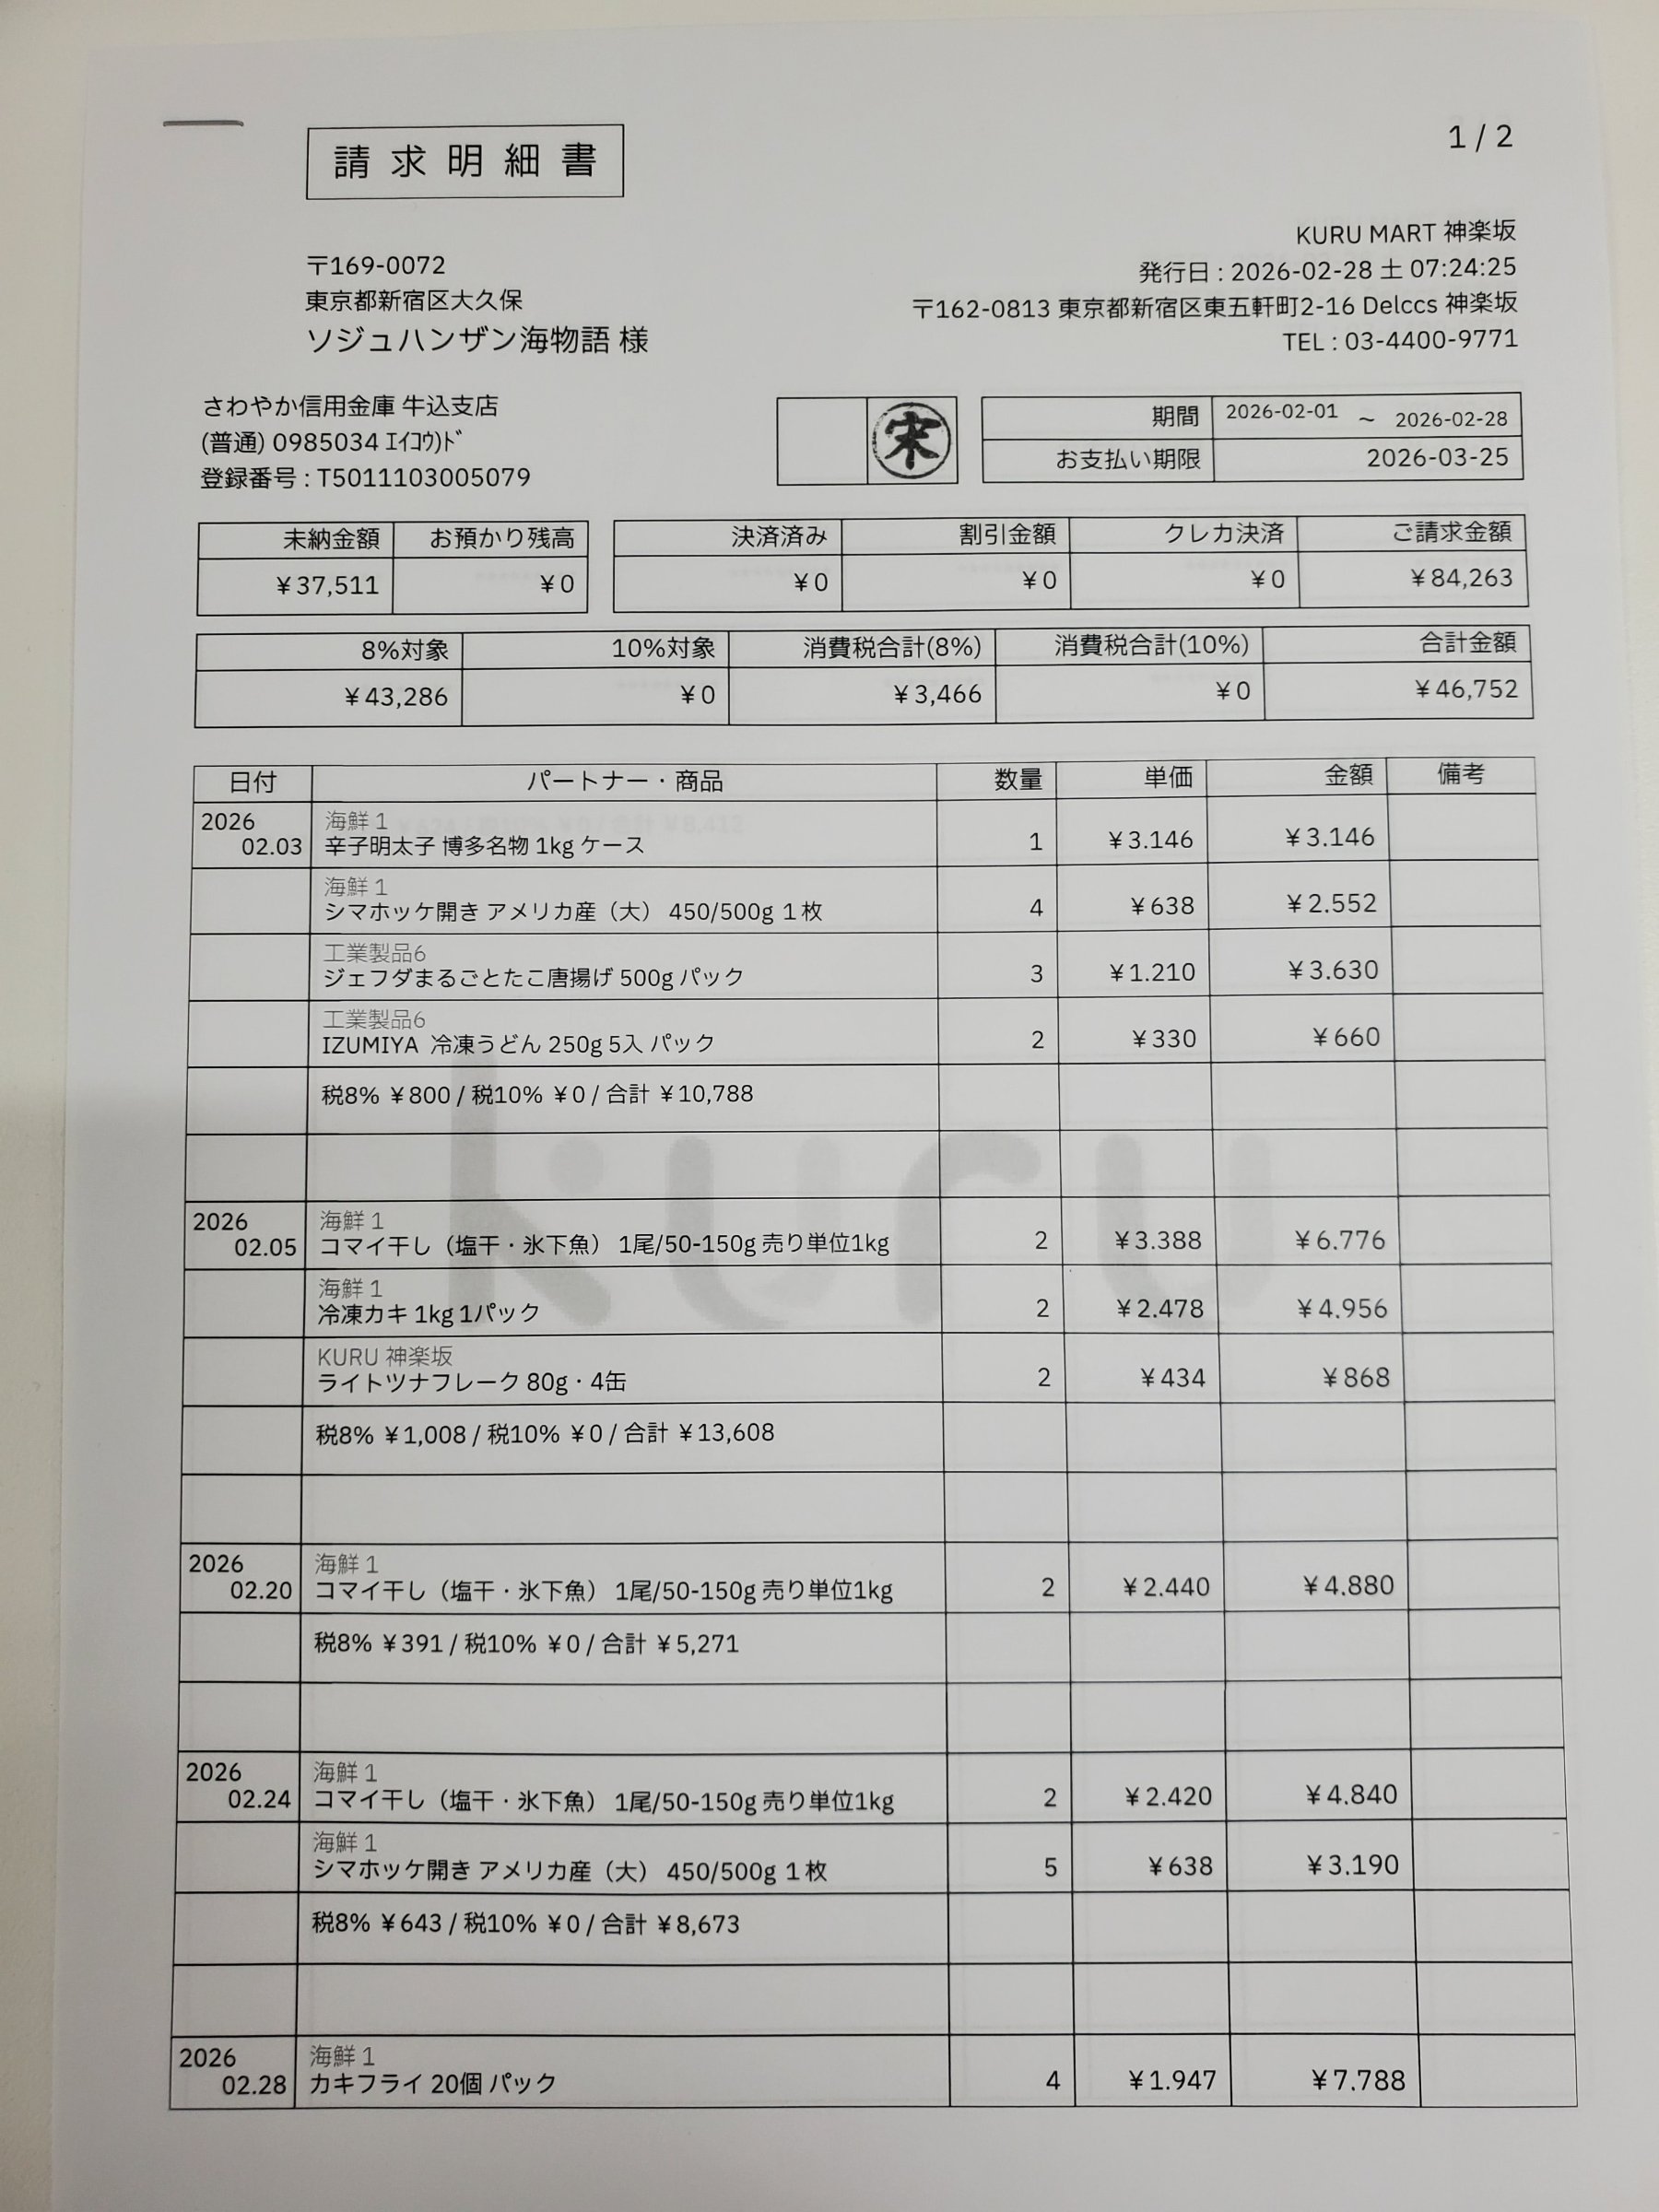
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
驗證與 base URL
公開 API 只有單一基底位址 —— https://api.space-ocr.com —— 沒有 /v1 這類路徑版本。每次請求都以 HTTP Bearer token 驗證,金鑰以 spocr_ 為前綴:
Authorization: Bearer spocr_xxxxxxxxxxxxxxxx金鑰缺漏或無效會回傳 401(error.code: "invalid_api_key")。403 的意思完全不同:金鑰本身有效,但該資源不在這把金鑰的範圍內(例如另一把金鑰建立的 job)。每個回應都帶有 X-Request-Id 標頭(格式為 req_xxx),建議記錄下來以便支援追蹤。完整規格以 OpenAPI 3.1 發佈於 GET /openapi.json,若你想直接產生用戶端可以參考。
最簡單的呼叫:明確宣告發票欄位結構
最快的路徑,是把你要的欄位直接指名出來。fields 接收一個 FieldSpec 物件陣列,回應就會完全依照這份宣告的形狀回來 —— 不必挑範本,也不必畫框。imageType 是必填參數,用來說明 image 的攜帶方式:"url" 或 "base64"。
宣告純量 type 不只是記錄意圖。把 invoice_date 宣告為 "date"、金額欄位宣告為 "number",會在原始讀值旁邊多出一層具決定性的 data.normalized。invoice_no 上的 required: true 表示值為空或整個缺漏時,它會出現在複核清單中,而不是以空字串安靜地通過。pattern 是你自家的編號慣例;比對方式與 JSON Schema 相同屬部分比對,要檢查整個值請以 ^…$ 錨定。
若你還不確定該宣告什麼,就不要傳 fields,改送 autoFields: true,模型會直接從文件提議一份結構。探索陌生的供應商單據時這是合適的做法;等欄位名稱穩定下來,再把它們移進明確的 fields 陣列,讓回應結構不再隨每次呼叫變動。
curl -X POST https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer spocr_xxxxxxxxxxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/invoices/inv-4471.jpg",
    "imageType": "url",
    "fields": [
      { "name": "vendor", "type": "string" },
      { "name": "invoice_no", "type": "string", "required": true,
        "pattern": "^[A-Z0-9-]+$" },
      { "name": "invoice_date", "type": "date" },
      { "name": "subtotal", "type": "number" },
      { "name": "tax", "type": "number" },
      { "name": "total", "type": "number" },
      { "name": "line_items", "type": "array",
        "children": [
          { "name": "description", "type": "string" },
          { "name": "qty", "type": "number" },
          { "name": "unit_price", "type": "number" }
        ]
      }
    ]
}'駝峰式命名才是正式形式。 參數為 imageType 與 autoFields。舊的 snake_case 別名(image_type、auto_fields)仍可運作,但已棄用 —— 新程式碼請優先採用駝峰式名稱。
回應的結構
成功的呼叫會回傳 { status: "success", data: { ... } }。data 分成四塊,每一塊只負責一件事:
data.values—— 業務資料本身,形狀與你宣告的fields完全一致,不摻雜其他東西。data.cells—— 以路徑(total、line_items[0].unit_price)為鍵的扁平對應表。每個 cell 帶有落在 0–1000 正規化格線上的軸對齊矩形box{ xmin, ymin, xmax, ymax }(0,0 = 左上角,1000,1000 = 右下角)、隨頁面傾斜的四點quad(因此就算是歪斜拍下的發票也能貼合),以及verified、review與evidence。換算成像素以data.image為基準:pixel_x = box.xmin / 1000 × data.image.width。data.review—— 彙總:unit: "field"、declared/returned/boxed/verified各項計數、flagged({ path, reasons }的陣列)以及by_reason直方圖。需要人工留意的件數就是flagged.length,沒有另外的計數器;by_reason統計的是全部理由而非每件一次,所以總和會大於等於flagged.length。data.normalized—— 與values同形的稀疏樹,只放那些宣告了純量型別或pattern的欄位的決定性解析結果,並不會覆寫values。
verified 是判定,不是字元比對分數:只要 review 帶有任何一類理由就是 false;比對跑過且沒有任何標記則為 true;本來就沒有可比對的對象時(例如整列的聯集)為 null。字元比對本身放在 evidence.text_match,所以 verified: false 與 text_match: true 同時出現並不矛盾 —— 字元對上了,但被你宣告的規則攔了下來。evidence 另外還有 source(vision_symbol_match、token_id 等)、match_ratio,以及 printed_text(OCR 在該座標讀到的字形)。需要精確字串比對時,請與 printed_text 對照。
理由代碼屬於 API 契約詞彙,不做翻譯:text_mismatch、missing、pattern_mismatch、type_mismatch、out_of_range、low_ratio、overwide_box 等。reasons 一律是陣列,依排名排列,第 0 項為代表 —— 請為你會處理的代碼建立對應,未知代碼則保留一段通用訊息。
{
  "status": "success",
  "data": {
    "values": {
      "vendor": "Acme Supply Co.",
      "invoice_no": "INV-4471",
      "invoice_date": "2026/06/18",
      "subtotal": "1,859",
      "tax": "186",
      "total": "2,045",
      "line_items": [
        { "description": "Steel bracket 40mm", "qty": "12", "unit_price": "98" }
      ]
    },
    "cells": {
      "total": {
        "box": { "xmin": 595, "ymin": 974, "xmax": 781, "ymax": 1000 },
        "quad": [
          { "x": 594, "y": 975 }, { "x": 781, "y": 972 },
          { "x": 781, "y": 998 }, { "x": 595, "y": 1000 }
        ],
        "verified": true,
        "review": null,
        "evidence": {
          "text_match": true,
          "source": "vision_symbol_match",
          "match_ratio": 0.93,
          "printed_text": "2,045"
        },
        "normalized": { "value": 2045, "type": "number", "method": "deterministic" }
      },
      "line_items[0].unit_price": {
        "box": { "xmin": 693, "ymin": 460, "xmax": 738, "ymax": 488 },
        "quad": [
          { "x": 693, "y": 460 }, { "x": 738, "y": 460 },
          { "x": 738, "y": 488 }, { "x": 693, "y": 488 }
        ],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": {
          "text_match": false,
          "source": "vision_symbol_match",
          "match_ratio": 0.62,
          "printed_text": "9B"
        }
      }
    },
    "review": {
      "unit": "field",
      "declared": 9,
      "returned": 9,
      "boxed": 9,
      "verified": 8,
      "flagged": [
        { "path": "line_items[0].unit_price", "reasons": ["text_mismatch"] }
      ],
      "by_reason": { "text_mismatch": 1 }
    },
    "normalized": {
      "invoice_no": "INV-4471",
      "invoice_date": "2026-06-18",
      "subtotal": 1859,
      "tax": 186,
      "total": 2045,
      "line_items": [ { "qty": 12, "unit_price": 98 } ]
    },
    "image": { "width": 1654, "height": 2339 }
  }
}座標並不是照模型的說法照單全收。 語言模型會回傳每個值的文字 —— 以及它用了哪些 word token 的提示 —— 但從不直接回傳方框本身。引擎接著把這段文字,拿去和視覺 OCR 在頁面上實際偵測到的符號做字元層級的比對;evidence.match_ratio 就是有多少比例被找到,而方框會落在這些字元真正來自的像素上。模型的 token 提示可能帶有雜訊(在重複的列之間,它有時會把提示張冠李戴),因此會以欄、列的一致性檢查來驗證它們,而不是盲目採信。這個比例只是佐證,並非判定 —— 判定由 verified 與 review 負責。完整推論請見 為什麼 bounding box 讓 OCR 可稽核。
會變成複核訊號的宣告
FieldSpec 除了替欄位命名,還能宣告「什麼樣的值才算好」,而每一項宣告都繫著一個複核理由。required: true 會在值為空、或根本沒有回傳時立起 missing —— 這是字元比對本身永遠看不到的唯一一類失敗。pattern 會立起 pattern_mismatch,enum 在值落到集合之外時同理,min / max 針對正規化後的數字立起 out_of_range,純量 type 則在無法解析時立起 type_mismatch。
這些都不會送進模型。宣告不會讓擷取變得更準 —— 值在有無宣告的情況下都一樣回來。宣告決定的是哪些路徑會進入 data.review.flagged,以及在 label 的情況下引擎把座標錨在哪裡。讓「讀」與「查」彼此獨立正是重點:唯有如此,兩者的一致才有份量。
真正用來引導模型的是 description:用淺白的文字說明要擷取什麼、怎麼擷取。而 type: "array" 搭配 children,正是用來抓出重複的明細項目 —— 一份子結構對應多列,每一列都能以 line_items[0]、line_items[1] 這樣的路徑指名。(我們在 從發票擷取明細項目 一文中有深入說明。)
import requests, base64

with open("invoice.jpg", "rb") as f:
    b64 = base64.b64encode(f.read()).decode()

resp = requests.post(
    "https://api.space-ocr.com/ocr/fields",
    headers={"Authorization": "Bearer spocr_xxxxxxxxxxxxxxxx"},
    json={
        "image": b64,
        "imageType": "base64",
        "fields": [
            {"name": "vendor", "type": "string",
             "description": "Supplier / billing company name"},
            {"name": "invoice_no", "type": "string", "required": True,
             "description": "Invoice number as printed"},
            {"name": "invoice_date", "type": "date"},
            {"name": "total", "type": "number",
             "description": "Grand total"},
            {"name": "line_items", "type": "array",
             "description": "One row per line on the invoice",
             "children": [
                 {"name": "description", "type": "string"},
                 {"name": "qty", "type": "number"},
                 {"name": "unit_price", "type": "number"},
             ]},
        ],
    },
    timeout=200,
)

data = resp.json()["data"]

# 印在紙面上的值,以及它旁邊具決定性的解析結果
print(data["values"]["total"], data["normalized"].get("total"))

# 複核佇列:每個需要人工查看的路徑一筆
for item in data["review"]["flagged"]:
    cell = data["cells"].get(item["path"])
print(item["path"], item["reasons"][0], cell["box"] if cell else None)values 是讀值,不是逐位元組的複本。 印成 7,855 的總額會以字串 "7,855" 回傳 —— 不做摘要也不改寫,正因如此這個值才能錨到座標上。但它終究是模型讀出來的文字,而字元比對會先把全形、括號與空白摺疊後再比較,所以像 (税抜) → (税抜) 這樣的改寫會通過。需要精確字串比對時,請與 cells[path].evidence.printed_text(OCR 在該座標讀到的字形)對照。解析後的形式(ISO 日期、去掉分隔符的數字)放在 data.normalized,不會覆寫 values。你在網頁 UI 上看到的 ¥ 只是裝飾,並不屬於值的一部分。引擎只接受點陣影像 —— JPEG、PNG、GIF、BMP、TIFF、WebP —— 並會自動轉成 RGB。
走非同步路線:批次上傳、工作(jobs)與 webhook
POST /ocr/fields 是同步的,非常適合在請求/回應的迴圈裡處理單張發票。它會在讀取頁面期間保持連線,處理時間上限為 180 秒;超過就會回傳 504 與 error.code: "ocr_engine_timeout",而且這次呼叫不計費。觸頂的原因多半是版面密度而非像素數,因此對策是一頁一影像,或改走下面的非同步路線。
若是一整個資料夾的發票,就用 POST /upload(multipart 的 files,可重複,每次請求最多 20 個檔案)把它們送進一張 sheet。預設會立刻回傳一個 jobs 陣列:
{ "path": "...", "jobs": [ { "uniqueKey": "...", "jobId": "...", "status": "pending" } ] }接著你有兩種方式得知結果:輪詢 GET /jobs/{jobId},或註冊一個 webhook。Webhook 是每個 space 一個 URL,透過 X-Spaceocr-Signature 標頭以 HMAC-SHA256 簽章。你會在意的事件有 upload.received、item.created、ocr.completed(其 data.result 以相同的 values / cells / review / image 結構帶著擷取結果)以及 ocr.failed。在信任任何 payload 之前,務必先驗證簽章。
冪等性、請求追蹤與速率限制
有幾個標頭能讓正式環境的流程安全地重試:
| 標頭 | 用途 |
|---|---|
Idempotency-Key | 在 /ocr/fields、/create 與 /upload 上受理。以相同金鑰重試會在 24 小時內重播快取的回應(X-Idempotent-Replay: true)—— 安全重試,不會重複扣費。它是重試的保護機制,而非儲存手段。 |
X-Request-Id | 每個回應都會回傳(req_xxx);請記錄下來以便追查問題。 |
X-RateLimit-Remaining | 該金鑰在這一分鐘內剩餘的可呼叫次數。 |
速率限制為每把金鑰每分鐘 60 次請求、每個 uid 每分鐘 600 次請求。一旦超出,你會得到 429 與 error.code: "rate_limited",等待秒數則放在 Retry-After 回應標頭中 —— 請依這個值退避(back off),不要立刻重送。
做容量規劃時可以參考:正式流量上觀測到的耗時約為 p50 7.2 秒、p90 10.5 秒。這是觀測到的分布而非 SLA,欄位多、版面密的發票會高於這個區間。
{
  "error": {
    "code": "rate_limited",
    "message": "Rate limit exceeded",
    "requestId": "req_8fa2c1"
  }
}
從擷取到一張可查詢的 sheet
發票一旦被擷取進 sheet,你就不必為了讀回資料而重跑 OCR。GET /view 會在伺服器端對已儲存的列執行查詢 —— where、sort、select、limit、offset —— 不收費、也不重新擷取。每一列都以與直接呼叫相同的 values / cells / review / image 結構回傳;想要更精簡的 payload,可加上 boxes=0 拿掉 cells 對應表。從這裡你還能匯出成 CSV(UTF-8 BOM,所以 Excel 與 CJK 文字都能正常打開)—— 詳見 把掃描文件轉成 CSV。
計費
POST /ocr/fields 每次呼叫 $0.05,而 POST /upload 是 $0.05 × N 張影像。失敗不收費 —— 400 invalid_image 與 504 ocr_engine_timeout 根本不會走到計費,而 502 引擎錯誤或 ocr.failed 事件會自動退款。唯讀端點(GET /space、/view、/jobs、/amount、/health)免費。免費方案為每月 100 點數、無需信用卡;付費方案自 Starter 每月 $19 起,Pro 為每月 $39 —— 最新方案請見定價頁。
如何用 API 從發票擷取資料
- 取得 API 金鑰並設定授權建立一把以 spocr_ 為前綴的金鑰,並透過 HTTP Bearer token 向 https://api.space-ocr.com 驗證。每次請求都帶上 Authorization: Bearer 標頭;金鑰缺漏或無效會回傳 401,資源不在金鑰範圍內則回傳 403。
- 送出發票影像對 POST /ocr/fields 送出一張發票影像,影像可用 URL 或純 base64 提供,並把必填參數 imageType 設為 'url' 或 'base64'。引擎只接受點陣影像 —— JPEG、PNG、GIF、BMP、TIFF、WebP。
- 宣告你要的欄位傳入 fields 陣列,內含 FieldSpec 物件:vendor、invoice_no、invoice_date、各金額欄位,以及作為陣列並帶 children 的 line_items。若還不確定結構,改送 autoFields: true 讓模型提議。
- 讀取值與複核佇列業務資料取自 data.values,接著走訪 data.review.flagged。每一筆是路徑加上它的理由;用該路徑到 data.cells 查出對應的 box、quad 與 evidence。
- 擴展到批次與查詢要批次處理一整個資料夾時,改用 POST /upload 送進一張 sheet,並透過輪詢 GET /jobs/{jobId} 或 ocr.completed webhook 取得結果。之後以 GET /view 查詢已儲存的列,或匯出成 CSV。