同樣的文件,同樣的結構,不同的答案: space-ocr vs Mistral
8個案例、7份文件、463個欄位、每個引擎3輪的受控基準測試:欄位讀取率、多輪穩定性,以及分數表看不到的座標差距。
space-ocr 是我們做的文件辨識 API。你送一張照片和一份想取出的欄位清單,它就把這些值當成資料回傳,每個值都帶著它在頁面上被讀取的確切位置。這篇文章是把它和 Mistral Document AI 擺在一起,用真正難處理的文件跑出來的紀錄。
每家 OCR 廠商的示範都能把乾淨的印刷發票讀得完美,我們的也一樣,而這對你要做的決定毫無幫助。真正有用的問題有三個:碰到麻煩的文件會怎樣;同一頁跑兩次答案會不會變;以及在不逐筆複查的前提下,怎麼找出讀錯的值。這三點我們都量了,下面把過程和數字全放出來,包括對我們不利的那些。
我們跑了什麼
計分案例 8 個,共 463 個值,來自 7 張照片:3 張日文送貨單、一張商品名在上一行而數量與單價在下一行的超市收據、一份用聊天訊息傳來的 24 行訂單、一份佣金明細,以及一張對著螢幕拍下的 22 行批發行情表。它們都是我們自己回歸測試裡的照片,也就是我們弄壞東西時用來示警的那一組。
照片 7 張而案例 8 個,是因為其中兩個案例是同一張聊天訂單照片、同一份標準答案。它們在測試裡分開管理,用來走不同的內部路徑;對兩個引擎而言,只是同一張圖片收到兩次。因此這一張照片就占了 463 個值中的 144 個,讀數字時請把這點算進去。
三條測試線,收到的圖片、欄位清單(名稱與說明完全一致)以及「照印出來的原樣抄」這道指令都相同。
| 測試線 | 呼叫的是什麼 | 欄位怎麼給的 |
|---|---|---|
| space-ocr | 正式環境 POST /ocr/fields | 帶名稱與說明的欄位清單 |
| Mistral OCR | mistral-ocr-latest,/v1/ocr 加 document_annotation | 同一份清單,作為 strict JSON schema |
| Mistral 視覺 LLM | mistral-medium-latest,聊天中附圖 | 同一份清單,response_format: json_schema,temperature 0 |
每份文件每條線跑 3 次,共 72 次,原始回應全部存檔。評分是三條線共用的一支腳本:去掉空白後與手寫標準答案完全一致才算對。2026 年 8 月。
結果,以及必須一起看的但書
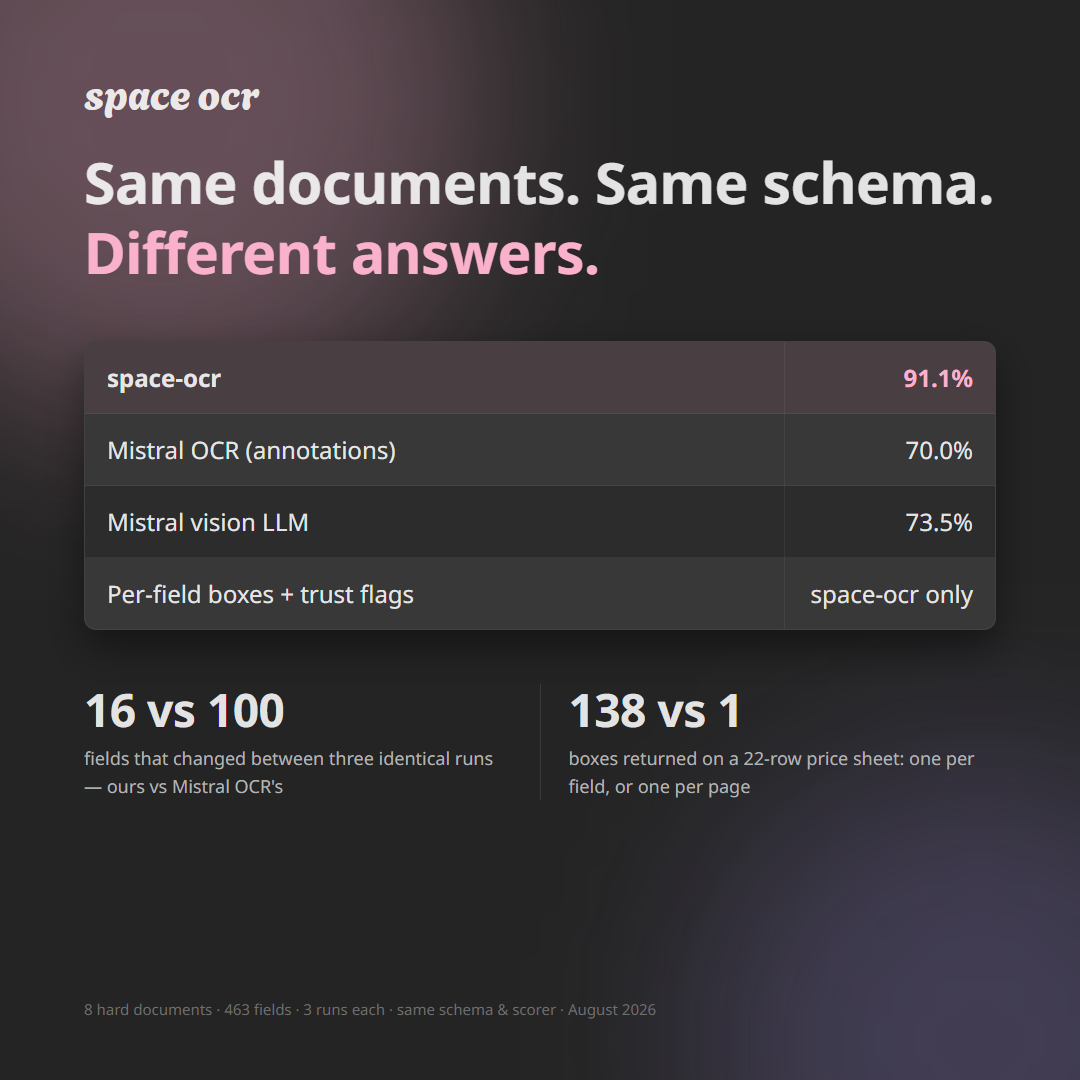
space-ocr 把 463 個值中的 91.1% 讀成完全一致(3 次平均)。Mistral 的 OCR 標註是 70.0%,視覺 LLM 是 73.5%。
任何引擎的錯項裡都有一部分只是格式問題:留了貨幣符號,或數字後面帶了單位。所以我們又把只差分隔符或空格的不一致全部剔除,只數內容錯誤:每次 space-ocr 約 23 個,Mistral OCR 119 個,視覺 LLM 93 個。差距依然在。
看數字之前還有一點。標準答案是照我們自己流程對「一個值到哪裡結束」的慣例抄寫的,所以包括我們在內的每個線上引擎都會因為邊界認定不同而失分。該讀的是各條線之間的差距,絕對分數是下限,不是成績。
每份文件,每個分數
3 次平均,答對的值數 / 總數。
| 文件 | 值 | space-ocr | Mistral OCR | Mistral VLM |
|---|---|---|---|---|
| 行情表 22 行,對著螢幕拍攝 | 141 | 139.0 (98.6%) | 139.0 (98.6%) | 133.7 (94.8%) |
| 佣金明細 | 44 | 42.7 (97.0%) | 39.0 (88.6%) | 34.7 (78.8%) |
| 送貨單 C | 53 | 50.3 (95.0%) | 43.7 (82.4%) | 47.3 (89.3%) |
| 送貨單 B | 37 | 34.3 (92.8%) | 18.0 (48.6%) | 24.3 (65.8%) |
| 兩行式超市收據 | 13 | 12.0 (92.3%) | 2.3 (17.9%) | 1.3 (10.3%) |
| 聊天訂單 24 行(2 個之 2) | 72 | 61.0 (84.7%) | 21.3 (29.6%) | 41.7 (57.9%) |
| 聊天訂單 24 行(2 個之 1) | 72 | 58.0 (80.6%) | 39.7 (55.1%) | 42.3 (58.8%) |
| 送貨單 A | 31 | 24.7 (79.6%) | 21.0 (67.7%) | 15.0 (48.4%) |
| 合計 | 463 | 422.0 (91.1%) | 324.0 (70.0%) | 340.3 (73.5%) |
先看第一列。在這組裡最乾淨的那份文件、密密麻麻 141 個值的印刷表格上,Mistral OCR 和我們打成平手。認字並不是這些引擎拉開差距的地方,任何遮住這點的比較都是在賣東西給你。
拉開差距的是表格下半部,方向也一致:版面越彆扭,差距越大。另外請看聊天訂單那兩列。同一張照片、同一份答案、同一套 schema 送了兩次,我們兩次相差 3 個值,Mistral OCR 相差 18 個。
同一頁跑三次
滿分 463,每次的總分。
| 測試線 | 第 1 次 | 第 2 次 | 第 3 次 | 波動 |
|---|---|---|---|---|
| space-ocr | 430 | 414 | 422 | 16 |
| Mistral OCR | 322 | 275 | 375 | 100 |
| Mistral 視覺 LLM | 360 | 329 | 332 | 31 |
100 個值的波動不是平均值附近的雜訊,基本上是兩個不同的產品。Mistral OCR 有一次在一小時前拿到 72 分之 58 的文件上只回傳了 72 分之 3,因為標註層把一張 43 行表格的每一欄都打亂了。而回應裡沒有任何東西能把這一次和好的那一次分開。
錯的時候,究竟怎麼錯
這是差距最大的兩行式收據,第 1 次。這張收據把商品名印在一行,數量與單價印在下一行,合計區塊緊貼在同一欄下方。
| 值 | 頁面上印的 | space-ocr | Mistral OCR |
|---|---|---|---|
| 第 1 項商品名 | ポッカサッポロ果実の | 正確 | 006142 ポッカサッポロ 果実の |
| 第 1 項數量 | 12 | 正確 | 12コ |
| 第 1 項單價 | 98 | 正確 | 単98 ¥1,176 |
| 第 2 項商品名 | 塩パン | 正確 | 011102 塩パン |
| 日期 | 2017年07月30日(日) | 正確 | 2017年07月30日(日) No.2805 |
| 合計 | 1,451 | ¥1,451 | ¥1,451 |
先看最後一列。合計上兩個引擎給出同樣的答案,而且都被判錯,因為標準答案裡沒有貨幣符號。這類錯誤會把包括我們在內的所有引擎的錯誤數撐大,這也是上面「只算內容錯誤」的數字比原始數字更有用的原因。
其餘幾列則是另一回事。Mistral 在那裡並沒有認錯字,而是把貨架編碼黏到商品名上、把價格黏到數量那一行,因為它始終沒弄清楚印出來的兩行其實是一筆紀錄。
24 行聊天訂單的失敗值得整段看完,因為那是下游代價最高的一種失敗。
| 列 | 印的 | Mistral OCR 回傳 |
|---|---|---|
| 第 1 列 備註 | ヒチョウ | (空) |
| 第 2 列 品名 | クエ | ヒチョウ |
| 第 2 列 備註 | 頭落とし | 背 |
| 第 3 列 品名 | ブリ | クエ |
| 第 3 列 備註 | サクラブリ | (空) |
每一列都往上錯開了一格。單看每個值,都是頁面上真實存在、拼寫正確的字串;當成表格看,從第二列起全錯,而回應的樣子毫無異常。
同一頁上我們也有錯,只是規模小些:ヒチョウ 讀成 ヒチョウ背,冷凍 讀成 冷凍 2L,是把相鄰儲存格併了進來,而不是整表錯位。在送貨單 B 上,我們把單價 1510 讀成 510,漏掉了從旁邊一欄黏過來的那一位。
分數表顯示不出來的東西
在行情表上向兩個引擎要同樣的 141 個值,回傳的兩份答案看起來一樣能用,直到你問每個值從哪裡來。
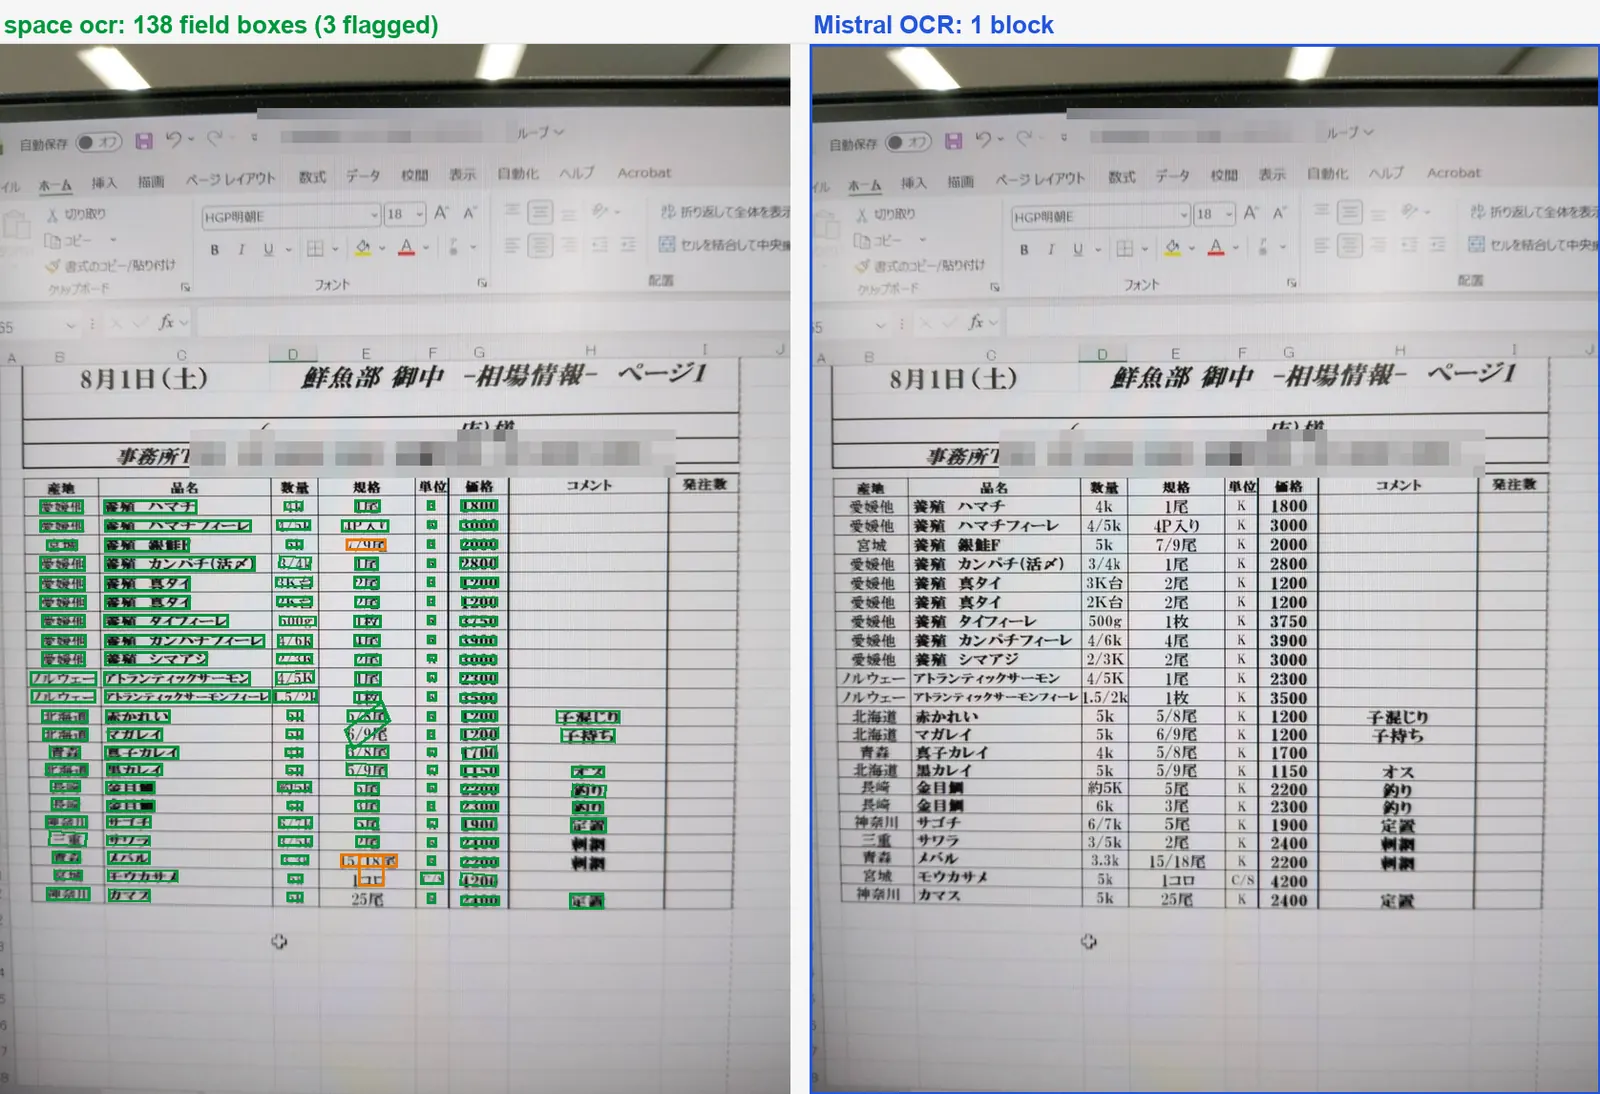
space-ocr 為每個值回傳一個方框,方框貼在這個值被讀取的真實像素上。在我們為這次基準測試存檔的 Mistral 回應裡(mistral-ocr-latest,2026 年 8 月),同一張行情表回傳的是覆蓋整張表的一個矩形。那批回應裡沒有值層級的座標,我們看到的最細粒度就是段落區塊。至於它現在回傳什麼,動手設計之前請對照 Mistral 的最新文件確認。
那批回應裡也沒有驗證訊號。space-ocr 的每個值都裝在 data.cells[path] 裡回傳:0 到 1000 網格上的 box 與 quad、作為判定的 verified、用機器可讀代碼列出哪裡沒通過的 review.reasons,以及裝著字元比對本身(text_match)、其依據 match_ratio、辨識端能給出時的 ocr_confidence 的 evidence。需要人看的值集中在 data.review.flagged 一處。同一個值在頁面上重複出現時,欄位宣告裡的 label 決定取哪一次出現。verified: true 請照字面讀:跑過的檢查沒發現問題,而不是保證這個值就是你要的那個。
這才是真正改變工作方式的地方。有方框和複查清單,悄悄讀錯的值會被擺上檯面,人可以從被標出的那幾個開始,而不是把 141 個重看一遍。它不是一張能撈起一切的網:兩次讀法給出同樣答案的值,比對就沒有東西可立,上面那列合計正是這個樣子。但帶標記的錯值只花你一眼,沒有標記的錯值花的是你在它上面搭起來的全部。
整組文件,兩個引擎
7 張照片全在這裡。左右是同一張圖,方框直接取自基準測試第 1 次執行的存檔回應。綠色是 space-ocr 的一個值,橘色是那次執行中引擎標記為需要複查的值,藍色是 Mistral OCR 的一個區塊。第三方的商號、地址、電話、帳號與經辦人姓名在發布前都做了馬賽克,所以有些方框壓在灰色矩形上。
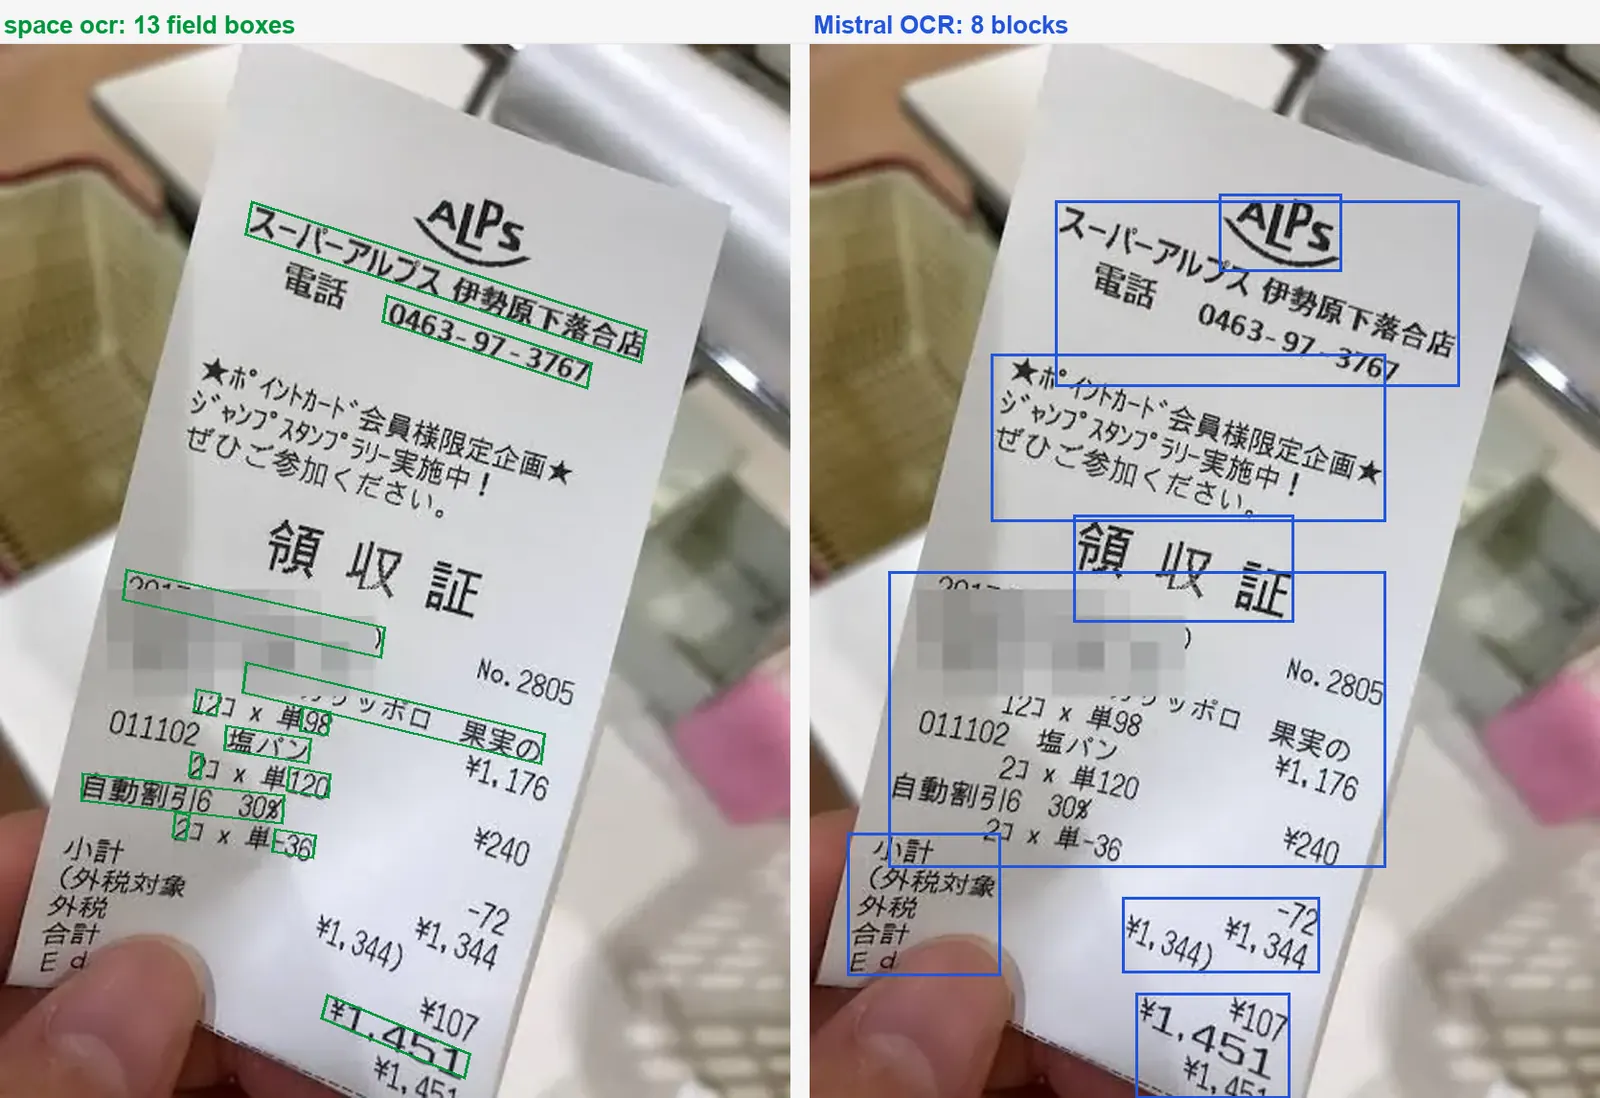
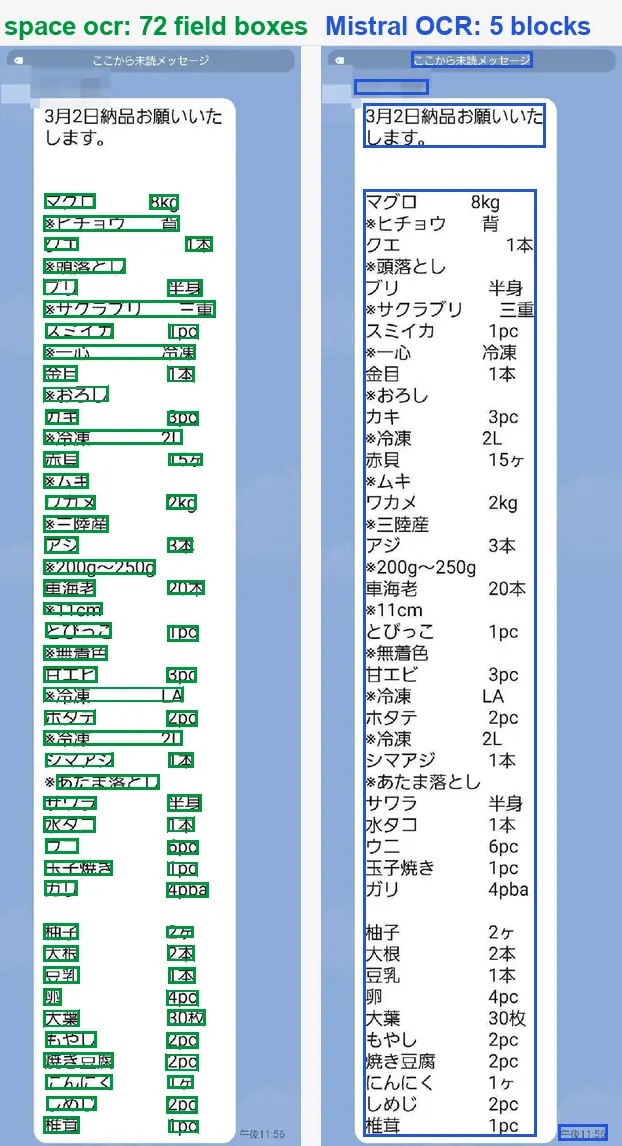
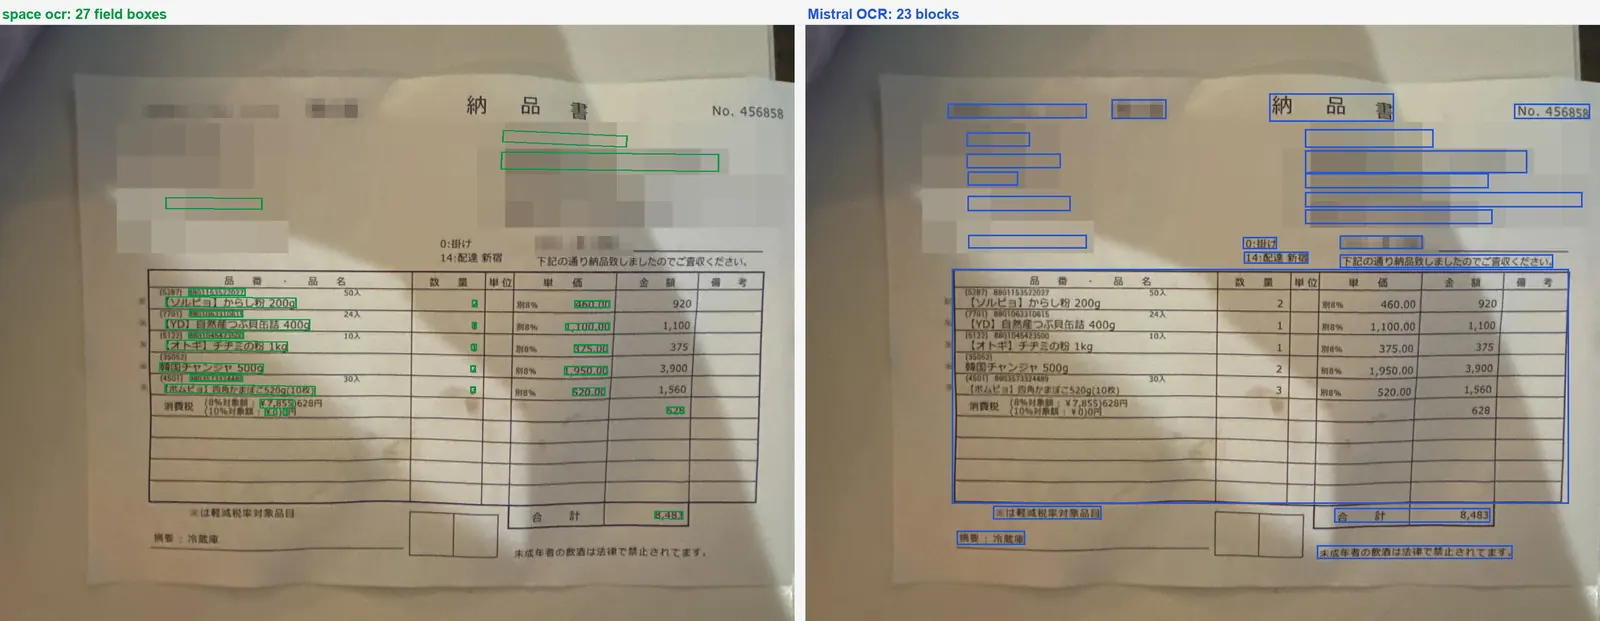
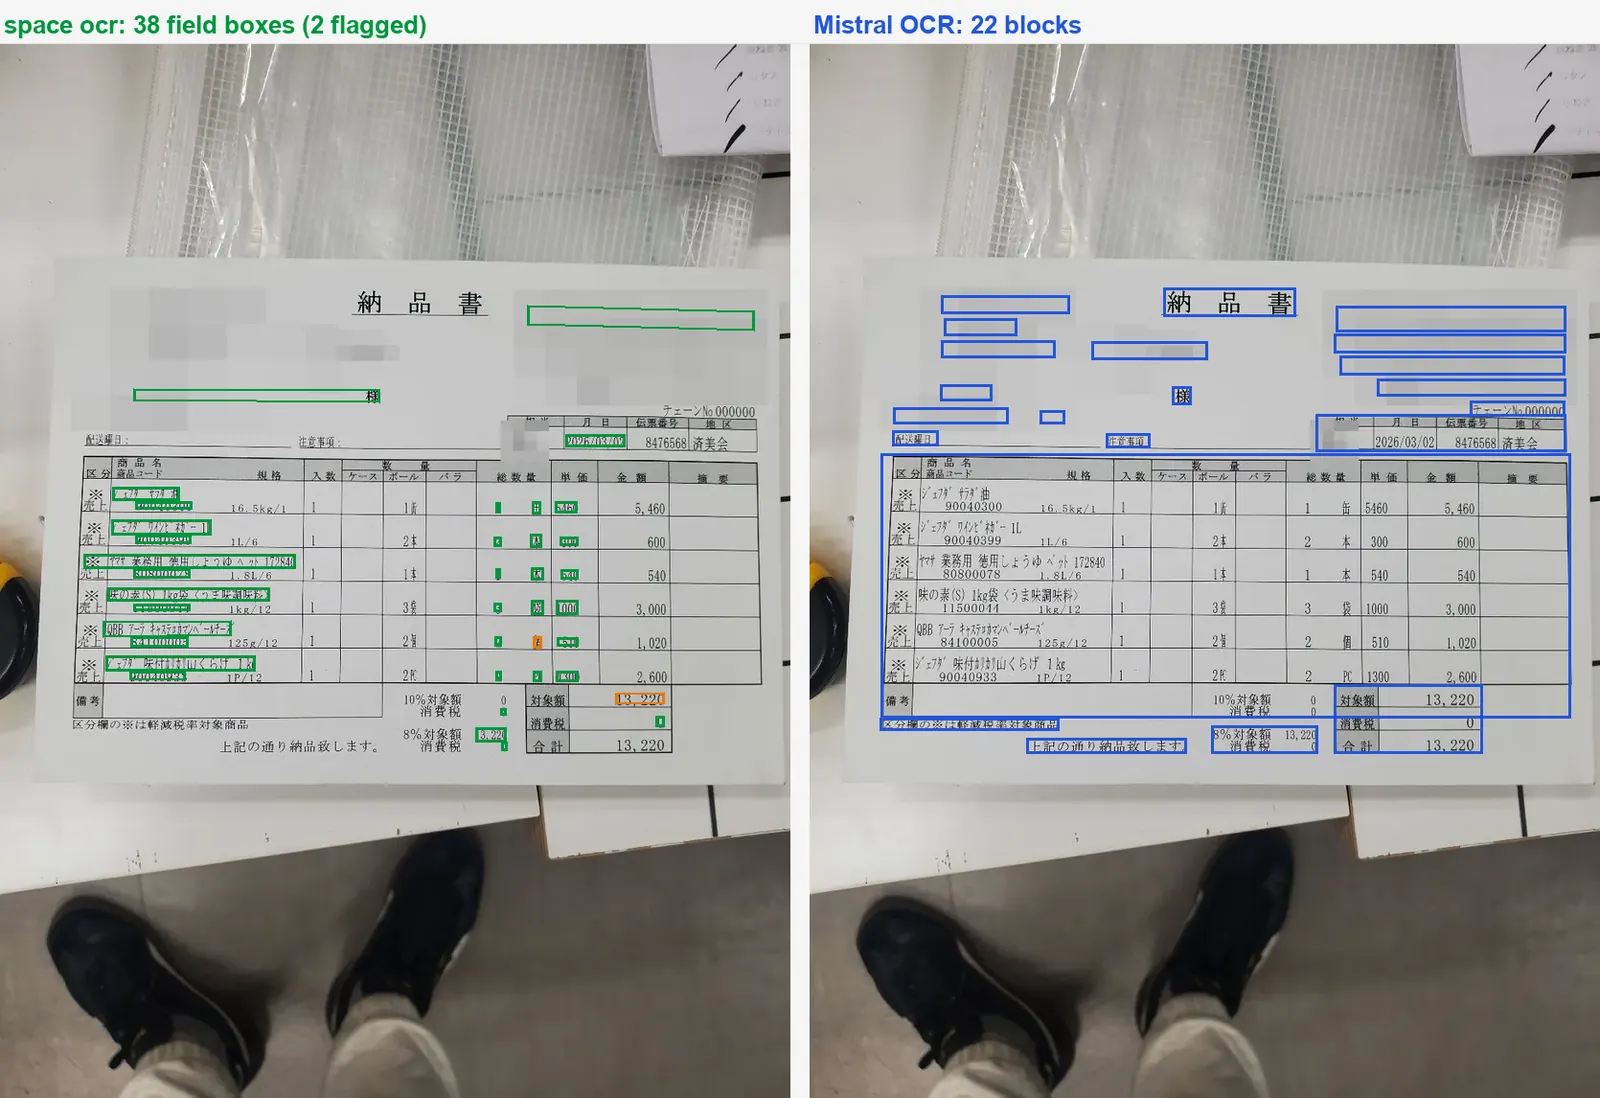
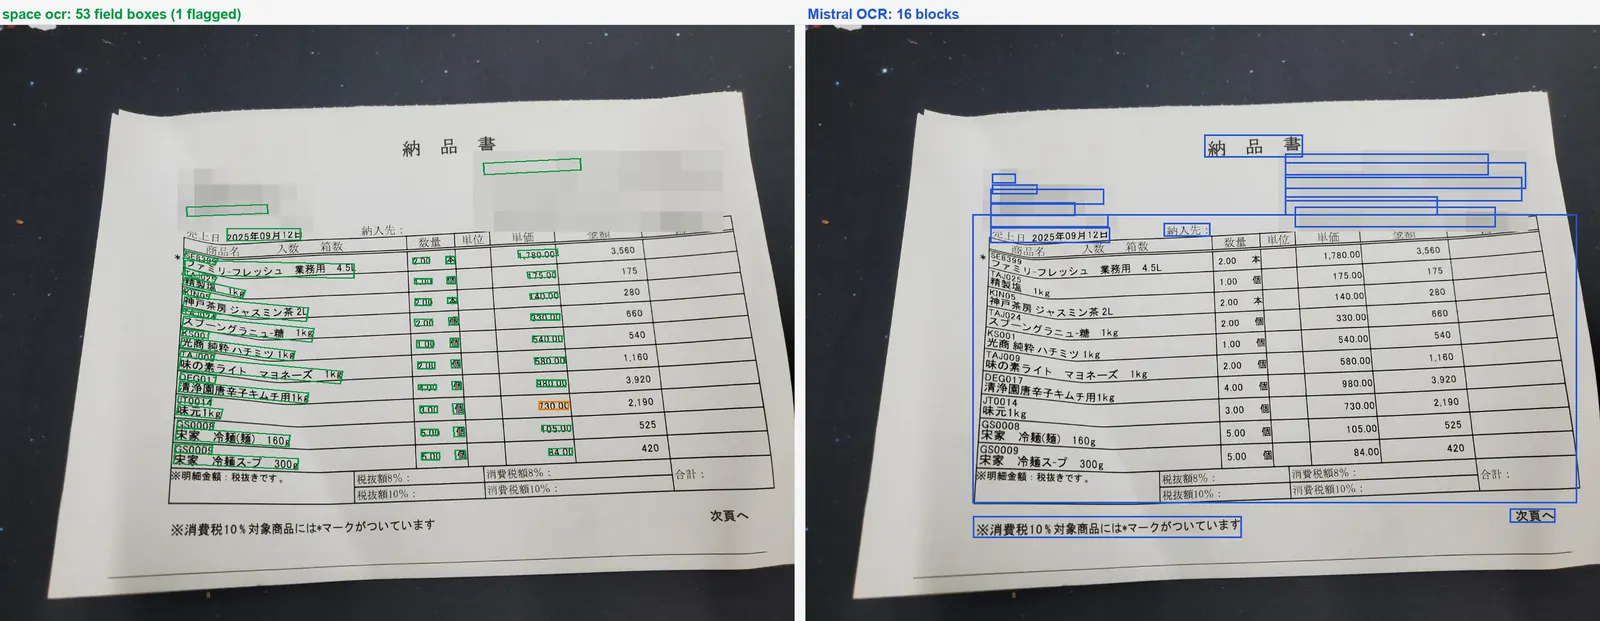
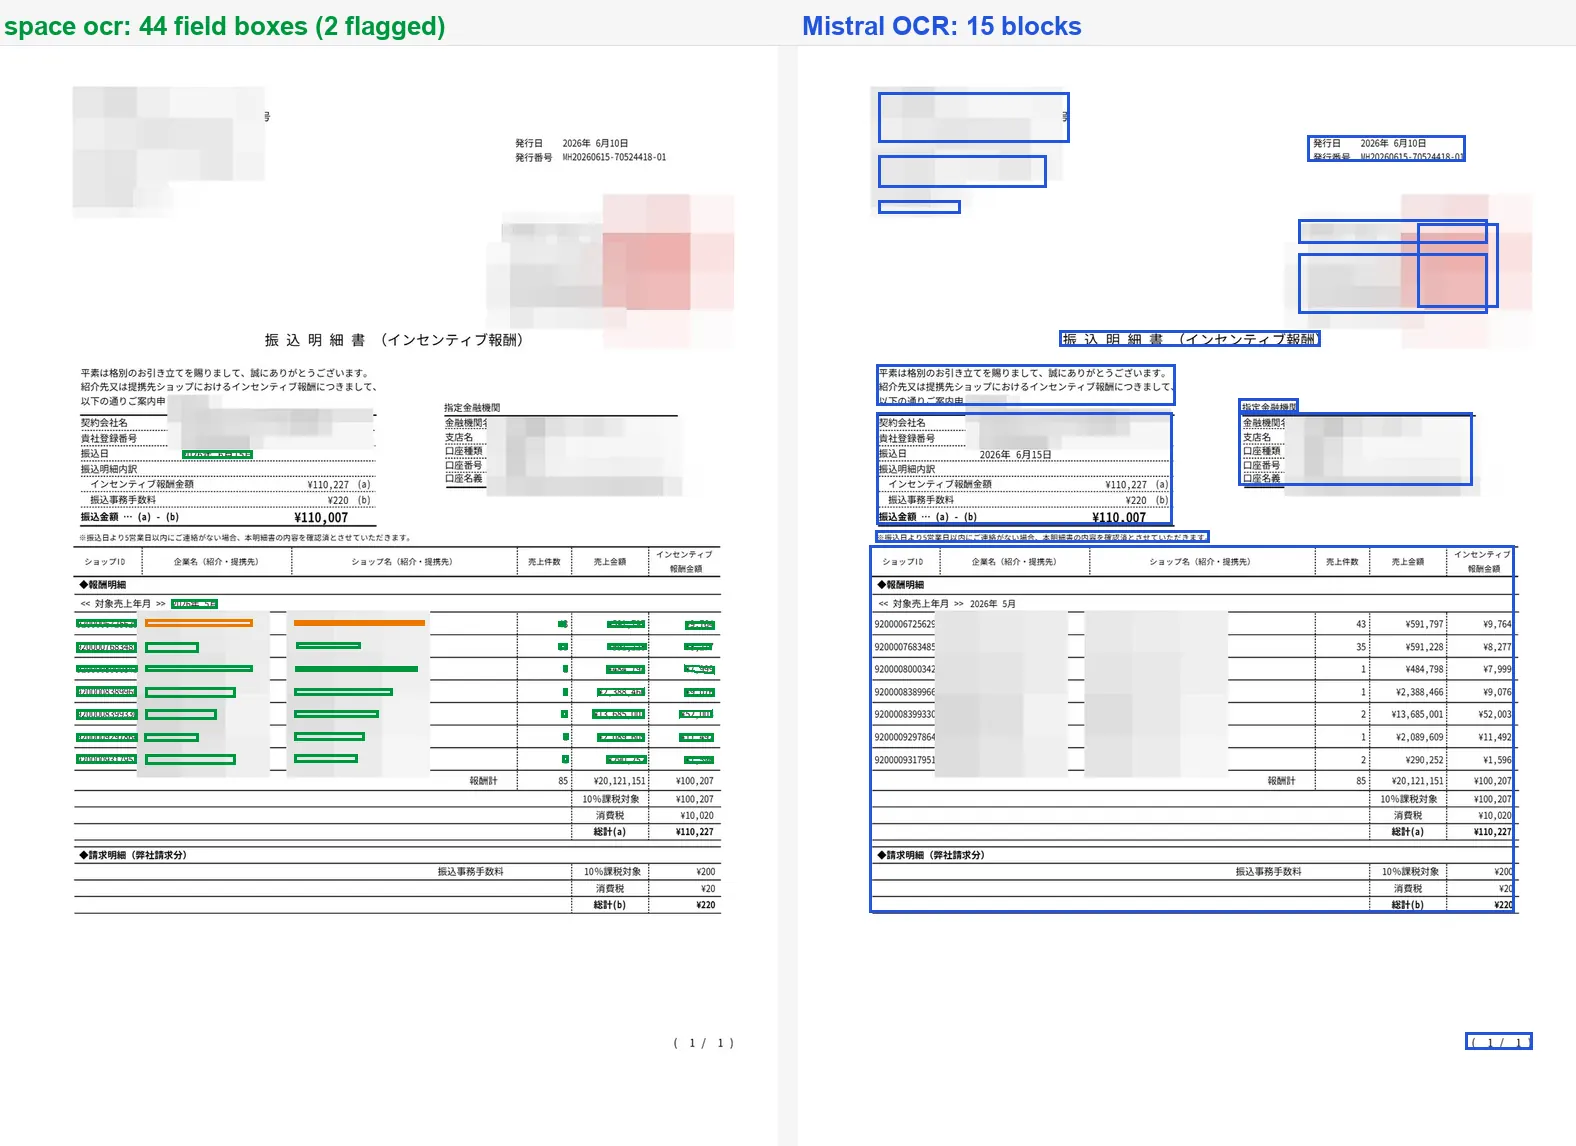
驗證怎麼運作,其實就是這篇文章的全部論點:語言模型只回傳值和詞級提示,從不產生座標。引擎再把每個回傳值與頁面上實際偵測到的字元逐字比對,把方框落在那些字元上,並用 evidence.match_ratio 為比對打分(0.85 以上算可信比對)。這個比值是支撐判定的證據之一,本身不是閘門:兩次讀法不一致時,review.reasons 會記下 text_mismatch 之類的原因代碼,verified 變成 false,該值進入需要查看的清單 data.review.flagged。座標按值回傳:box 是 0 到 1000 網格上的 xmin/ymin/xmax/ymax,quad 是四個有序頂點,用於傾斜的頁面。
這篇文章沒有量的東西
量的是 2026 年 8 月、8 個案例上的欄位抽取。沒量速度,沒量價格,也沒量 Mistral 的 markdown 轉換——那是做另一件事的另一個產品,本次任何一輪都沒有涉及。這也不是關於文件辨識的一般性結論:來自一家公司回歸組的 8 個案例是小樣本,而且是刻意挑刁鑽的,偏向日文商務表單與光線不佳的照片。
原始材料全部保留:執行腳本、評分過的 72 次執行、兩家廠商的原始回應,以及畫出上面這些圖的腳本。
不過最有用的基準仍然是你自己的。挑 5 份平時讓你頭痛的文件,先手寫標準答案,把同一份欄位清單送給兩個 API,各跑三次。下面的步驟就是我們的做法。一次成功掃描 $0.05,失敗不計費,每月前 100 頁免費,所以自己驗證一遍幾乎不花錢。
- 挑難啃的文件,不要展示樣張選5到10頁真正折磨人的:多行紀錄、重複的值、拍螢幕照片、密集表格。乾淨的樣張分不出廠商高下。
- 固定一套結構和指令欄位清單只寫一次,用同樣的名稱和描述原樣發給每個引擎。要求按印刷原樣返回值。
- 先手寫標準答案在跑任何東西之前,把每個欄位的期望值抄下來,之後不再修改。
- 每個引擎至少跑3輪只跑一輪會掩蓋不穩定。所有輪次用同一個腳本評分,看波動而不是只看平均。
- 單獨統計無聲的錯誤每個錯誤值都記下引擎是否給了標記。帶標記的錯值只花你一眼,沒有訊號的錯值花的是你在它上面搭的整個流程。