不必盲信的 AI OCR
space-ocr 用模型把文件結構化,再把每個值與頁面上 OCR 偵測到的文字比對。data.cells[path] 回傳 box、quad、verified 與 review,data.review.flagged 就是待複核清單。
AI OCR 聽起來像是雜亂文件的答案:把一張收據或發票交給模型,拿回乾淨的結構化欄位。問題在於模型出錯時會怎樣。語言模型不論是否真的從頁面上讀到,都會回傳一個自信、格式工整的值,而大多數工具把這個值交給你時,沒有讓你分辨真假的辦法。
space-ocr 把職責分開。結構化由多模態模型來做,但模型不產生座標;座標只來自讀取頁面的 OCR 環節。抽取出的值隨後與該環節偵測到的文字逐字比對。回傳的資料也這樣分開:業務資料按你宣告的 schema 放在 data.values,同一條路徑的 box、quad、判定 verified、review 理由與佐證 evidence 放在 data.cells[path]。底層具體用哪套 OCR 與模型實作屬於可變的實作細節,保持穩定的是回應結構。
看一次被核對過的 AI 輸出
把滑鼠移到下方任一欄位上——收據上的框是這個值在頁面上真正被找到的位置,而不是模型聲稱的位置。這裡的每個值、框與驗證標記,都直接讀自一次真實的解析結果,而不是擺拍。
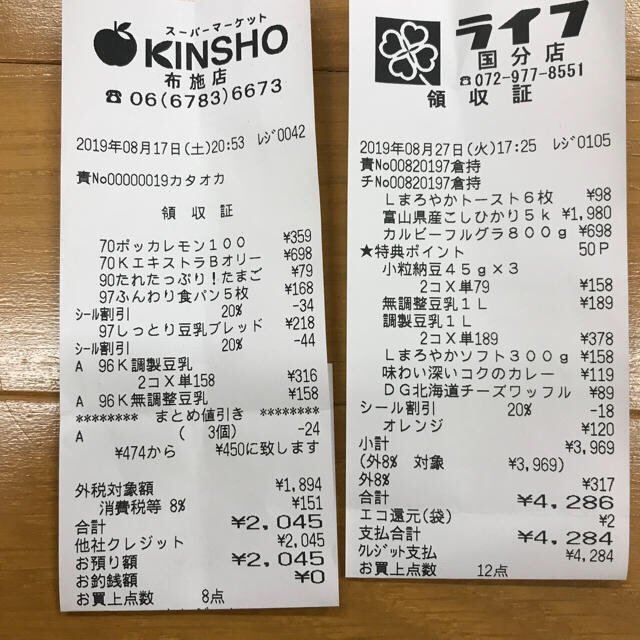
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocr 裡的 AI OCR 如何運作
把圖片送到 POST /ocr/fields,imageType 取 url 或 base64。先由 OCR 環節讀取頁面,這是座標的唯一來源。多模態模型再按你宣告的 schema 讀這份文件,而且只回傳值。把每個值與偵測到的文字逐字比對,才產生 data.cells[path] 裡的 box、quad 與 evidence。
verified 是判定,不是字元分數。只要該儲存格帶有任何類型的 review 理由就是 false;比對跑過且沒有任何標記時是 true;沒有可比對的對象時是 null。字元比對本身在 evidence.text_match。所以 verified: false 與 text_match: true 同時出現並不矛盾,而是「字對上了,但你宣告的規則攔下了它」這一正常組合。
這樣能讓原本悄悄溜過去的不一致浮出來,但並不承諾抓住所有錯誤。模型與 OCR 環節彼此獨立,仍可能在同一處誤讀上取得一致。座標是值來自何處的證據,而不是值正確的證明,所以業務端的檢核請繼續保留。
你不必寫 schema:宣告 fields,或開啟 autoFields 讓模型提出結構。Web 應用會先把 PDF 逐頁點陣化再讀取,公開 API 直接接收點陣圖像。
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/receipt.jpg",
    "imageType": "url",
    "fields": [
      { "name": "store_name", "type": "string", "required": true },
      { "name": "date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      {
        "name": "items",
        "type": "array",
        "children": [
          { "name": "name", "type": "string" },
          { "name": "amount", "type": "number" }
        ]
      }
    ]
  }'
如何執行可驗證的 AI OCR
- 傳送一份文件把圖片傳送到 /ocr/fields(imageType 取 url 或 base64)。在應用程式裡你可以拖入 PDF,每一頁會先被點陣化。公開 API 接收點陣圖像。
- 宣告 schema傳入帶 name、type、children 的 fields,或開啟 autoFields 讓模型提出結構。需要規則的地方補上 required、pattern、min、max、enum 或 near。
- 讀取被核對過的結果業務資料在 data.values,box、quad、verified、review、evidence 在 data.cells[path],已宣告純量型別的解析值在 data.normalized,換算像素的基準面在 data.image。
- 處理複核佇列走訪 data.review.flagged,把 reasons[0] 當作主要理由,並把該儲存格的 box 或 quad 畫到頁面上,讓複核的人看到這個值的來處。
- 儲存與查詢用 POST /create 和 POST /upload 把結果留在工作表裡,再用 GET /view 搭配 where、sort、select、limit 讀回來。這些讀取不收費,也不會重跑 OCR。
簡單、可預期的定價
1 點數 = 處理 1 頁 = $0.05(含稅),每月 100 點數免費,免信用卡。失敗不計費。讀取已儲存資料的 GET /space、GET /view、GET /jobs 不收費。方案計畫增加每月點數、更多工作表與儲存空間。