확인할 수 있는 데이터로 바꾸는 일본어 OCR
space-ocr로 일본어 영수증·청구서·납품서를 읽습니다. 혼합 스크립트와 전각·세로쓰기를 처리하고 깨지지 않는 CSV로 내보내며, 값은 data.values, 위치는 data.cells, 확인할 항목은 data.review.flagged 로 돌아옵니다.
일본어는 평범한 OCR이 조용히 무너지는 지점입니다. 영수증 한 장에 한자·가나·반각 가타카나·전각 숫자, 거기에 가끔 영어까지 섞이고, 합계는 오른쪽 가장자리 세로 칸에 적혀 있기도 합니다. 대부분의 도구는 먼저 언어를 고르게 하거나, 레이아웃을 잃은 평평한 텍스트 덩어리를 돌려줍니다. 정말 쓸모 있는 일본어 OCR은 그 모든 것을 한 번에 읽고, 각 숫자가 어디서 왔는지 알려줘야 합니다.
space-ocr는 둘 다 합니다. JP 문서를 읽어 구조화된 필드를 data.values 에 돌려주고, 모든 값을 페이지에서 읽어낸 정확한 위치와 함께 반환합니다 — data.cells[path] 에 박스·quad·판정·근거가 들어갑니다. 대조가 통과하지 못한 값은 data.review.flagged 에 작업 목록으로 놓이므로, 페이지를 다시 읽는 대신 짧은 대기열만 보면 됩니다. 설정할 언어는 없습니다. 일본어·한국어·중국어·영어를 한 엔진이 함께 처리합니다.
직접 검증할 수 있는 실제 일본어 추출
아래 어느 항목이든 마우스를 올려 보세요. 여기서 읽은 영수증 두 장은 실제 데이터입니다 — 합계 2,045의 KINSHO 布施店 영수증과 합계 4,286의 ライフ 国分店 영수증, 둘 다 2019년 8월 날짜입니다. 값과 박스는 모두 실제 파싱 결과에서 읽어온 것으로 목업이 아니며, 박스는 한자·가나·숫자가 섞인 각 줄을 따라갑니다. 행 옆에 보이는 문자 일치 수치는 보조 근거이지 합격선이 아닙니다.
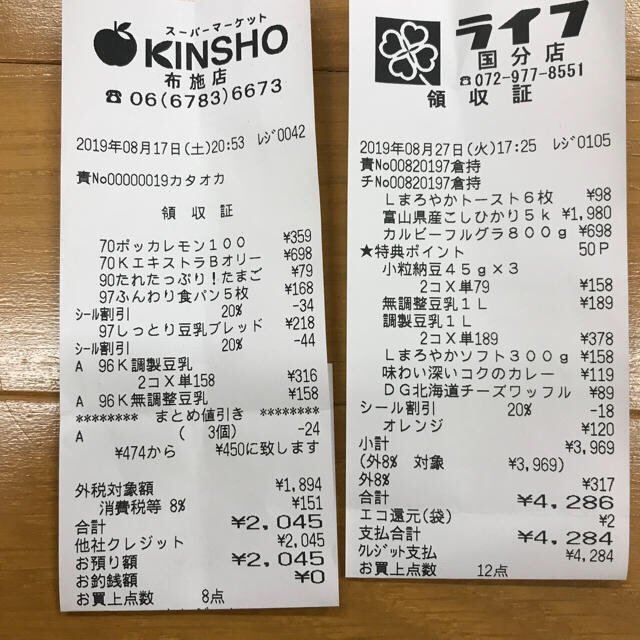
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocr의 일본어 OCR 작동 방식
모델은 좌표를 만들지 않습니다. 문서를 읽어 값을 반환하고, 그다음 문자 매처가 그 문자를 OCR이 페이지에서 실제로 검출한 심볼과 대조합니다. 이 대조가 박스·quad·각 셀의 근거를 만듭니다. verified 는 review 의 거울이 되는 판정입니다 — 사유가 하나라도 붙으면 false, 대조가 돌고 아무것도 서지 않으면 true, 대조할 것이 없으면 null 입니다. 문자 대조 자체는 evidence.text_match 에 있고, evidence.match_ratio 는 문자 커버리지를 알려주는 보조 근거일 뿐 합격선이 아닙니다. 두 엔진이 같은 오독에 합의할 수도 있으므로, 이 대기열은 먼저 볼 자리를 알려줄 뿐 보증은 아닙니다.
앱에 PDF를 끌어다 놓으면 각 페이지가 먼저 이미지로 렌더링된 뒤 읽힙니다 — 여러 페이지 청구서나 납품서에 편리합니다. API를 직접 호출한다면 래스터 페이지 이미지를 URL 또는 base64 로 보내면 되고, 돌아오는 구조화 결과는 동일합니다. 필요한 fields 를 선언하거나 autoFields: true 를 보내 제안받으세요. 품목 행은 children 을 가진 array 필드로 기술하고 items[0].amount 로 지칭합니다.
선언은 추출 뒤에 검사되고 모델에는 전달되지 않습니다. 즉 판독이 아니라 검토 신호를 바꿉니다. type: "date" 는 결정론적인 data.normalized 층을 더해 令和8年8月16日 을 2026-08-16 으로 해석하고 data.values 는 인쇄된 표기를 그대로 둡니다. type: "number" 는 ¥13,220 을 13220 으로 바꿉니다. pattern 은 전각을 접은 값에 대조하므로 전각으로 인쇄된 등록번호에도 ^T[0-9]{13}$ 가 통합니다. 일본 장표에서 자주 생기는 당사자 혼동에는 수신처에 御中·様 을 near 로, 登録番号 / TEL / 〒 를 not_near 로 선언하십시오. 잘못 고른 값이 조용히 통과하지 않고 near_mismatch 나 near_conflict 로 드러납니다. 수량 칸의 一式, 지불기한의 翌月末払い 처럼 값이 아닌 표기가 정식으로 인쇄되는 항목은 string 으로 두세요 — 타입을 선언하면 서류가 맞는데도 매번 검토 목록에 오릅니다.
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/invoice-jp.jpg",
    "imageType": "url",
    "fields": [
      { "name": "issuer", "type": "string", "required": true,
        "near": ["登録番号", "TEL", "〒"] },
      { "name": "bill_to", "type": "string",
        "near": { "terms": ["御中", "様"], "match": "suffix" },
        "not_near": ["登録番号", "TEL"] },
      { "name": "registration_no", "type": "string", "pattern": "^T[0-9]{13}$" },
      { "name": "issue_date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      { "name": "items", "type": "array", "children": [
        { "name": "name", "type": "string" },
        { "name": "qty", "type": "string" },
        { "name": "amount", "type": "number" }
      ] }
    ]
  }'
일본어 문서를 OCR하는 방법
- 문서 추가앱에 영수증·청구서·PDF를 끌어다 놓으면 각 페이지가 이미지로 렌더링되어 OCR 대기열에 들어갑니다. API에서는 래스터 페이지 이미지(url 또는 base64)를 /ocr/fields 에 보냅니다. 언어 설정은 없습니다.
- 필드 선언필요한 fields 를 나열하거나 autoFields: true 를 보내 스키마를 제안받습니다. 품목 표에는 children 이 있는 array 필드를 쓰고, 문서가 지지하는 범위에서 type·pattern·near·not_near 를 더합니다.
- 구조화 결과 읽기업무 데이터는 data.values 에 있습니다. data.cells[path] 에는 box·quad·verified·review·evidence 가 들어가고, 그 좌표의 기준 지면이 data.image, 선언한 스칼라 타입의 해석값이 data.normalized 입니다.
- 검토 대기열 처리data.review.flagged 를 순회합니다. 각 항목은 path 와, 랭킹 순으로 첫 항목이 대표인 reasons 배열을 갖고, flagged.length 가 확인할 건수입니다. 해당 셀을 열면 그 값을 읽어낸 영역이 강조됩니다.
- 내보내기 또는 조회CSV(UTF-8 BOM이라 일본어가 깔끔하게 열림, 품목 펼쳐짐)를 다운로드하거나, 저장된 시트를 GET /view 로 where·sort·select 를 써서 읽습니다 — 저장된 행을 읽는 데 OCR은 다시 돌지 않고 GET /view 는 과금되지 않습니다.
단순하고 예측 가능한 가격
1크레딧 = 1페이지, ₩100(부가세 포함)이며 매월 100크레딧이 무료이고 신용카드는 필요 없습니다. 실패는 과금하지 않습니다. 정액 플랜은 월 크레딧·시트·저장공간을 추가합니다.