텍스트 더미가 아니라 구조화 필드를 돌려주는 이미지 OCR
space-ocr로 JPEG·PNG 등 이미지를 OCR하세요. 필요한 필드를 선언하면 값마다 box·quad 좌표가 붙고, 확인이 필요한 값은 data.review.flagged 목록으로 돌아옵니다.
대부분의 이미지 OCR은 평범한 텍스트 덩어리를 던져주고 거기서 멈춥니다. 영수증을 찍어 돌려도 돌아오는 건 줄들의 묶음이라, 결국 읽고, 나누고, 맞는 열에 다시 입력하게 됩니다. 페이지에서는 한눈에 들어오던 구조가 사라져 버리죠.
space-ocr는 이미지를 구조화 필드로 읽어냅니다 — 상호는 여기, 날짜는 저기, 합계는 저쪽, 품목은 행으로. 값에는 이미지에서 읽어낸 정확한 위치가 함께 옵니다. 축에 정렬된 box 와 네 점짜리 quad 가 data.cells[path] 에 담기기 때문입니다. 그리고 지면과 대조가 어긋난 값은 사유와 함께 data.review.flagged 에 올라옵니다. 그냥 믿어야 하는 숫자가 아니라, 확인할 작업 목록이 돌아오는 셈입니다.
직접 검증할 수 있는 실제 추출 결과
이건 한 장의 이미지 — 영수증 두 개를 찍은 사진 — 를 필드로 읽은 것입니다. 아래 어느 값이든 마우스를 올리면, 이미지 위의 박스가 그 값을 읽어낸 지점입니다. 여기 있는 숫자·박스·문자 일치율은 모두 실제 파싱 결과에서 읽어온 것으로, 목업이 아닙니다. 일치율은 값의 문자를 지면에서 얼마나 찾아냈는지 보여 주는 보조 근거이며, 합격·불합격을 가르는 기준값이 아닙니다.
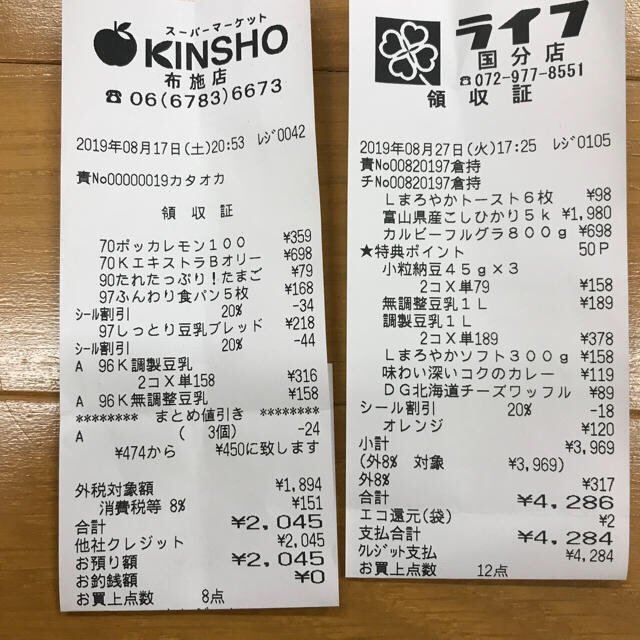
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocr의 이미지 OCR 작동 방식
이미지를 URL 또는 순수 base64로 /ocr/fields 에 보냅니다 — JPEG·PNG·GIF·BMP·TIFF·WebP 가 그대로 읽힙니다. EXIF orientation 은 판독 전에 반영되고, 아주 큰 사진은 긴 변 4000px 까지 축소될 수 있습니다. 실제로 읽은 지면의 크기는 data.image 가 돌려주므로 좌표는 이 크기를 기준으로 환산합니다.
원하는 결과는 fields 배열로 기술합니다. 필드마다 name 과 type(string / number / integer / date / array / object)을 주고, 품목 표에는 children 을 가진 array 필드를 쓰며, 필요하면 required·pattern·min/max·enum 을 선언합니다. 문서에서 출발하고 싶다면 autoFields: true 를 보내고 돌아온 필드 이름부터 쓰면 됩니다. 선언은 모델에 전달되지 않아 판독 자체를 유도하지 않습니다. 선언이 정하는 것은 data.review.flagged 에 무엇이 오르는지, 그리고 결정론적인 data.normalized 층이 무엇을 해석하는지입니다. (PDF 는 웹 앱을 거쳐 각 페이지를 먼저 이미지로 렌더링합니다. API 자체는 이미지를 읽습니다.)
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/receipt-photo.jpg",
    "imageType": "url",
    "fields": [
      { "name": "store_name", "type": "string", "required": true },
      { "name": "date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      {
        "name": "items",
        "type": "array",
        "children": [
          { "name": "name", "type": "string" },
          { "name": "price", "type": "number" }
        ]
      }
    ]
  }'
이미지를 OCR하는 방법
- 이미지 보내기JPEG·PNG·GIF·BMP·TIFF·WebP를 /ocr/fields에 URL 또는 순수 base64로 보내거나, 앱에 끌어다 놓습니다. EXIF 방향은 판독 전에 반영됩니다.
- 필드 선언하기값마다 name 과 type 을 적은 fields 배열을 보냅니다 — 품목 표에는 children 이 있는 array 필드를 씁니다. autoFields 를 true 로 두고 돌아온 필드 이름부터 시작해도 됩니다.
- 구조화 결과 읽기업무 데이터는 data.values 에 담깁니다. data.cells 는 경로마다 box·quad 와 verified 판정, evidence 를 돌려주고, data.image 가 그 좌표를 픽셀로 환산하는 기준이 됩니다.
- 검토 목록 처리하기data.review.flagged 를 순회합니다. 항목마다 path 와 reasons 가 있으니 cells[path] 를 열어 이미지 위에 box 를 그리고, 인쇄된 글자와 값을 맞춰 봅니다. 수정 사항은 원본 OCR 값 옆에 저장됩니다.
- 내보내기 또는 조회CSV(UTF-8 BOM, 품목 펼쳐짐)를 다운로드하거나, 저장된 시트를 GET /view로 where·sort·select를 써서 조회합니다 — 저장된 행을 읽는 것만으로는 OCR 재실행도 과금도 없습니다.
단순하고 예측 가능한 가격
이미지당 ₩100(부가세 포함), 신용카드 없이 매월 100크레딧 무료입니다. 실패는 과금하지 않습니다. 정액 플랜은 월 크레딧 수·시트·저장공간을 추가합니다.