감사 추적이 가능한 문서 OCR
대부분의 OCR은 그냥 믿을 수밖에 없는 텍스트만 돌려줍니다. space-ocr는 모든 값을 출처와 함께 반환합니다. data.cells[path] 에 box·quad 좌표와 대조 근거인 evidence 가 붙고, 사람이 확인해야 할 경로는 data.review.flagged 에 모입니다.
문서에서 데이터를 뽑아내는 건 데모로 보여주기는 쉽지만 신뢰하기는 어렵습니다. 모델이 청구서를 읽고 total: 2,045 를 돌려주면, 그 어떤 신뢰도 점수로도 시원하게 답이 안 나오는 질문 하나가 남죠. 이게 정말 페이지에 인쇄된 숫자일까, 아니면 모델이 만들어낸 값일까? 한 번 슬쩍 조회하는 정도라면 상관없습니다. 하지만 회계, 보험 청구 처리, 컴플라이언스처럼 나중에 감사를 받게 되는 업무라면 "모델을 믿어라"는 건 통제 수단이 아닙니다.
감사 추적(audit trail) 이 이 문제를 해결합니다. 값만 덜렁 돌려주는 게 아니라, 모든 필드가 검증된 페이지 위치와 함께 돌아옵니다. 그래서 사람이든 다른 시스템이든 그 값이 읽힌 정확한 픽셀로 바로 이동해 직접 확인할 수 있죠. 이게 바로 그냥 답과, 근거를 댈 수 있는 답의 차이입니다.
직접 확인해 보세요: 모든 값이 원본으로 거슬러 갑니다
아래 필드 위에 마우스를 올려 보세요. 영수증에 표시되는 박스가 바로 그 값이 읽힌 위치이고, 각 필드는 그 위치와 함께 자신의 검토 상태를 가지고 있습니다.
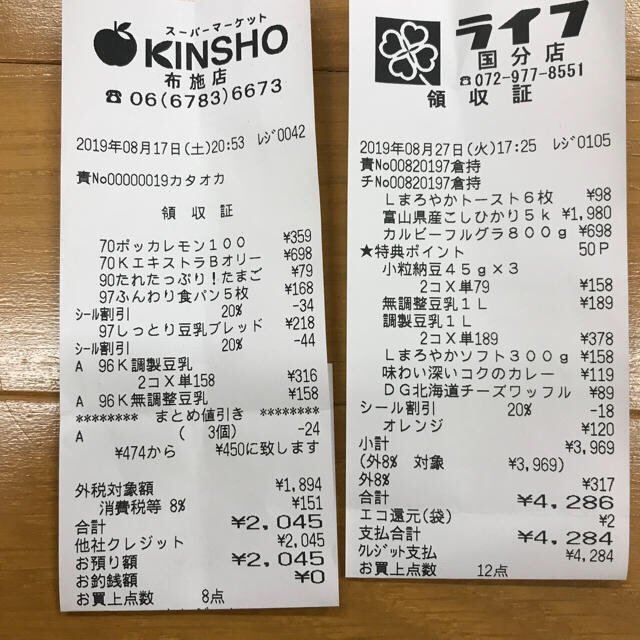
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
"검증된 값"이 실제로 담고 있는 것
근거를 댈 수 있는 결과란 숫자 하나에 점수 하나를 붙인 것이 아닙니다. POST /ocr/fields 는 답을 따로 저장하고 조회하고 인용할 수 있는 층으로 갈라서 돌려줍니다.
data.values— 무엇을 읽었는가. 요청한 스키마 그대로이고 예약 키가 섞이지 않아 그대로 데이터베이스에 넣을 수 있습니다.data.cells[path].box와.quad— 어디서 읽었는가.box는{ xmin, ymin, xmax, ymax }축 정렬 사각형으로 0–1000 정규화 격자(0,0 = 좌상단, 1000,1000 = 우하단) 위에 놓입니다.quad는 순서가 정해진 네 점이고, 기울기 보정을 하지 않으므로 페이지의 기울기를 그대로 따라갑니다. 경로 문법은 전 구간 공통입니다 —total,items[0].price.data.cells[path].evidence— 어떤 근거가 있었는가.text_match가 문자 대조 자체이고,source는 좌표가 어떤 경로로 풀렸는지 알려줍니다.match_ratio는 그 값의 글자 중 페이지에서 위치가 확인된 비율이며(0.85 이상이면 확신 매칭),printed_text는 그 좌표에서 OCR 이 읽은 글자라values와 정확 일치로 대조할 때 씁니다.data.cells[path].verified와.review— 사람 없이 수용해도 되는가.verified는 문자 점수가 아니라 판정입니다.review에 사유가 하나라도 실리면false, 대조가 돌았고 아무것도 서지 않았으면true, 아무것도 서지 않았는데 대조할 상대가 없었으면null입니다(행 유니언은 기하 정보만 갖습니다).review.reasons는 길이가 1이어도 배열이고 랭킹 순이라 0번이 대표 사유입니다.data.review.flagged— 사람이 볼 작업 목록. 항목은{ path, reasons }한 쌍이고, 확인할 건수는flagged.length그 자체입니다.data.normalized— 인쇄된 표기와 계산에 쓸 값의 분리. 스칼라 타입(또는pattern·enum을 준 string)을 선언한 필드가 있을 때만 붙고, 같은 읽기를 그 타입으로 해석해values는 건드리지 않은 채 옆에 놓습니다.
위치와 근거가 값을 따라다니기 때문에 결과는 블랙박스가 아닙니다. 박스를 그리거나, 경로와 좌표를 인용하거나, 표시된 필드를 OCR 재실행 없이 다시 확인할 수 있습니다.
좌표는 모델 말만 믿고 정하지 않습니다. 언어 모델은 각 값의 텍스트와, 어떤 단어 토큰을 사용했는지에 대한 힌트만 반환할 뿐 박스 자체는 절대 내놓지 않습니다. 그러면 엔진이 그 텍스트를 비전 OCR이 페이지에서 실제로 검출한 심볼과 글자 단위로 대조합니다. 그래서 박스는 그 글자들이 실제로 발견된 진짜 픽셀 위에 떨어지고, 각 값에는 매칭 비율(match ratio) — 글자 중 실제로 위치가 확인된 비율 — 이 매겨집니다. 모델의 토큰 힌트는 노이즈가 섞일 수 있어서(반복되는 행끼리 힌트가 뒤바뀌기도 합니다) 무턱대고 믿지 않고, 열·행 일관성 검사로 검증합니다. 핵심은 AI가 틀릴 수 없다는 게 아니라, 페이지와 어긋나는 값이 조용히 통과하지 않고 검토 대상으로 드러난다는 것입니다. 대조할 상대가 없었던 항목 — 행 유니언은 기하 정보만 갖습니다 — 은 통과했다고 말하는 대신 verified: null 로 보고합니다.
값을 클릭하면 픽셀로 바로 이동
앱에서는 이게 하나의 상호작용이 됩니다. 셀을 클릭하면 원본 이미지에서 그 값이 나온 정확한 박스가 강조되고, 확대된 크롭과 연결선이 함께 표시되죠. 배치 작업을 빠르게 점검하기에 이만한 방법이 없습니다. 문서 전체를 훑을 필요 없이 시선이 곧장 해당 지점으로 향하니까요.
수정 내역도 감사할 수 있습니다
감사 추적은 기계가 내놓은 출력만의 이야기가 아닙니다. 사람이 무엇을 바꿨는지도 포함됩니다. 셀을 수정하면 space-ocr는 여러분의 수정 내용을 원본 OCR 값과 별도로 저장합니다. Original 툴팁이 엔진이 처음 읽은 값을 항상 보여주므로, 검토자는 기계가 읽은 값과 사람이 덮어쓴 값을 나란히 비교할 수 있습니다.
API에서도, 모든 값에 들어 있습니다
이건 UI에만 있는 기능이 아닙니다. POST /ocr/fields 가 반환하는 data.cells 는 total, items[0].price 같은 경로를 키로 쓰는 flat 맵이고, 항목마다 box, quad, verified, review, evidence 가 들어 있습니다. data.review.flagged[].path 도 같은 문법이라, 검토 목록의 항목에서 그 좌표로 바로 찾아갈 수 있습니다. 저장된 시트를 GET /view 로 조회하면 이 맵이 기본으로 함께 옵니다. boxes=0 을 붙이면 빠지는 것은 행의 cells 맵뿐이고, values·review·image 는 그대로 돌아옵니다.
{
  "status": "success",
  "data": {
    "values": {
      "total": "2,045",
      "items": [
        { "qty": "2", "price": "780" }
      ]
    },
    "cells": {
      "total": {
        "box": { "xmin": 595, "ymin": 974, "xmax": 781, "ymax": 1000 },
        "quad": [
          { "x": 594, "y": 975 }, { "x": 781, "y": 972 },
          { "x": 781, "y": 998 }, { "x": 595, "y": 1000 }
        ],
        "verified": true,
        "review": null,
        "evidence": {
          "text_match": true,
          "source": "vision_symbol_match",
          "match_ratio": 1.0,
          "printed_text": "2,045"
        }
      },
      "items[0].price": {
        "box": { "xmin": 693, "ymin": 640, "xmax": 781, "ymax": 668 },
        "quad": [
          { "x": 693, "y": 641 }, { "x": 781, "y": 640 },
          { "x": 781, "y": 667 }, { "x": 693, "y": 668 }
        ],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": {
          "text_match": false,
          "source": "vision_symbol_match",
          "match_ratio": 0.67,
          "printed_text": "180"
        }
      }
    },
    "review": {
      "unit": "field",
      "flagged": [
        { "path": "items[0].price", "reasons": ["text_mismatch"] }
      ],
      "by_reason": { "text_mismatch": 1 }
    },
    "normalized": { "total": 2045 },
    "image": { "width": 1654, "height": 2339 }
  }
}
evidence.source 는 각 좌표가 어떻게 풀렸는지 알려줍니다. vision_symbol_match 는 일반적인 문자 대조 경로이고 그 match_ratio 를 함께 싣습니다. token_id 는 단어 토큰 힌트가 쓰였다는 뜻입니다. 로그로 남기거나, 필터링하거나, 검토자에게 보여줄 수 있는 메타데이터입니다. 약한 매칭은 이 키 안에 숨지 않습니다. review.reasons 에 low_ratio·weak_source·low_ocr_confidence 같은 코드로 표면화되고, 같은 경로가 data.review.flagged 에도 섭니다. 사유 코드는 API 계약 어휘이니 코드로 분기하고, 아직 모르는 코드에는 범용 문구를 띄우도록 만들어 두세요.
실무에서 값을 검증하는 방법
- 추출 결과 열기시트를 열거나 GET /view 를 호출하세요. 각 값은 경로로 지정되고, data.cells[path] 에 box, quad, review, evidence 가 들어 있습니다.
- 값 클릭하기셀을 클릭하면 그 값이 읽힌 원본 이미지의 정확한 영역이 강조됩니다.
- 근거와 검토 목록 확인하기match_ratio 가 1.0이면 모든 글자의 위치가 확인됐다는 뜻이고, 0.85 이상이면 확신 매칭으로 봅니다. 엔진이 결론짓지 못한 값은 low_ratio, text_mismatch 같은 사유와 함께 data.review.flagged 에 섭니다.
- 필요하면 수정하기셀을 수정해 값을 덮어쓰세요. 원본 OCR 값은 감사 추적을 위해 Original 툴팁 아래에 그대로 보존됩니다.