송장에서 데이터를 추출하는 API
송장 데이터 추출을 위한 space-ocr API 개발자 가이드. curl·Python으로 호출하는 POST /ocr/fields, fields 스키마 선언과 autoFields, 값마다 붙는 출처 좌표(box·quad)와 review 계약까지.
송장에서 구조화된 데이터를 뽑아내는 일 — 거래처, 송장 번호, 날짜, 항목 합계, 세금 — 은 문서 자동화에서 가장 흔하면서도 직접 만들기엔 가장 번거로운 작업 중 하나입니다. OCR 텍스트에 정규식을 거는 방식은 거래처가 레이아웃을 바꾸는 순간 무너집니다. 템플릿 매칭 도구는 공급처마다 일일이 박스를 그려달라고 요구하죠. 정작 필요한 건 어떤 레이아웃이든 읽어내고, 깔끔하게 타입이 지정된 필드를 돌려주며, 무엇보다 각 값이 페이지의 어디에서 나왔는지 알려줘서 결과를 신뢰할 수 있게 해주는 송장 데이터 추출 API입니다.
바로 그 마지막 부분이 핵심입니다. total: 2,045만 던져주고 출처는 알려주지 않는 송장 추출 엔드포인트는 매입 처리(AP) 파이프라인에서 오히려 부담입니다. 이 가이드에서는 space-ocr의 POST /ocr/fields 엔드포인트를 차근차근 살펴봅니다. 송장 이미지 하나를 받아 선언한 필드 스키마(또는 autoFields 자동 제안)를 적용하고, 모든 값을 출처 좌표와 명시적인 검증 판정과 함께 돌려주는 단일 동기 호출입니다.
코드 한 줄 쓰기 전에 결과부터 확인하세요
아래는 실제로 파싱한 영수증입니다. 아무 필드에나 마우스를 올리면 이미지 위의 해당 박스가 밝아집니다 — 그 박스가 바로 값이 읽힌 위치이고, 각 값은 자신의 검증 판정과 근거를 함께 가지고 있습니다. 송장도 똑같이 동작합니다. 추출한 모든 필드가 자신이 비롯된 픽셀 위로 정확히 되돌아옵니다.
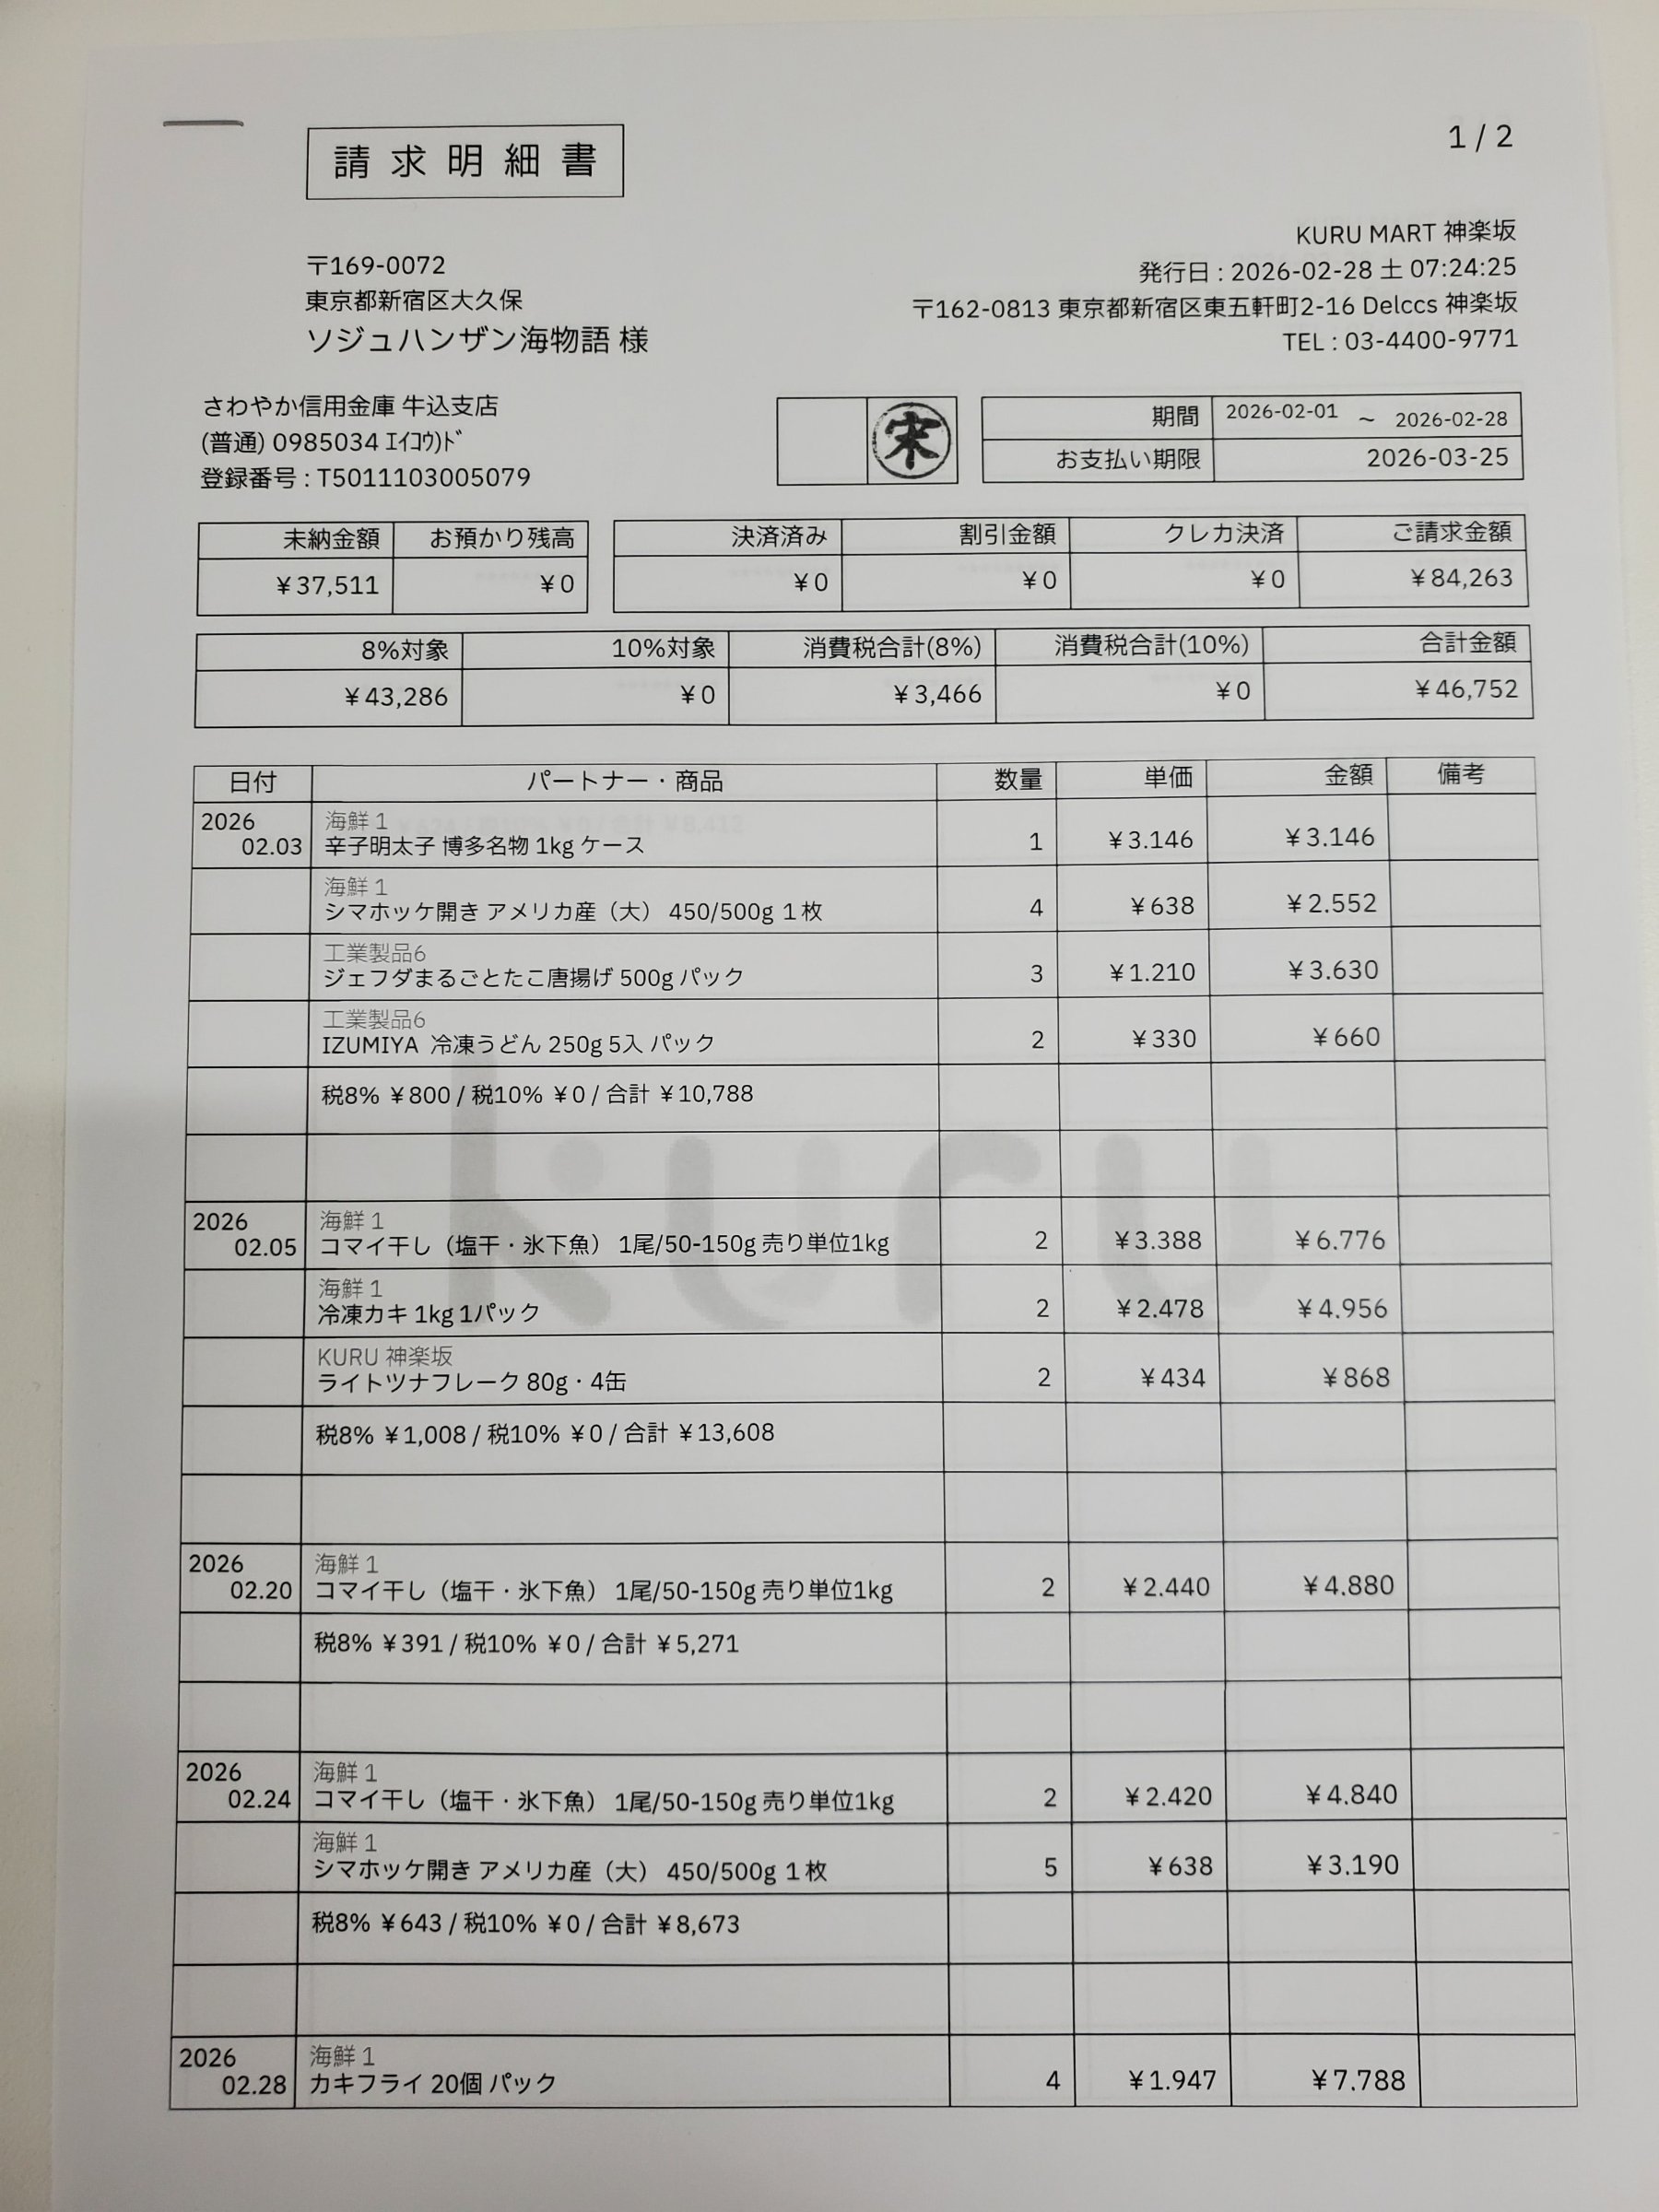
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
인증과 베이스 URL
공개 API는 단일 베이스 — https://api.space-ocr.com — 에 있으며 /v1 같은 경로 버전 표기는 없습니다. 모든 요청은 spocr_ 접두사가 붙은 키로 HTTP Bearer 토큰 인증을 합니다.
Authorization: Bearer spocr_xxxxxxxxxxxxxxxx키가 없거나 유효하지 않으면 401 (error.code: "invalid_api_key") 을 반환합니다. 403 은 뜻이 다릅니다 — 키 자체는 유효하지만 그 키의 권한 밖 리소스(예: 다른 키가 만든 job)에 접근한 경우입니다. 모든 응답에는 지원 문의 추적을 위해 로그로 남겨둬야 할 X-Request-Id 헤더(형식 req_xxx)가 실려 옵니다. 직접 클라이언트를 생성하고 싶다면 전체 명세가 GET /openapi.json 에서 OpenAPI 3.1로 공개되어 있습니다.
가장 간단한 호출: 명시적인 송장 스키마
가장 빠른 길은 원하는 필드를 직접 이름 붙이는 것입니다. fields 에 FieldSpec 객체 배열을 넘기면 응답은 그 선언과 똑같은 모양으로 돌아옵니다 — 고를 템플릿도, 그릴 박스도 없습니다. imageType 은 필수 파라미터로, image 를 어떤 형태로 넘기는지 "url" 또는 "base64" 로 명시합니다.
스칼라 타입 선언은 의도 표기 이상의 일을 합니다. invoice_date 를 "date" 로, 금액 항목을 "number" 로 선언하면 원본 판독값 옆에 결정론적인 data.normalized 층이 붙습니다. invoice_no 의 required: true 는 값이 비었거나 아예 빠졌을 때 조용한 빈 문자열로 통과시키지 않고 검토 목록에 올린다는 뜻입니다. pattern 은 자사의 채번 규칙이며, JSON Schema 와 같은 부분 일치라서 값 전체를 보려면 ^…$ 로 감싸면 됩니다.
아직 무엇을 선언해야 할지 모르겠다면 fields 없이 autoFields: true 를 보내면 모델이 문서에서 스키마를 제안합니다. 처음 보는 거래처 양식을 탐색할 때 적합한 경로이고, 필드 이름이 정해지면 명시적인 fields 배열로 옮겨 호출마다 응답 모양이 흔들리지 않게 하세요.
curl -X POST https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer spocr_xxxxxxxxxxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/invoices/inv-4471.jpg",
    "imageType": "url",
    "fields": [
      { "name": "vendor", "type": "string" },
      { "name": "invoice_no", "type": "string", "required": true,
        "pattern": "^[A-Z0-9-]+$" },
      { "name": "invoice_date", "type": "date" },
      { "name": "subtotal", "type": "number" },
      { "name": "tax", "type": "number" },
      { "name": "total", "type": "number" },
      { "name": "line_items", "type": "array",
        "children": [
          { "name": "description", "type": "string" },
          { "name": "qty", "type": "number" },
          { "name": "unit_price", "type": "number" }
        ]
      }
    ]
}'카멜케이스가 표준 표기입니다. 파라미터는 imageType 과 autoFields 입니다. 구식 스네이크케이스 별칭(image_type, auto_fields)도 여전히 동작하지만 deprecated 되었습니다 — 새 코드에서는 카멜케이스 이름을 쓰세요.
응답 구조
호출이 성공하면 { status: "success", data: { ... } } 를 반환합니다. data 는 네 부분으로 나뉘고, 각 부분의 역할은 하나씩입니다.
data.values— 업무 데이터 그 자체입니다. 선언한fields와 똑같은 모양이고 그 밖의 것은 들어가지 않습니다.data.cells— 경로(total,line_items[0].unit_price)를 키로 하는 평평한 맵입니다. 셀마다 0–1000 정규화 그리드(0,0 = 왼쪽 위, 1000,1000 = 오른쪽 아래) 위의 축 정렬 사각형box{ xmin, ymin, xmax, ymax }, 문서 기울기를 따라가는 네 점짜리quad(비뚤게 찍은 휴대폰 사진에서도 박스가 깔끔하게 잡힙니다), 그리고verified·review·evidence가 실립니다. 픽셀 환산은data.image기준으로pixel_x = box.xmin / 1000 × data.image.width입니다.data.review— 요약입니다.unit: "field",declared/returned/boxed/verified건수,flagged({ path, reasons }배열), 그리고by_reason히스토그램이 들어갑니다. 확인할 건수는flagged.length하나뿐이고 별도 카운터는 없습니다.by_reason은 항목당 하나가 아니라 사유 전체를 세므로 합계가flagged.length이상이 됩니다.data.normalized—values와 같은 모양의 성긴 트리로, 스칼라 타입이나pattern을 선언한 필드의 결정론적 해석값만 담습니다.values를 덮어쓰는 일은 없습니다.
verified 는 문자 일치 점수가 아니라 판정입니다. 종류를 가리지 않고 review 에 사유가 붙으면 false, 대조가 돌았는데 아무것도 서지 않으면 true, 애초에 대조할 대상이 없으면(행 유니언 등) null 입니다. 문자 대조 자체는 evidence.text_match 에 있고, 그래서 verified: false 와 text_match: true 가 함께 오는 것은 모순이 아니라 정상 조합입니다 — 글자는 맞았지만 선언한 규칙이 그 값을 잡은 경우죠. evidence 에는 source(vision_symbol_match, token_id 등), match_ratio, 그리고 printed_text(그 좌표에서 OCR 이 읽은 글자)도 실립니다. 정확 일치로 대조할 때는 printed_text 와 비교하세요.
사유 코드는 API 계약 어휘라 번역하지 않습니다. text_mismatch, missing, pattern_mismatch, type_mismatch, out_of_range, low_ratio, overwide_box 등입니다. reasons 는 언제나 배열이며 랭킹 순으로 0번이 대표입니다 — 처리하는 코드를 매핑해 두고, 모르는 코드에는 범용 문구로 폴백하세요.
{
  "status": "success",
  "data": {
    "values": {
      "vendor": "Acme Supply Co.",
      "invoice_no": "INV-4471",
      "invoice_date": "2026/06/18",
      "subtotal": "1,859",
      "tax": "186",
      "total": "2,045",
      "line_items": [
        { "description": "Steel bracket 40mm", "qty": "12", "unit_price": "98" }
      ]
    },
    "cells": {
      "total": {
        "box": { "xmin": 595, "ymin": 974, "xmax": 781, "ymax": 1000 },
        "quad": [
          { "x": 594, "y": 975 }, { "x": 781, "y": 972 },
          { "x": 781, "y": 998 }, { "x": 595, "y": 1000 }
        ],
        "verified": true,
        "review": null,
        "evidence": {
          "text_match": true,
          "source": "vision_symbol_match",
          "match_ratio": 0.93,
          "printed_text": "2,045"
        },
        "normalized": { "value": 2045, "type": "number", "method": "deterministic" }
      },
      "line_items[0].unit_price": {
        "box": { "xmin": 693, "ymin": 460, "xmax": 738, "ymax": 488 },
        "quad": [
          { "x": 693, "y": 460 }, { "x": 738, "y": 460 },
          { "x": 738, "y": 488 }, { "x": 693, "y": 488 }
        ],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": {
          "text_match": false,
          "source": "vision_symbol_match",
          "match_ratio": 0.62,
          "printed_text": "9B"
        }
      }
    },
    "review": {
      "unit": "field",
      "declared": 9,
      "returned": 9,
      "boxed": 9,
      "verified": 8,
      "flagged": [
        { "path": "line_items[0].unit_price", "reasons": ["text_mismatch"] }
      ],
      "by_reason": { "text_mismatch": 1 }
    },
    "normalized": {
      "invoice_no": "INV-4471",
      "invoice_date": "2026-06-18",
      "subtotal": 1859,
      "tax": 186,
      "total": 2045,
      "line_items": [ { "qty": 12, "unit_price": 98 } ]
    },
    "image": { "width": 1654, "height": 2339 }
  }
}좌표는 모델의 말을 그대로 믿고 정하지 않습니다. 언어 모델은 각 값의 텍스트 — 그리고 어떤 워드 토큰을 사용했는지에 대한 힌트 — 를 반환하지만 박스 자체는 절대 내놓지 않습니다. 그다음 엔진이 그 텍스트를 비전 OCR이 페이지에서 실제로 검출한 심볼들과 문자 단위로 매칭합니다. evidence.match_ratio 는 그중 얼마나 찾아냈는지를 나타내고, 박스는 그 문자들이 비롯된 실제 픽셀 위에 놓입니다. 모델의 토큰 힌트는 노이즈가 섞일 수 있어서(반복되는 행 사이에서 서로 바뀌기도 합니다), 이를 무조건 신뢰하는 대신 열·행 일관성 검사로 검증합니다. 이 비율은 보조 근거일 뿐 판정이 아닙니다 — 판정은 verified 와 review 가 맡습니다. 전체 논리는 바운딩 박스가 OCR을 감사 가능하게 만드는 이유를 참고하세요.
검토 신호가 되는 선언
FieldSpec 은 필드에 이름만 붙이는 게 아니라 "좋은 값이란 무엇인가" 도 선언할 수 있고, 선언 하나하나에 대응하는 검토 사유가 붙어 있습니다. required: true 는 값이 비어서 오거나 아예 오지 않을 때 missing 을 세웁니다 — 문자 대조만으로는 원리적으로 볼 수 없는 유일한 실패 유형입니다. pattern 은 pattern_mismatch, enum 은 집합 밖으로 나갈 때 같은 사유, min / max 는 정규화된 숫자에 대해 out_of_range, 스칼라 type 은 해석되지 않을 때 type_mismatch 를 세웁니다.
이 가운데 무엇도 모델에 전달되지 않습니다. 선언한다고 추출 정확도가 오르지는 않으며, 값은 어느 쪽이든 똑같이 돌아옵니다. 선언이 정하는 것은 어떤 경로가 data.review.flagged 에 오르는지, 그리고 label 의 경우 엔진이 좌표를 어디에 고정하는지입니다. 판독과 검사를 서로 독립으로 두는 것 자체가 목적이고, 그래야 둘의 일치에 의미가 생깁니다.
모델을 실제로 유도하는 것은 description 입니다 — 무엇을 어떻게 잡아낼지 평이한 자연어로 적어 주는 지시문이죠. 그리고 children 을 곁들인 type: "array" 는 반복되는 라인 아이템을 뽑아내는 방법으로, 하나의 자식 스키마로 여러 행을 처리하고 각 행은 line_items[0], line_items[1] 처럼 경로로 지목합니다. (이 부분은 송장에서 라인 아이템 추출하기에서 깊게 다룹니다.)
import requests, base64

with open("invoice.jpg", "rb") as f:
    b64 = base64.b64encode(f.read()).decode()

resp = requests.post(
    "https://api.space-ocr.com/ocr/fields",
    headers={"Authorization": "Bearer spocr_xxxxxxxxxxxxxxxx"},
    json={
        "image": b64,
        "imageType": "base64",
        "fields": [
            {"name": "vendor", "type": "string",
             "description": "Supplier / billing company name"},
            {"name": "invoice_no", "type": "string", "required": True,
             "description": "Invoice number as printed"},
            {"name": "invoice_date", "type": "date"},
            {"name": "total", "type": "number",
             "description": "Grand total"},
            {"name": "line_items", "type": "array",
             "description": "One row per line on the invoice",
             "children": [
                 {"name": "description", "type": "string"},
                 {"name": "qty", "type": "number"},
                 {"name": "unit_price", "type": "number"},
             ]},
        ],
    },
    timeout=200,
)

data = resp.json()["data"]

# 인쇄된 값과 그 옆의 결정론적 해석값
print(data["values"]["total"], data["normalized"].get("total"))

# 검토 큐 — 확인이 필요한 경로마다 한 건
for item in data["review"]["flagged"]:
    cell = data["cells"].get(item["path"])
print(item["path"], item["reasons"][0], cell["box"] if cell else None)values 는 판독 결과이지 바이트 단위 복사본이 아닙니다. 7,855 로 인쇄된 합계는 문자열 "7,855" 로 돌아옵니다 — 요약하거나 바꿔 쓰지 않기 때문에 값을 좌표에 붙일 수 있습니다. 다만 이는 모델이 읽은 문자열이고, 문자 대조는 전각·괄호·공백을 접고 비교하므로 (税抜) 가 (税抜) 로 바뀌는 정도의 표기 차이는 통과합니다. 정확 일치로 대조하려면 cells[path].evidence.printed_text (그 좌표에서 OCR 이 읽은 글자) 와 비교하세요. ISO 날짜나 구분자 없는 숫자처럼 해석된 형태는 data.normalized 에 담기고 values 를 덮지 않습니다. 웹 UI에서 보이는 ¥ 는 장식일 뿐 값의 일부가 아닙니다. 엔진은 래스터 이미지만 받습니다 — JPEG, PNG, GIF, BMP, TIFF, WebP — 그리고 자동으로 RGB로 변환합니다.
비동기로 가기: 일괄 업로드, 잡, 웹훅
POST /ocr/fields 는 동기 호출이라 요청/응답 루프에서 송장 하나를 처리하기에 안성맞춤입니다. 판독하는 동안 연결을 열어 두며 처리 상한은 180초 입니다. 넘기면 504 가 error.code: "ocr_engine_timeout" 과 함께 오고, 그 호출은 과금되지 않습니다. 상한에 닿는 원인은 화소 수보다 밀도인 경우가 대부분이라, 해법은 1페이지 1이미지로 나누거나 아래의 비동기 경로입니다.
송장이 한 폴더 가득이라면 POST /upload(멀티파트 files 반복, 요청당 최대 20건)로 시트에 올리세요. 기본적으로는 즉시 jobs 배열과 함께 반환됩니다.
{ "path": "...", "jobs": [ { "uniqueKey": "...", "jobId": "...", "status": "pending" } ] }그다음 결과는 두 가지 방법으로 알 수 있습니다. GET /jobs/{jobId} 를 폴링하거나, 웹훅을 등록하면 됩니다. 웹훅은 스페이스당 URL 하나이며, X-Spaceocr-Signature 헤더로 HMAC-SHA256 서명됩니다. 신경 쓸 이벤트는 upload.received, item.created, ocr.completed(data.result 에 values / cells / review / image 와 같은 구조로 추출 결과가 실립니다), 그리고 ocr.failed 입니다. 페이로드를 신뢰하기 전에 항상 서명을 검증하세요.
멱등성, 요청 추적, 그리고 레이트 리밋
몇 가지 헤더만 있으면 프로덕션 파이프라인을 안전하게 재시도할 수 있습니다.
| 헤더 | 용도 |
|---|---|
Idempotency-Key | /ocr/fields, /create, /upload 에서 받습니다. 같은 키로 재요청하면 24시간 동안 캐시된 응답을 재생합니다(X-Idempotent-Replay: true) — 중복 과금 없이 안전하게 재시도. 재전송 안전장치이지 보관 수단은 아닙니다. |
X-Request-Id | 모든 응답에 반환됩니다(req_xxx). 지원 문의를 위해 로그로 남기세요. |
X-RateLimit-Remaining | 그 키에 남아 있는 이번 1분간 호출 가능 수입니다. |
레이트 리밋은 키당 60 requests/min, uid당 600 requests/min 입니다. 이를 초과하면 error.code: "rate_limited" 와 함께 429 를 받고, 기다릴 초 수는 Retry-After 헤더에 담겨 옵니다 — 곧바로 재시도하지 말고 그 값으로 백오프하세요.
용량 산정에 참고하시라고 덧붙이면, 프로덕션 트래픽에서 관측된 소요 시간은 p50 약 7.2초, p90 약 10.5초입니다. SLA가 아니라 관측된 분포이며, 필드가 많고 조밀한 송장은 이보다 위로 갑니다.
{
  "error": {
    "code": "rate_limited",
    "message": "Rate limit exceeded",
    "requestId": "req_8fa2c1"
  }
}
추출에서 조회 가능한 시트로
송장이 시트에 추출되고 나면, 그걸 다시 읽기 위해 OCR을 재실행하지 않습니다. GET /view 는 저장된 행에 대해 서버 측 쿼리 — where, sort, select, limit, offset — 를 실행하며, 과금도 재추출도 없습니다. 각 행은 직접 호출했을 때와 같은 values / cells / review / image 구조로 돌아오고, 더 가벼운 페이로드를 원하면 boxes=0 을 붙여 cells 맵을 뺄 수 있습니다. 거기서 CSV로 내보낼 수 있습니다(UTF-8 BOM이라 Excel과 CJK 텍스트가 깨지지 않고 열립니다) — 스캔 문서를 CSV로 변환하기를 참고하세요.
요금
POST /ocr/fields 는 호출당 ₩100, POST /upload 는 이미지 N장 기준 ₩100 × N 입니다. 실패는 과금하지 않습니다 — 400 invalid_image 와 504 ocr_engine_timeout 은 애초에 과금까지 가지 않고, 502 엔진 오류나 ocr.failed 이벤트는 자동으로 환불됩니다. 읽기 전용 엔드포인트(GET /space, /view, /jobs, /amount, /health)는 무료입니다. 무료 등급은 신용카드 없이 월 100크레딧이고, 유료 플랜은 Starter 월 ₩39,800, Pro 월 ₩69,800 입니다 — 최신 구성은 요금 페이지를 확인하세요.
API로 송장에서 데이터를 추출하는 방법
- API 키를 만들고 인증 설정하기가입 후 spocr_ 접두사가 붙은 키를 발급합니다. 모든 요청은 https://api.space-ocr.com 에 Authorization: Bearer 헤더로 인증합니다.
- 송장 이미지를 준비하기엔진이 읽는 것은 래스터 이미지뿐입니다(JPEG, PNG, GIF, BMP, TIFF, WebP). 공개 URL이나 순수 base64로 넘기고, 필수 파라미터 imageType 에 'url' 또는 'base64' 를 명시하세요.
- 원하는 필드를 선언하기POST /ocr/fields 에 fields[] 배열을 넘깁니다. vendor, invoice_no, invoice_date, 금액 항목, 그리고 children 을 가진 배열로서의 line_items 입니다. 아직 스키마를 모르겠다면 autoFields: true 를 보내세요.
- 값과 검토 큐 읽기업무 데이터는 data.values 에서 가져오고, 이어서 data.review.flagged 를 순회합니다. 각 항목은 경로와 사유의 쌍이며, 그 경로를 data.cells 에서 찾으면 box·quad·evidence 가 나옵니다.
- 규모를 키우고 조회하기여러 장을 처리할 때는 POST /upload 로 시트에 올리고, GET /jobs/{jobId} 폴링이나 ocr.completed 웹훅으로 결과를 받습니다. 저장된 행은 GET /view 로 조회하거나 CSV로 내보냅니다.