같은 문서, 같은 스키마, 다른 답: space-ocr vs Mistral
케이스 8건·문서 7장·463개 필드, 엔진당 3런의 통제 벤치마크. 필드 판독률, 런 간 안정성, 그리고 점수표엔 안 보이는 좌표의 격차.
space-ocr는 저희가 만든 문서 판독 API입니다. 사진 한 장과 뽑고 싶은 값의 목록을 보내면 그 값들을 데이터로 돌려주는데, 값마다 그 값을 읽어 온 페이지 위의 위치가 같이 옵니다. 이 글은 그 space-ocr를 Mistral Document AI와 나란히 놓고, 실제로 어려운 문서들로 돌려 본 기록입니다.
OCR 업체 데모는 어디든 깨끗한 인쇄 청구서를 완벽하게 읽습니다. 저희 것도 그렇고, 그건 도입 판단에 아무 정보가 되지 않습니다. 판단에 필요한 질문은 셋입니다. 까다로운 문서에서는 어떻게 되는가. 같은 페이지를 두 번 돌리면 답이 바뀌는가. 틀린 값을 전부 손으로 다시 보지 않고 어떻게 찾아내는가. 셋 다 쟀고, 아래에 전부 적었습니다. 저희에게 불리한 숫자도 그대로 뒀습니다.
무엇을 돌렸나
채점 케이스 8건, 값 463개, 사진 7장입니다. 일본어 납품서 3장, 상품명이 한 줄이고 수량과 단가가 그 아래 줄에 찍히는 마트 영수증, 채팅 메시지로 온 24행 주문, 보수 명세서, 그리고 모니터 화면을 찍은 22행 도매 시세표. 전부 저희 회귀 테스트에 들어 있는 사진들, 즉 저희가 뭔가를 망가뜨렸을 때 걸리라고 두는 세트입니다.
사진은 7장인데 케이스가 8건인 이유는, 두 케이스가 같은 채팅 주문 사진에 같은 정답지이기 때문입니다. 내부 경로를 갈라 보려고 테스트에서 따로 관리하는 쌍이고, 두 엔진 입장에서는 같은 이미지를 두 번 받은 것뿐입니다. 그래서 이 사진 한 장이 463개 값 중 144개를 차지한다는 점은 감안하고 보셔야 합니다.
팔은 셋이고, 셋 모두 같은 이미지, 같은 필드 목록(이름과 설명까지 동일), "인쇄된 그대로 옮겨라"라는 같은 지시를 받았습니다.
| 팔 | 무엇을 호출했나 | 필드를 어떻게 요구했나 |
|---|---|---|
| space-ocr | 프로덕션 POST /ocr/fields | 이름과 설명이 붙은 필드 목록 |
| Mistral OCR | mistral-ocr-latest, /v1/ocr + document_annotation | 같은 목록을 strict JSON 스키마로 |
| Mistral 비전 LLM | mistral-medium-latest, 채팅에 이미지 첨부 | 같은 목록을 response_format: json_schema, temperature 0 |
문서마다 팔당 3런, 합계 72런이고 전부 원문을 보관했습니다. 채점기는 세 팔에 같은 스크립트 하나입니다. 공백을 지우고 손으로 쓴 정답지와 정확히 일치하면 정답, 아니면 오답. 2026년 8월.
결과, 그리고 같이 봐야 할 단서
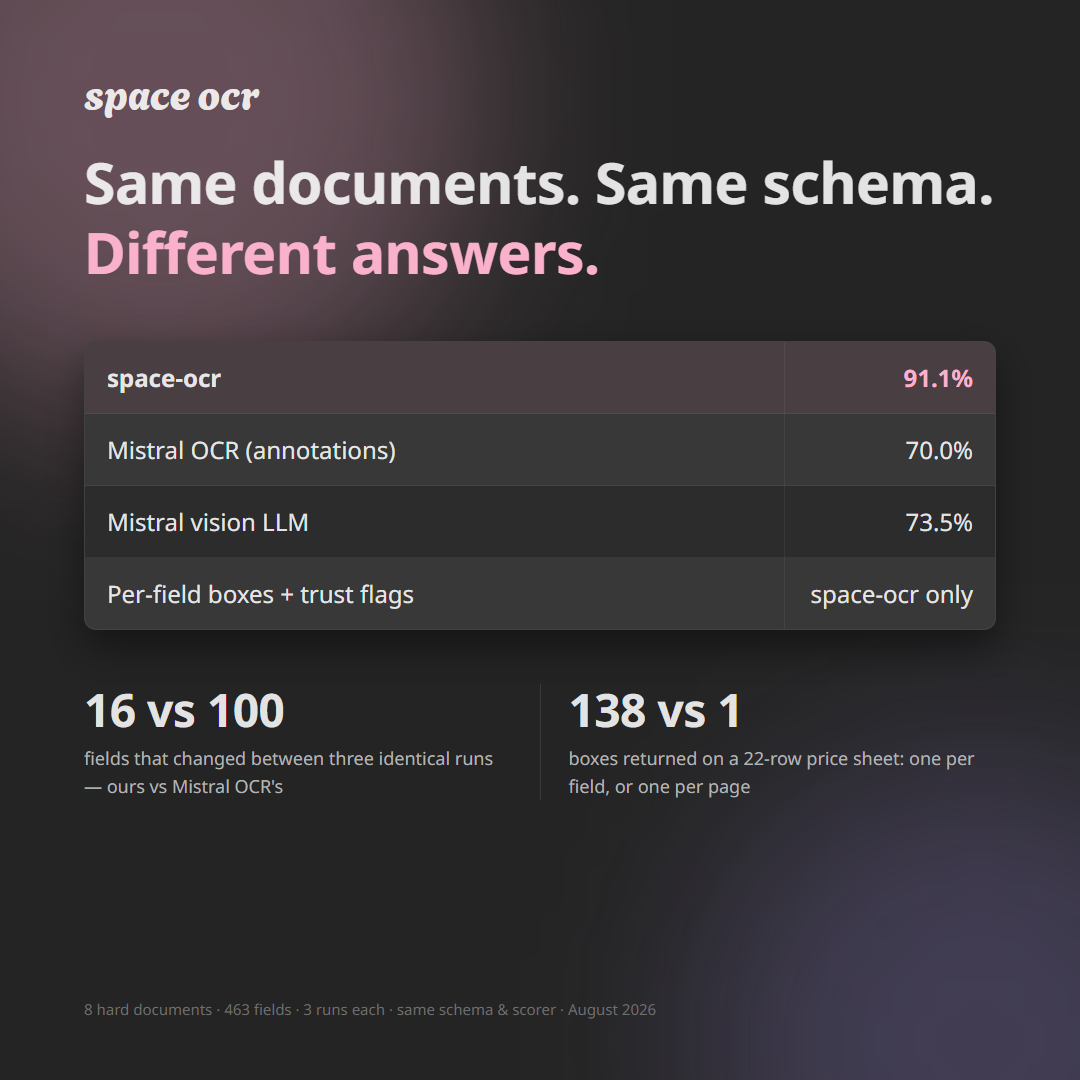
space-ocr는 463개 값 중 91.1%를 정확 일치로 읽었습니다(3런 평균). Mistral OCR 어노테이션은 70.0%, Mistral 비전 LLM은 73.5%였습니다.
어느 엔진이든 오답의 일부는 형식 문제입니다. 통화 기호를 남겼거나 숫자에 단위를 붙였거나 하는 것들이죠. 그래서 구분자나 띄어쓰기만 다른 불일치를 전부 걷어내고 내용 오류만 다시 셌습니다. 런당 space-ocr 약 23건, Mistral OCR 119건, 비전 LLM 93건. 격차는 그대로 남습니다.
숫자를 보기 전에 하나 더. 정답지는 값의 경계를 어디서 끊을지에 대한 저희 파이프라인의 관례대로 옮겨 적은 것이라, 저희를 포함해 모든 엔진이 경계 해석 차이로 점수를 잃습니다. 읽어야 할 숫자는 팔 사이의 격차이고, 절대 점수는 성적이 아니라 하한선입니다.
케이스 8건, 점수 전부
3런 평균으로, 맞힌 값 수 / 전체 값 수입니다.
| 문서 | 값 | space-ocr | Mistral OCR | Mistral VLM |
|---|---|---|---|---|
| 시세표 22행, 모니터 촬영 | 141 | 139.0 (98.6%) | 139.0 (98.6%) | 133.7 (94.8%) |
| 보수 명세서 | 44 | 42.7 (97.0%) | 39.0 (88.6%) | 34.7 (78.8%) |
| 납품서 C | 53 | 50.3 (95.0%) | 43.7 (82.4%) | 47.3 (89.3%) |
| 납품서 B | 37 | 34.3 (92.8%) | 18.0 (48.6%) | 24.3 (65.8%) |
| 두 줄짜리 마트 영수증 | 13 | 12.0 (92.3%) | 2.3 (17.9%) | 1.3 (10.3%) |
| 채팅 주문 24행 (2건 중 2) | 72 | 61.0 (84.7%) | 21.3 (29.6%) | 41.7 (57.9%) |
| 채팅 주문 24행 (2건 중 1) | 72 | 58.0 (80.6%) | 39.7 (55.1%) | 42.3 (58.8%) |
| 납품서 A | 31 | 24.7 (79.6%) | 21.0 (67.7%) | 15.0 (48.4%) |
| 전체 | 463 | 422.0 (91.1%) | 324.0 (70.0%) | 340.3 (73.5%) |
먼저 볼 줄은 맨 윗줄입니다. 이 세트에서 가장 깨끗한 문서, 값이 141개 들어찬 조밀한 인쇄 표에서 Mistral OCR은 저희와 똑같은 점수를 냈습니다. 글자를 읽어 내는 능력은 이 엔진들이 갈리는 지점이 아니고, 그 사실을 가리는 비교는 무언가를 팔려는 비교입니다.
갈리는 곳은 표 아래쪽이고 방향은 일정합니다. 레이아웃이 까다로울수록 격차가 벌어집니다. 채팅 주문 두 줄도 같이 보시면 좋습니다. 같은 사진, 같은 정답지, 같은 스키마를 두 번 보낸 건데 저희는 두 번의 차이가 3개였고 Mistral OCR은 18개였습니다.
같은 페이지를 세 번 돌리면
463점 만점, 런별 총점입니다.
| 팔 | 1런 | 2런 | 3런 | 변동 폭 |
|---|---|---|---|---|
| space-ocr | 430 | 414 | 422 | 16 |
| Mistral OCR | 322 | 275 | 375 | 100 |
| Mistral 비전 LLM | 360 | 329 | 332 | 31 |
100개짜리 변동 폭은 평균 주변의 잡음이 아니라 사실상 다른 제품입니다. Mistral OCR의 어떤 런은 한 시간 전에 72개 중 58개를 맞힌 문서에서 72개 중 3개를 냈습니다. 어노테이션 계층이 43행 표의 열 배정을 통째로 뒤섞은 것인데, 응답만 봐서는 그 런이 좋은 런과 구분되지 않습니다.
틀릴 때 실제로 어떻게 틀리나
격차가 가장 컸던 두 줄짜리 영수증, 1런입니다. 이 영수증은 상품명을 한 줄에 찍고 수량과 단가를 그 아래 줄에 찍으며, 합계 블록이 같은 열 바로 밑에 붙어 있습니다.
| 값 | 페이지에 인쇄된 것 | space-ocr | Mistral OCR |
|---|---|---|---|
| 1번 상품명 | ポッカサッポロ果実の | 정답 | 006142 ポッカサッポロ 果実の |
| 1번 수량 | 12 | 정답 | 12コ |
| 1번 단가 | 98 | 정답 | 単98 ¥1,176 |
| 2번 상품명 | 塩パン | 정답 | 011102 塩パン |
| 날짜 | 2017年07月30日(日) | 정답 | 2017年07月30日(日) No.2805 |
| 합계 | 1,451 | ¥1,451 | ¥1,451 |
맨 아랫줄부터 보시죠. 합계에서는 두 엔진이 같은 답을 냈고 둘 다 오답 처리됐습니다. 정답지에 통화 기호가 없기 때문입니다. 이런 오답이 저희 것을 포함해 모든 엔진의 오류 수를 부풀리고, 그래서 위의 '내용 오류만' 숫자가 원 숫자보다 더 쓸모 있습니다.
나머지 줄은 성격이 다릅니다. 저기서 Mistral은 글자를 잘못 읽은 게 아닙니다. 매대 코드를 상품명에 붙이고 가격을 수량 줄에 붙였습니다. 인쇄된 두 줄이 하나의 레코드라는 걸 끝내 파악하지 못한 것입니다.
24행 채팅 주문의 실패는 통째로 볼 가치가 있습니다. 뒷단에서 가장 비싸게 먹히는 실패 유형이거든요.
| 행 | 인쇄된 것 | Mistral OCR 응답 |
|---|---|---|
| 1행 비고 | ヒチョウ | (빈칸) |
| 2행 품목 | クエ | ヒチョウ |
| 2행 비고 | 頭落とし | 背 |
| 3행 품목 | ブリ | クエ |
| 3행 비고 | サクラブリ | (빈칸) |
모든 행이 한 칸씩 위로 밀렸습니다. 값 하나하나는 페이지에 실제로 있는 문자열이고 철자도 맞습니다. 그런데 표로 보면 두 번째 행부터 전부 틀렸고, 응답의 생김새에는 이상한 구석이 없습니다.
같은 페이지에서 저희 오답도 있었습니다. 규모가 작았을 뿐입니다. ヒチョウ를 ヒチョウ背로, 冷凍을 冷凍 2L로 읽었습니다. 표를 밀어 버린 게 아니라 옆 칸을 붙여 읽은 것이죠. 납품서 B에서는 단가 1510을 510으로 읽어 옆 열에서 붙어 온 숫자 한 자리를 놓쳤습니다.
점수표가 보여 줄 수 없는 것
시세표에서 두 엔진에 같은 141개 값을 요구하면, 돌아온 두 답은 똑같이 쓸 만해 보입니다. 각 값이 어디에서 왔는지 묻기 전까지는요.
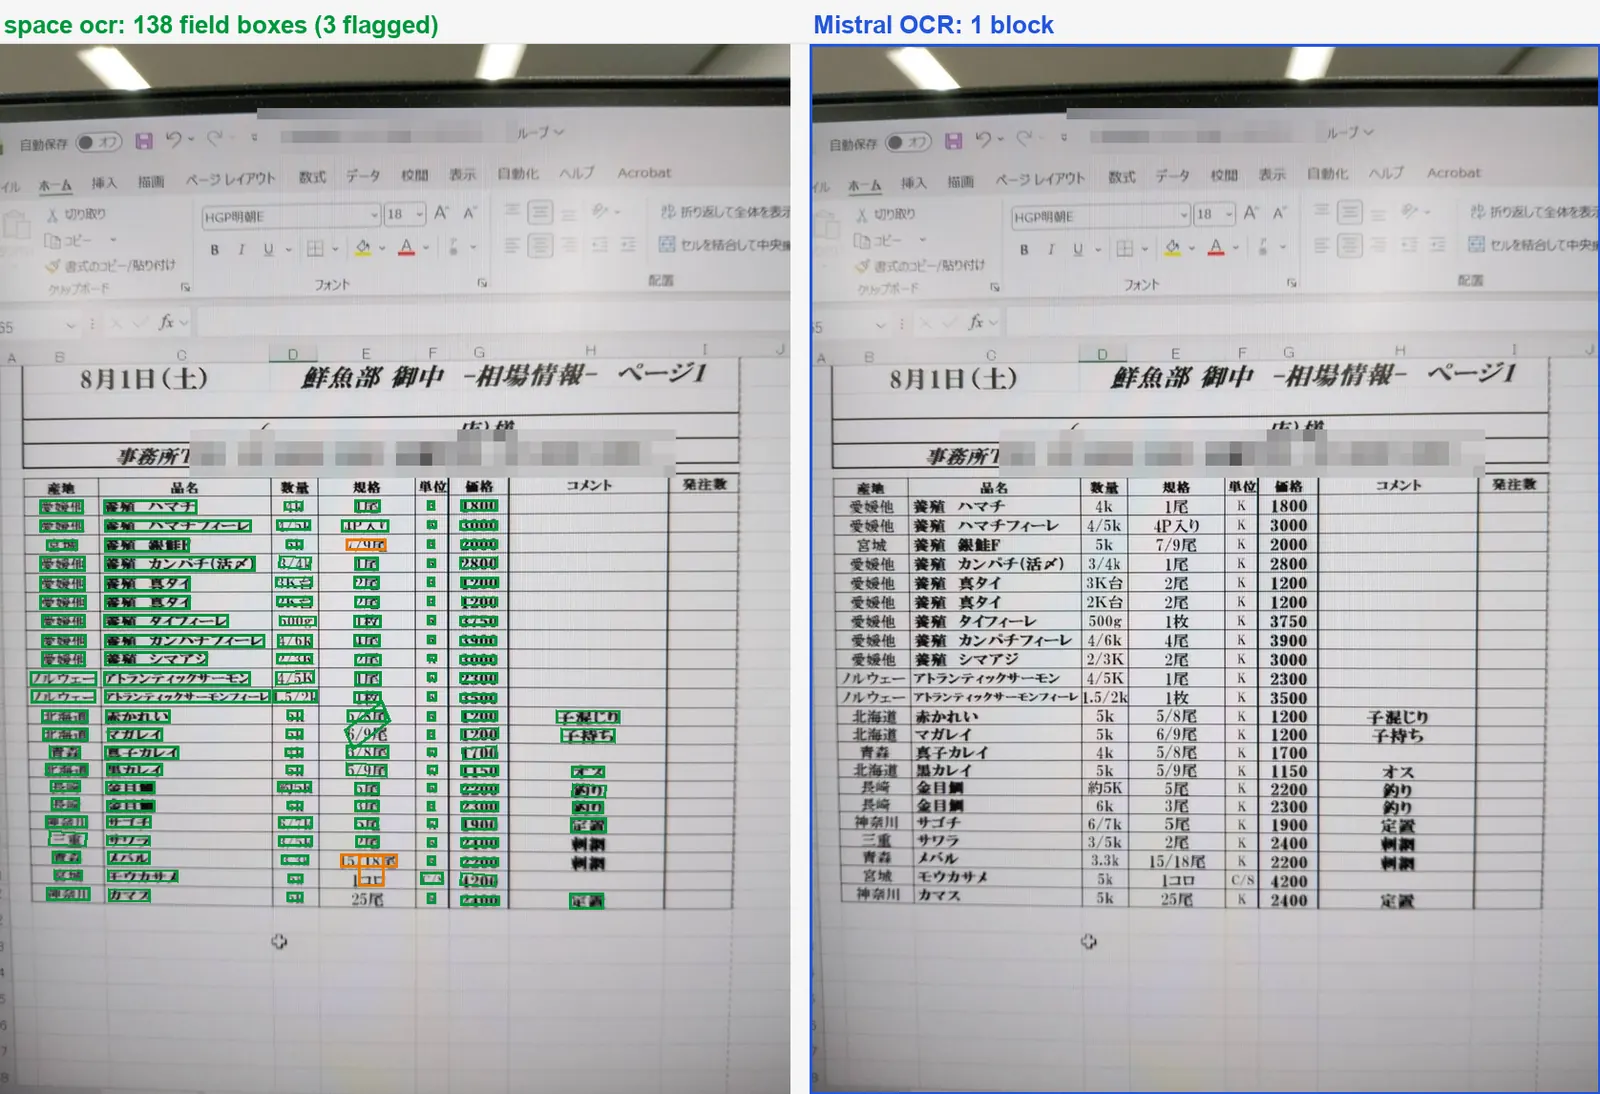
space-ocr는 값마다 박스를 돌려주고, 그 박스는 값을 읽어 온 실제 픽셀에 붙어 있습니다. 이번 벤치마크에서 보관한 Mistral 응답(mistral-ocr-latest, 2026년 8월)에서는 같은 시세표가 표 전체를 덮는 사각형 하나로 돌아왔습니다. 그 응답에는 값 단위 좌표가 없었고, 저희가 본 가장 촘촘한 단위는 문단 블록이었습니다. 지금의 API가 무엇을 돌려주는지는 Mistral의 최신 문서에서 확인한 뒤에 설계하시길 권합니다.
검증 신호도 그 응답에는 없었습니다. space-ocr의 값은 data.cells[path]에 담겨 옵니다. 0~1000 격자의 box와 quad, 판정인 verified, 무엇이 통과하지 못했는지를 기계 판독 코드로 나열하는 review.reasons, 그리고 문자 대조 자체(text_match)와 그 근거인 match_ratio, 인식 쪽이 낼 수 있을 때의 ocr_confidence를 담은 evidence입니다. 사람이 봐야 할 값은 data.review.flagged 한 곳에 모입니다. 같은 값이 페이지에 여러 번 나오면 필드 선언의 label이 어느 출현을 잡을지 고정합니다. verified: true는 글자 그대로 읽으셔야 합니다. 돌아간 검사가 아무것도 찾지 못했다는 판정이지, 그 값이 원하던 값이라는 보증은 아닙니다.
이게 일을 바꿉니다. 박스와 검토 목록이 있으면 조용히 틀린 값이 드러나고, 사람은 141개를 다시 읽는 대신 플래그가 선 몇 개부터 봅니다. 전부를 걸러내는 그물은 아닙니다. 두 판독이 같은 답에 합의한 값에는 대조가 세울 것이 없고, 위의 합계 행이 바로 그 모양입니다. 그래도 플래그가 붙은 오답은 한 번 훑는 비용이고, 신호 없는 오답은 그 위에 쌓아 올린 것 전부의 비용입니다.
세트 전부, 두 엔진
사진 7장 전부입니다. 좌우가 같은 이미지이고, 박스는 벤치마크 1런의 보관된 응답에서 그대로 그렸습니다. 초록은 space-ocr의 값 하나, 주황은 그 런에서 엔진이 검토로 돌린 값, 파랑은 Mistral OCR의 블록 하나입니다. 제3자의 상호·주소·전화번호·계좌번호·담당자 실명은 공개 전에 모자이크 처리했고, 그래서 일부 박스가 회색 사각형 위에 놓여 있습니다.
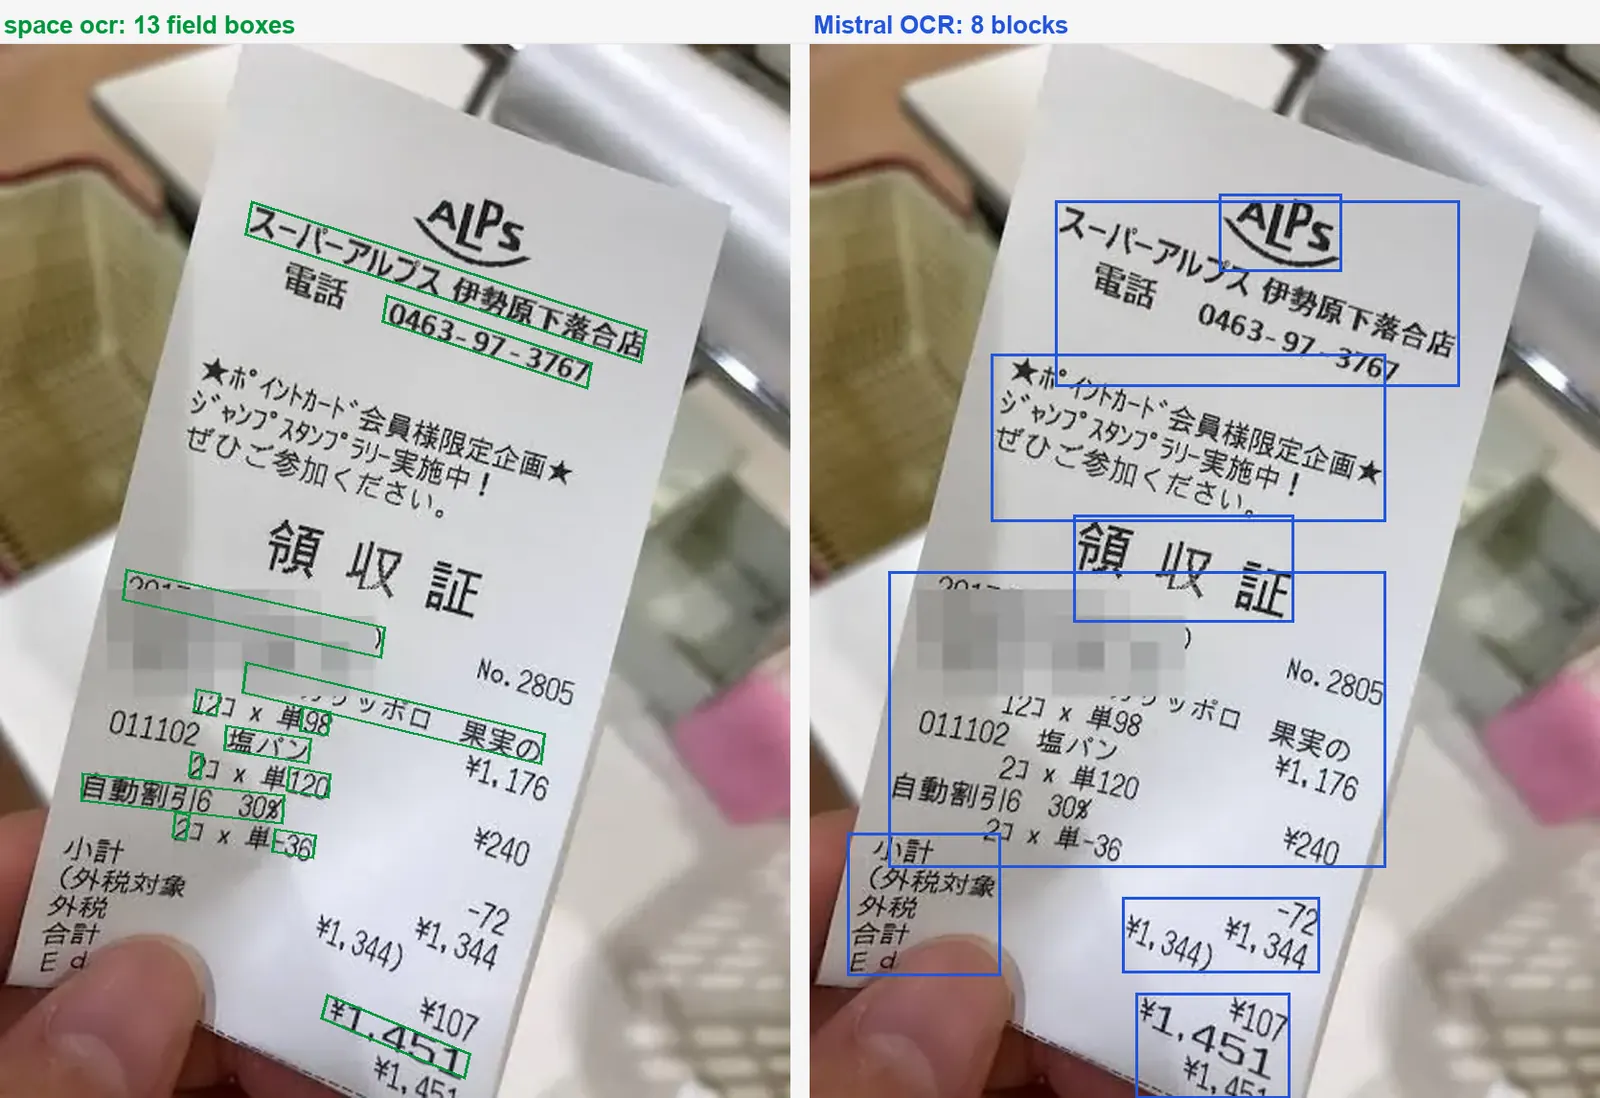
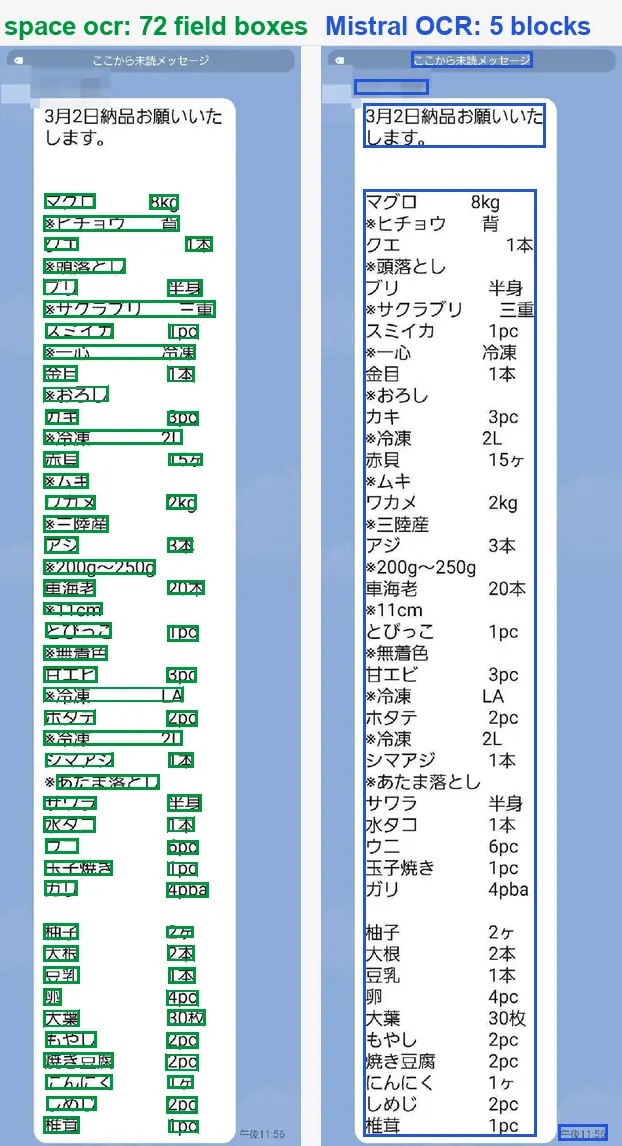
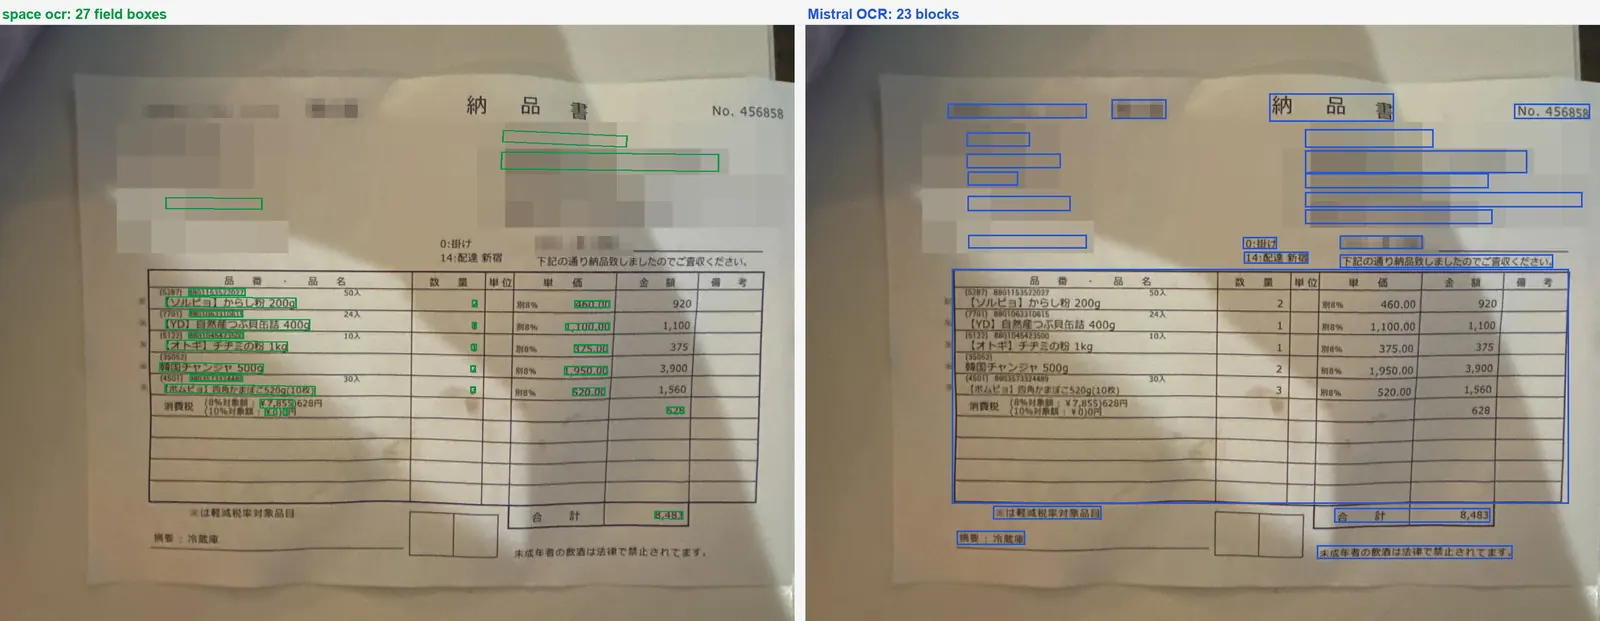
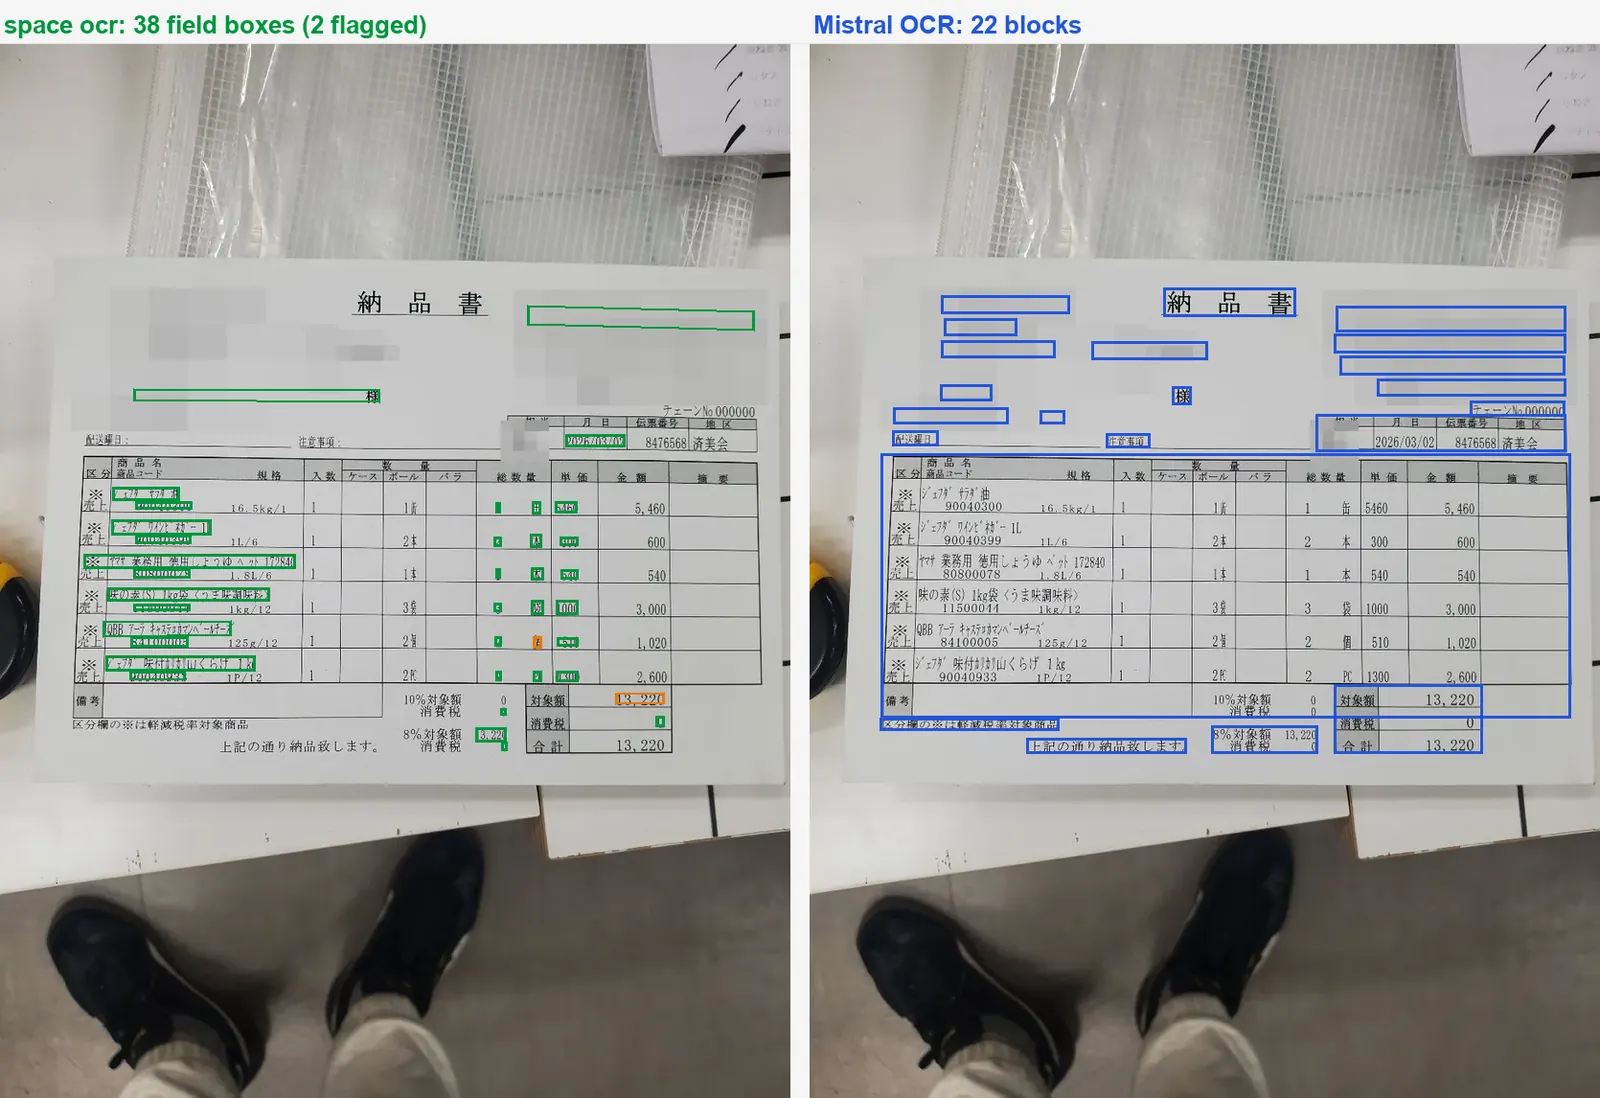
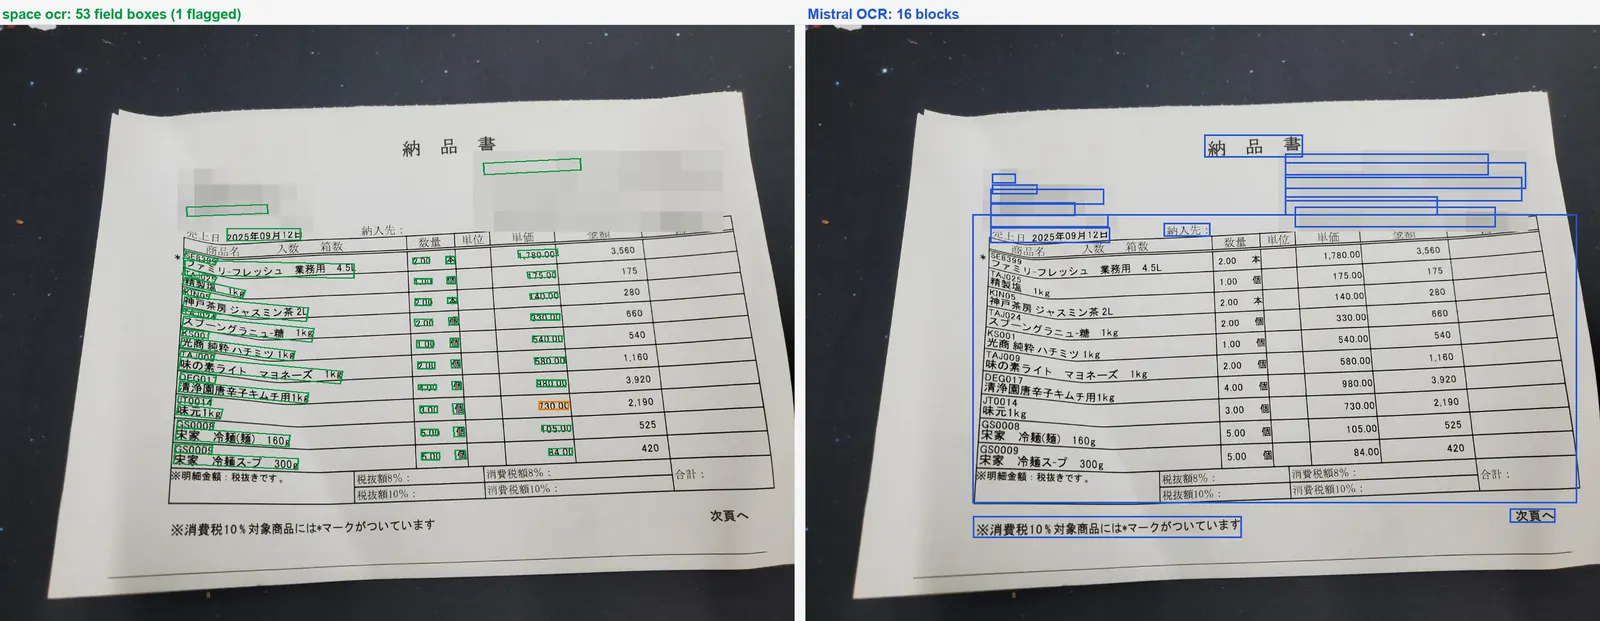
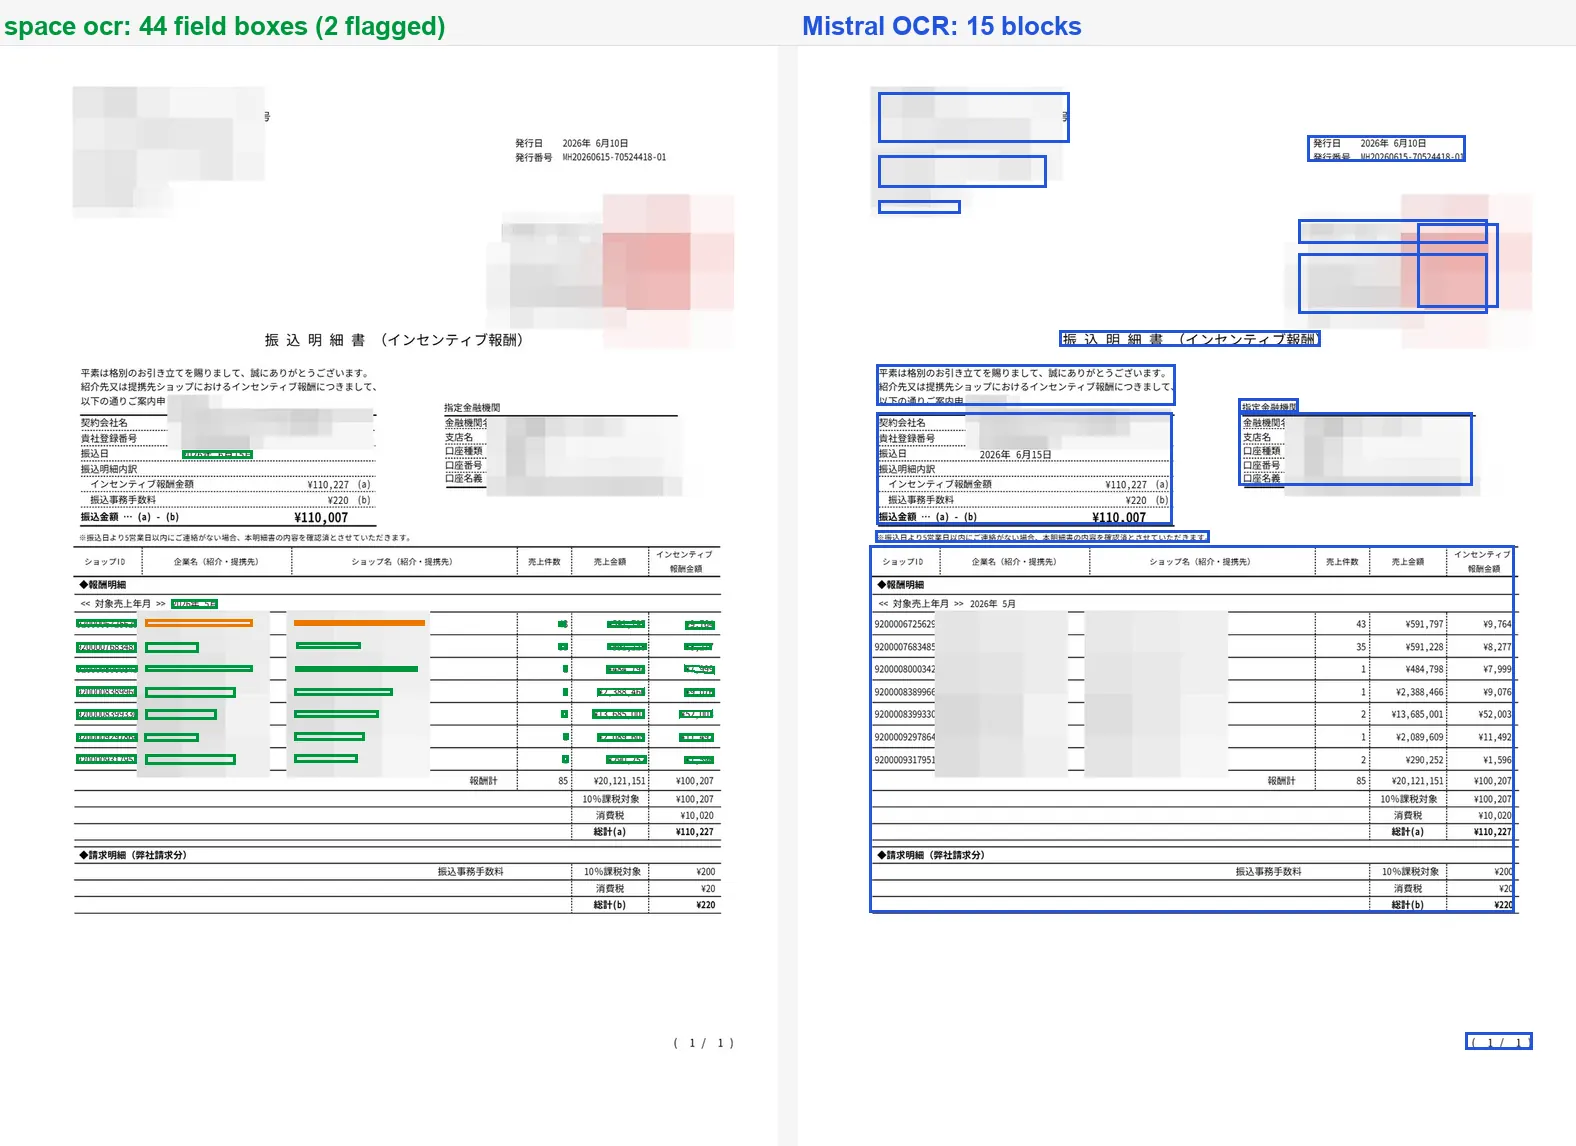
검증이 어떻게 도는지가 사실 이 글의 논지 전부입니다. 언어 모델은 값과 단어 단위 힌트를 돌려줄 뿐 좌표는 만들지 않습니다. 엔진이 그 값을 페이지에서 실제로 검출된 문자들과 한 글자씩 대조해 박스를 그 문자들 위에 앉히고, 얼마나 맞았는지를 evidence.match_ratio로 점수화합니다(0.85 이상이면 확신 일치). 이 비율은 판정을 뒷받침하는 증거 중 하나이지 그 자체가 관문은 아닙니다. 두 판독이 어긋나면 review.reasons에 text_mismatch 같은 사유 코드가 서고 verified는 false가 되며, 그 값은 봐야 할 것들의 목록인 data.review.flagged에 들어갑니다. 좌표는 값마다 0~1000 격자의 xmin/ymin/xmax/ymax를 담은 box와, 기울어진 페이지를 위해 순서가 정해진 네 꼭짓점을 담은 quad로 옵니다.
이 글이 재지 않은 것
잰 것은 2026년 8월, 케이스 8건에서의 필드 추출입니다. 속도도 가격도 재지 않았고, Mistral의 마크다운 변환도 재지 않았습니다. 그건 다른 일을 하는 다른 제품이고 이번 런에 한 번도 들어오지 않았습니다. 문서 판독 일반에 대한 이야기도 아닙니다. 한 회사의 회귀 세트에서 나온 8건은 작고 일부러 고약하게 고른 표본이며, 일본어 업무 양식과 조명이 나쁜 사진 쪽으로 치우쳐 있습니다.
원자료는 전부 남아 있습니다. 실행 스크립트, 채점된 72런, 두 벤더의 응답 원문, 그리고 위 이미지들을 그린 스크립트까지.
그래도 가장 쓸모 있는 벤치마크는 여러분의 것입니다. 평소 애먹이는 문서 5장을 고르고, 정답지를 먼저 손으로 쓰고, 같은 필드 목록을 두 API에 보내고, 각각 세 번씩 돌려 보세요. 아래 절차가 저희가 한 그대로입니다. 성공한 스캔은 장당 100원, 실패는 과금하지 않으며, 매월 첫 100페이지는 무료라서 직접 확인하는 비용은 사실상 들지 않습니다.
- 데모 말고 아픈 문서를 고르세요여러 줄 레코드, 반복되는 값, 화면을 찍은 사진, 조밀한 표처럼 실제로 고생시키는 페이지 5~10장을 고릅니다. 깨끗한 샘플로는 업체가 갈리지 않습니다.
- 스키마와 지시를 하나로 고정하세요필드 목록을 한 번만 쓰고, 같은 이름과 설명으로 모든 엔진에 동일하게 보냅니다. 값은 인쇄된 그대로 요청하세요.
- 정답지는 손으로 먼저 쓰세요아무것도 돌리기 전에 필드마다 기대값을 옮겨 적고, 이후에는 수정하지 않습니다.
- 엔진마다 최소 3번 돌리세요한 번의 런은 불안정성을 숨깁니다. 모든 런을 같은 스크립트로 채점하고 평균이 아니라 흔들림을 보세요.
- 조용한 오류를 따로 세세요틀린 값마다 엔진이 플래그를 달았는지 기록합니다. 플래그가 달린 오답은 한 번 훑는 비용이지만, 신호 없는 오답은 그 위에 쌓은 프로세스 전체의 비용입니다.