스타트업을 위한 저비용 OCR: 군더더기 없는 문서 처리 실전 가이드
스타트업을 위한 저비용 OCR 실전 가이드 — 사용한 만큼만 내는 과금, 검증 가능한 바운딩 박스, 군더더기 없는 CLI·API 워크플로.
가장 비싼 문서 파이프라인은 페이지당 단가가 가장 높은 파이프라인이 아니다. 앞으로도 쓰지 않을 좌석 비용까지 떠안게 만드는 파이프라인이다. 많은 창업자가 "무료" 등급으로 시작했다가 확장 벽에 부딪히고, 또 어떤 이들은 실제 사용량과 무관한 엔터프라이즈 계약에 묶인다. 스타트업에 맞는 저비용 OCR을 고르려면 마케팅 수사를 걷어내고 순수한 실용성만 봐야 한다. 존재하지도 않는 데이터를 지어내는 결과를 손보고, 예고 없이 튀는 API 청구서를 관리하는 일에 지쳤을 것이다.
엔지니어링 시간은 수작업 검증이나 부서지기 쉬운 연동에 낭비하기엔 너무 값지다. 예산과 데이터 무결성을 함께 존중하는 시스템이 필요하다. 이 글에서는 엔터프라이즈 구독의 부담 없이 확장 가능한 문서 파이프라인을 만드는 방법을 다룬다. 사용한 만큼만 내는 과금 구조, 바운딩 박스로 검증되는 데이터, 개발 환경에 바로 붙는 CLI 기반 워크플로의 원리를 하나씩 풀어 본다. 군더더기에 돈을 쓰는 대신, 정밀도와 검증 가능한 결과를 우선하는 파이프라인을 만들 때다.
핵심 요약
- 문서 처리 예산을 부풀리는 "좌석당" 라이선스와 월 최소 청구액이라는 숨은 누수를 찾아내고 없앤다.
- 단순 텍스트 추출과 구조화된 필드 데이터를 구분해, 검증된 고신뢰 정보만 데이터베이스에 들어가도록 한다.
- 성공한 추출에 대해서만 과금하는 사용량 기반 모델을 채택해 스타트업용 저비용 OCR을 구현한다.
- CLI 기반 워크플로와 HMAC 서명 웹훅을 이용한 안전한 비동기 자동화로 개발 속도를 높인다.
- 바운딩 박스로 원본 문서 위의 데이터 좌표를 직접 대조 검증해 수작업 QA 시간을 줄인다.
목차
- 구독의 함정을 넘어서: 스타트업이 OCR에 과지출하는 이유
- 저비용 OCR 벤치마크: 정확도, 속도, 검증 가능성
- 2026년 OCR 가격 모델 해부
- 군더더기 없는 문서 파이프라인 만들기: 연동 전략
- space-ocr: 스타트업을 위한 제로 블로트 인프라
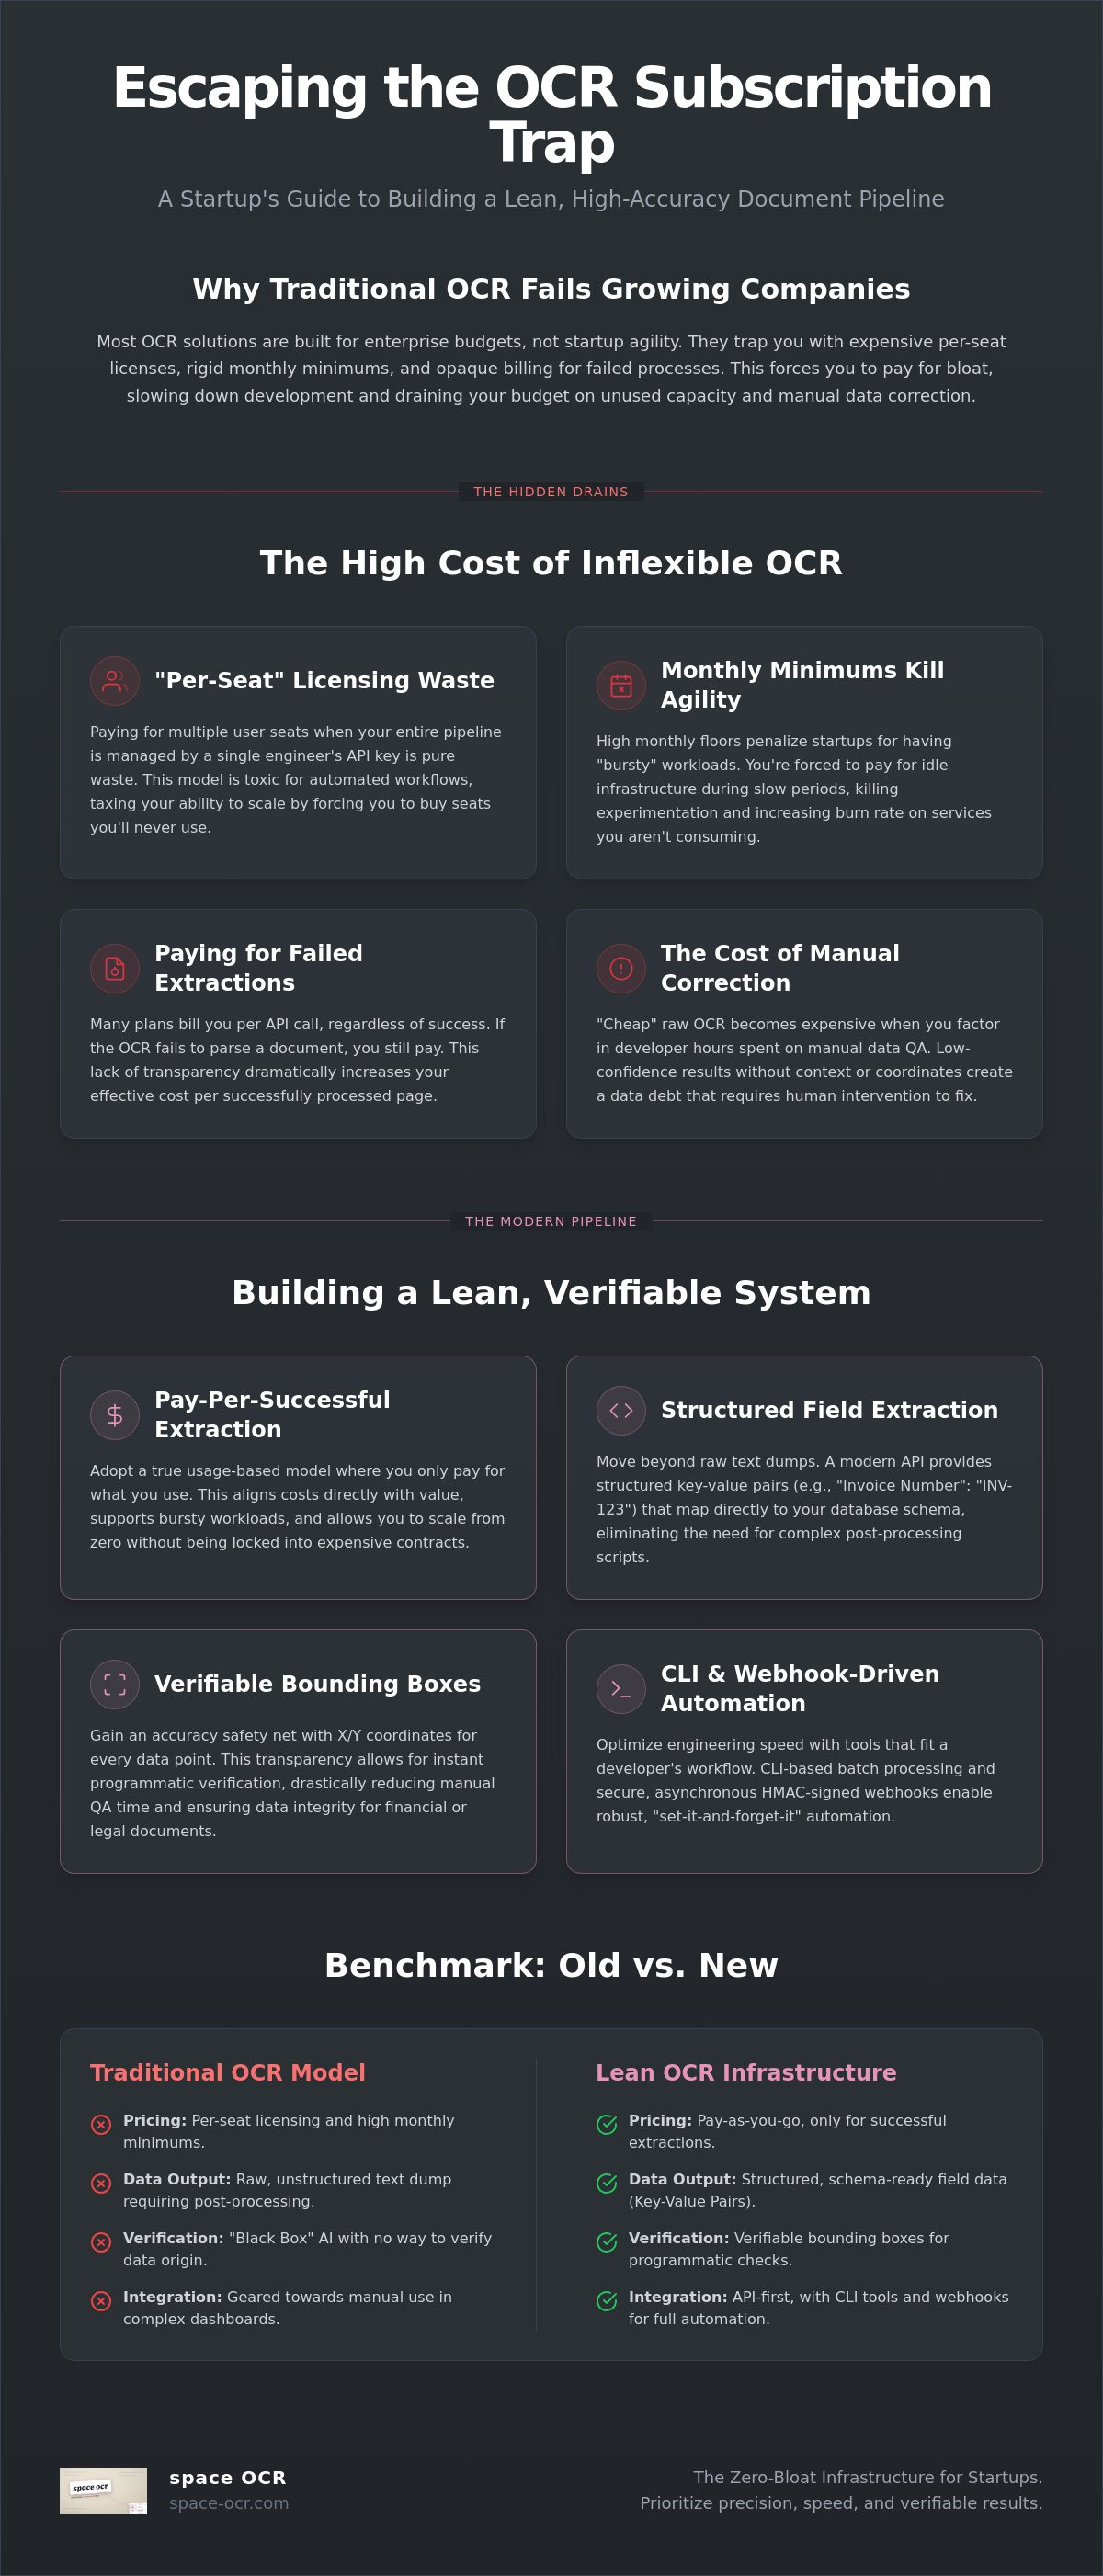
구독의 함정을 넘어서: 스타트업이 OCR에 과지출하는 이유
스타트업은 엔터프라이즈 기능을 운영 효율과 혼동하곤 한다. 전통적 벤더 대부분은 신생 기업의 변동성 큰 성장 주기가 아니라 예측 가능한 대기업 예산에 맞춰 가격을 설계한다. 이 어긋남이 구독의 함정을 만든다. 성능이 아니라 잠재력에 돈을 내게 되는 것이다. 스타트업에 맞는 저비용 OCR을 찾는 일은 가장 낮은 표면 단가를 좇는 게 아니라, 놀고 있는 인프라에 비용을 강제하는 구조적 군더더기를 피하는 것이다. 부풀려진 월 최소 청구액으로 벤더의 영업팀을 대신 먹여 살릴 이유는 없다.
"좌석당" 라이선스 모델은 기술적 문서 워크플로에 특히 해롭다. 파이프라인을 엔지니어 한 명이 광학 문자 인식(OCR) API로 관리한다면, 필수로 요구되는 다섯, 열 개의 사용자 좌석 비용은 순수한 낭비다. 이런 좌석은 배치 처리나 웹훅 같은 상위 기능을 쓰기 위한 전제 조건인 경우가 많아, 결국 확장하려는 시도 자체에 세금을 매기는 셈이다. 이 모델은 가치가 대시보드에 로그인한 사람 수가 아니라 데이터 처리량에 있다는 현대 자동화의 현실을 무시한다.
월 최소 청구액도 비슷한 장벽이다. 실험과 방향 전환 속도를 죽인다. 문서 파싱이 필요한 새 기능을 테스트하는 중이라면, 제품-시장 적합성을 검증하기도 전에 높은 월 하한선으로 페널티를 받아선 안 된다. 이 "몰리는 워크로드" 문제는 대다수 초기 팀의 현실이다. 한산한 달에는 잠들어 있다가 마케팅 캠페인이나 시즌 급증이 오면 즉시 확장되는 시스템이 필요하다. 이 유연성이 없으면, 소비하지도 않는 서비스 때문에 번 레이트만 올라간다.
정액 월 구독의 문제
정액제는 예측 가능성이라는 착시를 주면서 경직된 확장 제약을 숨긴다. 이런 요금제는 파일 크기 제한이나 특정 내보내기 형식 같은 단 하나의 기능 게이트에 걸려, 팀을 필요 이상으로 상위 등급에 강제로 올리는 경우가 많다. "성공한" 추출과 "실패한" 추출의 구분도 투명하지 않다. API 호출이 문서 파싱에 실패했는데도 요청 건으로 청구된다면, 실효 페이지 단가는 올라간다. 단순히 붙여 쓰면 되는 도구여야 할 것에 불필요한 도입 마찰이 생기는 것이다. space-ocr 웹앱처럼 말이다.
문서 AI의 총소유비용(TCO)
진짜 비용은 API 청구서만이 아니다. 연동에 들어간 개발자 시간과 수작업 데이터 교정 비용이 포함된다. OCR 엔진이 좌표 없이 낮은 신뢰도의 데이터를 반환하면, 팀은 수작업 QA에 몇 시간을 쏟는다. 검증 가능한 바운딩 박스를 주는 구조화 필드 OCR API를 쓰면 이 하류 단계의 데이터 정리가 줄어든다. "싼" 단순 OCR은, 2차 AI 계층이나 사람의 개입으로 고쳐야 하는 데이터 부채를 물려받았음을 깨닫는 순간 비싸진다. 스타트업용 저비용 OCR을 구현한다는 것은 첫 호출부터 구조화되고 검증 가능한 출력을 주는 도구를 고른다는 뜻이다.
저비용 OCR 벤치마크: 정확도, 속도, 검증 가능성
정확도는 상수가 아니라 변수다. 데이터베이스 기반 애플리케이션을 만드는 개발자에게 단순 텍스트 문자열은 종종 부채다. 필요한 것은 스키마에 바로 매핑되는 구조화 필드, 즉 키-값 쌍이다. 스타트업용 저비용 OCR이 자주 무너지는 지점이 바로 여기다. 기본 엔진은 맥락 없이 텍스트를 쏟아내고, 팀은 그 데이터를 쓸 만하게 만들려고 복잡한 정규식이나 후처리 스크립트를 짜야 한다. 데이터베이스가 "송장 번호"와 "합계 금액"을 요구한다면, 단순 텍스트 스트림으로는 부족하다. 문서 구조를 이해하는 엔진이 필요하다.
다음 벤치마크는 지연 시간이다. 사용자가 결과를 기다리는 실시간 애플리케이션은 긴 처리 지연을 감당할 수 없다. 글로벌을 지향하는 스타트업이라면 다국어 지원도 따져야 한다. 영어 문서에서만 잘 되는 엔진은 일본어, 한국어, 중국어 등 다른 문자를 처리할 때 실패해 파이프라인에 조용한 데이터 손상을 남긴다. space-ocr은 문서 언어를 자동으로 감지한다. 한 엔진이 언어 파라미터나 선택기 없이 일본어, 한국어, 중국어, 영어 텍스트를 처리하므로, 언어 폭을 넓히는 데 별도 연동 비용이 들지 않는다.
검증 가능한 바운딩 박스: 정확도의 안전망
바운딩 박스는 추출된 모든 값을 페이지 위에서 위치로 짚어 준다. space-ocr은 네 개의 정수 xmin, ymin, xmax, ymax를 0–1000 정규화 그리드로 반환한다. (0,0)이 좌상단, (1000,1000)이 우하단이다. 렌더된 이미지 위에 박스를 그리려면 픽셀로 되돌려 스케일하면 된다. 예를 들어 pixel_x = xmin / 1000 * image_width다. 여기서 image_width는 data.image.width, 즉 실제로 판독한 지면의 크기이며 보낸 파일의 크기와 항상 같지는 않다. data.cells의 각 항목은 좌표 옆에 판정의 근거도 함께 싣는다. evidence.match_ratio는 모델의 자기 확신 점수가 아니라, 그 값의 문자 중 몇 퍼센트가 페이지의 OCR 감지 심볼 사이에서 실제로 발견됐는지를 나타내는 비율이다. 검토 대상은 별도의 표면으로 내려온다. data.review.flagged가 { path, reasons } 목록으로 결론이 서지 않은 값을 모아 주고, 같은 사유가 셀 쪽 cells[path].review.reasons에도 랭킹 순으로 담긴다(0번이 대표다 — text_mismatch, low_ratio, missing 등). cells[path].verified는 그 판정의 거울이라, 무언가 걸리면 false, 대조가 돌았고 아무것도 서지 않으면 true, 대조할 대상이 없었으면 null이다. "블랙박스"를 믿는 대신, 각 값이 어느 영역에서 왔는지에 대한 근거를 손에 쥐게 된다. IBM의 OCR 설명을 보면 공간 인식이 데이터 무결성에 얼마나 근본적인지 알 수 있다. 그러면 사람이 개입하는(HITL) 검토를 flagged에 오른 필드로만 한정할 수 있고, 대기 건수는 flagged.length 그 자체라 수작업 QA 부담이 줄어든다.
인프라 비교: 클라우드 대기업 대 특화 API
AWS나 Google 같은 클라우드 제공자는 기본 텍스트 감지의 표시 단가가 낮다. 다만 각 사의 공표 가격은 바뀌므로, 비용을 산정하기 전에 최신 가격 페이지를 확인하는 편이 좋다. 실제로 갈리는 지점은 구조화 데이터를 위한 구현 복잡도다. 그들의 원시 출력 위에 파싱 로직을 직접 쌓아야 한다. 반대편의 엔터프라이즈 플랫폼은 구조화 출력을 주지만 부담스러운 월 최소 청구액을 요구한다. 구조화 필드 OCR API 같은 특화 도구는 그 중간을 제공한다. 스타트업에 필요한, 쓴 만큼 내는 유연성과 함께 구조화 추출을 준다. 덕분에 데이터 정밀도나 개발자 시간을 희생하지 않으면서 스타트업용 저비용 OCR 전략을 확장할 수 있다.
2026년 OCR 가격 모델 해부
2026년의 가격 전략은 불투명한 등급제에서 벗어나 세밀하고 이벤트 기반인 과금으로 옮겨 갔다. 만드는 사람 입장에서 가장 효과적인 스타트업용 저비용 OCR은 "실패 세금"을 없앤 것이다. 오류를 반환하거나 쓸 만한 결과를 내지 못한 문서에는 돈을 내지 않아야 한다. 성공한 경우에만 과금하는 이미지당 100원 같은 모델은, 번 레이트를 벤더 서버의 간접비가 아니라 제품의 실제 유용성에 직접 묶는다. 런웨이를 존중하는 실용적 인프라 접근이다.
실시간 동기 호출은 사용자 대상 검증에 유용하지만, 유일한 선택지여서는 안 된다. 웹훅을 쓰는 배치 처리는 급하지 않은 추출을 비동기 큐로 넘긴다. 배치를 제출하면 엔진이 순서대로 처리하고, 각 결과가 준비될 때마다 엔드포인트가 ocr.completed 이벤트를 받는다. 인프라에 걸리는 부담이 줄어든다. 빠른 프로토타이핑에는 신용카드 없는 무료 등급도 도움이 된다. space-ocr은 매달 무료 스캔 100회를 제공하므로, 프로덕션에 단돈 한 푼 쓰기 전에 엣지 케이스를 테스트하고 스키마 호환성을 확인할 수 있다. 도구가 청구 주기에 닿기 전에 그 동작을 먼저 검증하는 것이다.
사용한 만큼 내는 OCR이란?
이 모델은 과금을 성공한 추출 이벤트에만 엄격히 묶는다. 사용자와 제공자의 이해관계를 일치시킨다. 엔진이 복잡한 표나 흐린 스캔을 파싱하지 못하면 돈을 내지 않는다. 실패는 과금하지 않으며, 동기 호출이 처리 상한인 180초를 넘겨도 과금되지 않는다. 지출 예측은 사용자 증가의 단순한 함수가 된다. 사용자당 평균 문서 수를 안다면 OCR 비용을 상당히 정확히 추정할 수 있다. 페이지 임계값을 넘는 순간 더 많은 돈을 요구하는 구독 모델 특유의 갑작스러운 "등급 상승" 충격을 피할 수 있다.
"무제한" OCR 요금제의 신화
"무제한"은 마케팅 용어일 뿐 기술적 현실이 아니다. 이런 요금제는 대개 공격적인 스로틀링이나 "공정 사용" 정책을 숨기고 있어, 정작 가장 필요한 순간에 처리량을 묶는다. 진지한 데이터 아키텍처에 필요한 세밀한 감사 추적도 없는 경우가 많다. 투명한 이미지당 기록은 컴플라이언스와 디버깅에 필요한 검증 가능한 증거를 준다. 무엇이 처리됐는지, 각 값을 페이지 위 제자리에 고정하는 좌표(바운딩 박스)가 무엇인지 정확히 볼 수 있다. 데이터를 블랙박스로 취급하는 정액제에는 그 수준의 세부 정보가 없다. 투명성이야말로 스타트업용 저비용 OCR을 규모가 커져도 신뢰할 수 있게 지켜 준다.
군더더기 없는 문서 파이프라인 만들기: 연동 전략
어떤 인터페이스를 고르느냐가 운영 속도를 결정한다. REST API가 프로덕션 시스템의 뼈대이긴 하지만, 스타트업용 저비용 OCR 전략에는 이해관계자별로 다른 CLI와 웹앱 접근도 포함되어야 한다. 개발자는 빠른 테스트와 로컬 자동화를 위한 터미널 도구를 원하고, 운영팀은 예외를 관리하고 엣지 케이스를 검증할 GUI를 원한다. 수작업 입력에서 자동 파싱으로 넘어가려면, 이 서로 다른 워크플로를 아키텍처 부담 없이 다루는 파이프라인이 필요하다.
자동화 파이프라인에서 보안은 나중 문제가 될 수 없다. HMAC 서명 웹훅은 수집 엔드포인트가 제공자에게서 온 검증된 페이로드만 처리하도록 보장한다. space-ocr은 모든 전송을 X-Spaceocr-Signature 헤더(HMAC-SHA256)로 서명한다. 이는 위조를 막고 확장하는 동안 데이터 무결성을 지킨다. 웹훅을 통한 비동기 처리는 OCR 엔진이 백그라운드에서 무거운 일을 처리하는 동안 애플리케이션이 계속 응답하게 해 준다. ocr.completed 이벤트를 수신하고 서명을 검증한 뒤 구조화 데이터를 데이터베이스에 넣으면 된다. 서버 측 대기를 최소화하는 깔끔하고 느슨하게 결합된 아키텍처다. 재시도 설계를 좌우하는 운영상의 상한이 둘 있다. 키 하나당 분당 60요청이고, 그것을 넘기면 HTTP 429가 돌아온다. 그리고 Idempotency-Key 헤더를 붙이면 24시간 안의 같은 요청은 캐시된 응답을 그대로 되돌려 주므로 스캔 비용을 두 번 내지 않는다. 재전송을 위한 안전장치이지 보관 수단은 아니다.
space-ocr 웹앱에서 문서를 "Spaces"로 정리하면 팀 협업과 질서 있는 데이터 보관이 쉬워진다. 프로젝트, 고객, 유형별로 문서를 묶어, 내보내기 전에 추출 결과를 감사하기 좋다. 앱 안에서는 여러 시트를 가로지르는 키워드 검색으로 원하는 값을 찾고 키보드로 그리드를 이동한다. 프로그래밍 방식 접근에는 GET /view API가 있는데, 저장된 시트에 대해 OCR을 다시 돌리거나 과금하지 않고 서버 측에서 where, sort, select 필터를 실행한다. 비기술 팀원도 값과 바운딩 박스를 검토해 엔진이 필드를 올바로 매핑했는지 확인할 수 있다. 검증이 끝나면 CSV로 내보내 내부 시스템에 채우면 된다.
단계별: CLI에 OCR 붙이기
Claude Code용 space-ocr 플러그인으로 추출을 터미널에 가져올 수 있다. 설치는 두 줄이다. /plugin marketplace add oisidonut/claude-space-ocr-skill 다음 /plugin install space-ocr@space-ocr. 의존성 없는 Python 클라이언트로 space-ocr REST API와 통신하므로 pip 설치도, SDK도 필요 없다. 이미 MCP 클라이언트를 쓰는 팀이라면 같은 API를 https://mcp.space-ocr.com/mcp 로 붙일 수 있다. Claude Code에서는 claude mcp add --transport http space-ocr https://mcp.space-ocr.com/mcp --header "Authorization: Bearer YOUR_API_KEY" 한 줄이면 되고, 어느 경로든 따로 설치할 것은 없다. 여기서부터 문서 이미지(청구서, 영수증, 명함, 신분증, 양식)를 스키마에 매핑되는 구조화 JSON으로 바꾸거나, 이미 스캔한 문서에 질의할 수 있다. 개발 환경을 떠날 필요가 없다. 보통 초기 개발 주기를 늦추는 맥락 전환을 없애 준다.
지저분한 데이터 다루기: 영수증, 청구서, 손글씨
저품질 팩스나 손글씨 메모에서의 추출은 일관된 정규화의 덕을 본다. space-ocr은 이 두 가지 일을 갈라 둔다. data.values에는 지면에 인쇄된 표기가 그대로 남는다. 쉼표, 소수점, 전각 문자가 페이지에 나타난 모습 그대로다. 필드에 type: "date"・"number"・"integer"를 선언하면 data.normalized라는 두 번째 층이 더해진다. values와 똑같은 모양의 트리이고, 선언한 리프만 결정론적 파서가 해석한 값으로 들어온다. 타입은 모델에 전달되지 않으므로, 달라지는 것은 돌려받는 내용이지 지면을 읽는 방식이 아니다. 화면에 보여 줄 때는 values, 계산과 데이터베이스 컬럼에는 normalized를 쓰면 된다. 해석하지 못한 리프는 normalized에서 null이 되고 사유는 cells[path].normalized.error에 남으며, 그 필드는 review.flagged에 type_mismatch로 오른다. 읽히지 않는 날짜가 조용히 틀린 행이 아니라 확인 거리로 드러나는 것이다. 같은 선언은 직접 짜서 유지해야 했을 검증 코드를 대신하기도 한다. required는 값이 비면 missing을 세우고, pattern과 enum은 값이 정한 형식이나 이미 갖고 있는 어휘 집합에서 벗어나면 pattern_mismatch를 세우며, min / max는 해석된 숫자에 대해 out_of_range를 세운다. 이렇게 하면 문서 품질과 무관하게 스타트업용 저비용 OCR 파이프라인이 신뢰할 수 있는 단일 출처로 유지된다. 참고로 엔진과 API는 래스터 이미지(JPEG, PNG, GIF, BMP, TIFF, WebP)를 받는다. 웹앱에 멀티페이지 PDF를 끌어다 놓으면 각 페이지를 PNG로 래스터화한 뒤 OCR을 실행한다.
오늘 구조화 필드 OCR API를 스택에 연동해 자동화 워크플로를 만들기 시작하자.
space-ocr: 스타트업을 위한 제로 블로트 인프라
space-ocr은 VC 자금을 받은 플랫폼들이 선호하는 부풀린 기능보다 순수한 실용성을 우선한다. 창업자에게 스타트업용 저비용 OCR 탐색은 실패한 요청에 돈을 내지 않게 되는 순간 끝난다. 이미지당 100원 모델은 실제로 쓸 수 있는 데이터에만 자본이 들어간다는 뜻이다. 엔진이 유효한 결과를 반환하지 못하면 잔액은 그대로 남는다. 이 이해관계의 일치가, 마케팅 약속보다 정밀도를 중시하는 사람들을 위해 만든 제로 블로트 인프라의 토대다.
프로덕션에서 정밀도는 타협 대상이 아니다. space-ocr은 추출된 모든 필드에 바운딩 박스를 반환하므로, 시스템은 각 값이 지면의 어디에서 왔는지에 대한 근거를 갖게 된다. 좌표의 유일한 출처는 OCR 패스이고, 값을 읽는 멀티모달 모델이 좌표를 만드는 일은 없다. 엔진은 추출된 각 값을 페이지의 실제 OCR 심볼과 문자 단위로 대조해 match_ratio로 점수를 매긴다. 그래서 지면과 맞아떨어지지 않는 값은 조용히 통과하는 대신 review.flagged에 드러난다. 한 엔진에서 일본어, 한국어, 중국어, 영어를 자동 언어 감지로 처리하므로, 파이프라인은 여러분의 글로벌 야심과 함께 확장된다. 엔터프라이즈 계약 없이도 확보하는 언어 폭이다. 개발자 우선의 표면에는 Claude Code용 space-ocr 플러그인과 완전한 구조화 필드 OCR API 문서가 포함되어, 읽는 시간은 줄이고 출시하는 시간은 늘릴 수 있다.
초기 팀에게 space-ocr이 강한 이유
초기 팀은 도입 절차에 발목 잡히지 않고 빠르게 움직여야 한다. 방향 전환 속도를 늦추는 좌석당 라이선스나 숨은 플랫폼 비용이 없다. 앱 안에서는 여러 시트를 가로지르는 키워드 검색으로 추출된 값을 찾고, 프로그래밍 방식 접근에는 GET /view API가 저장된 데이터에 대해 서버 측에서 where, sort, select 필터를 실행한다. 레거시 데이터를 다루는 경우, 비동기 /upload와 웹훅을 조합하면 요청을 열어 둔 채 기다리지 않고 문서 백로그를 처리할 수 있다. 사용량이 늘 때만 함께 커지는 인프라다. 놀고 있는 용량이나 쓰지 않는 좌석에 돈을 내지 않는다. 애플리케이션을 움직이는 데이터에 대해서만 낸다.
몇 주가 아니라 몇 분 만에 시작
새 문서 파이프라인을 테스트하는 데 영업 통화나 신용카드가 필요해선 안 된다. 무료 등급, 매달 100회 스캔으로 추출을 살펴보며 자신의 문서 세트에 대한 정확도를 검증할 수 있다. 첫 웹훅 설정은 몇 분이면 되고, 복잡한 미들웨어 없이 기존 스택으로 안전하게 데이터를 수집할 수 있게 해 준다. 로컬 워크플로에 Claude Code용 space-ocr 플러그인을 쓰든, 수작업 감독에 space-ocr 웹앱을 쓰든, 연동은 가볍게 유지된다. 문서 처리에 과지출하는 것을 멈추고, 현대 스타트업 스택을 위해 설계된 고정밀 엔진 위에서 만들기 시작할 때다.
space-ocr.com에서 첫 문서를 무료로 처리하기
구독이 아니라 정밀도 위에 파이프라인을 세워라
스타트업에는 쓰지 않는 좌석이나 실패한 API 호출에 자본을 낭비할 여유가 없다. 낡은 가격 모델과 경직된 구독이 개발 파이프라인에 어떤 불필요한 마찰을 만드는지 보았다. 구조화 필드 추출과 검증 가능한 데이터에 집중하면, 쓴 돈이 모두 제품의 신뢰성에 직접 기여하게 된다. 스타트업용 저비용 OCR을 구현한다는 것은 아키텍처의 투명성과 사용량 기반 확장에 관한 것이다. 엔터프라이즈 계약의 부담 없이 정밀도를 제공하는 시스템이 필요하다.
space-ocr은 이미지당 100원 모델과 모든 필드에 대한 검증 가능한 바운딩 박스로 이를 실현한다. 발목을 잡는 숨은 비용이나 월 최소 청구액이 없고, 매달 100회 스캔은 무료다. 문서 파이프라인의 정확도를 바로 검증할 수 있으며, 자신의 구체적인 사용 사례를 테스트하는 데 신용카드가 필요 없다. 마케팅 수사보다 순수한 실용성과 기술적 정직함을 중시하는 팀을 위한 실용적 해법이다.
space-ocr로 무료로 데이터 추출을 시작하고 엔지니어링 시간과 예산을 존중하는 문서 파이프라인을 만들자. 데이터에는 정밀도가, 런웨이에는 존중이 필요하다. 이제 멋진 걸 만들 차례다.