바운딩 박스로 구조화 필드 OCR API 구현하기 (2026)
좌표가 붙은 구조화 필드 OCR API를 2026년 기준으로 구현하는 실무 가이드 — 검증 가능하고 감사에 대응되는 문서 데이터 파이프라인.
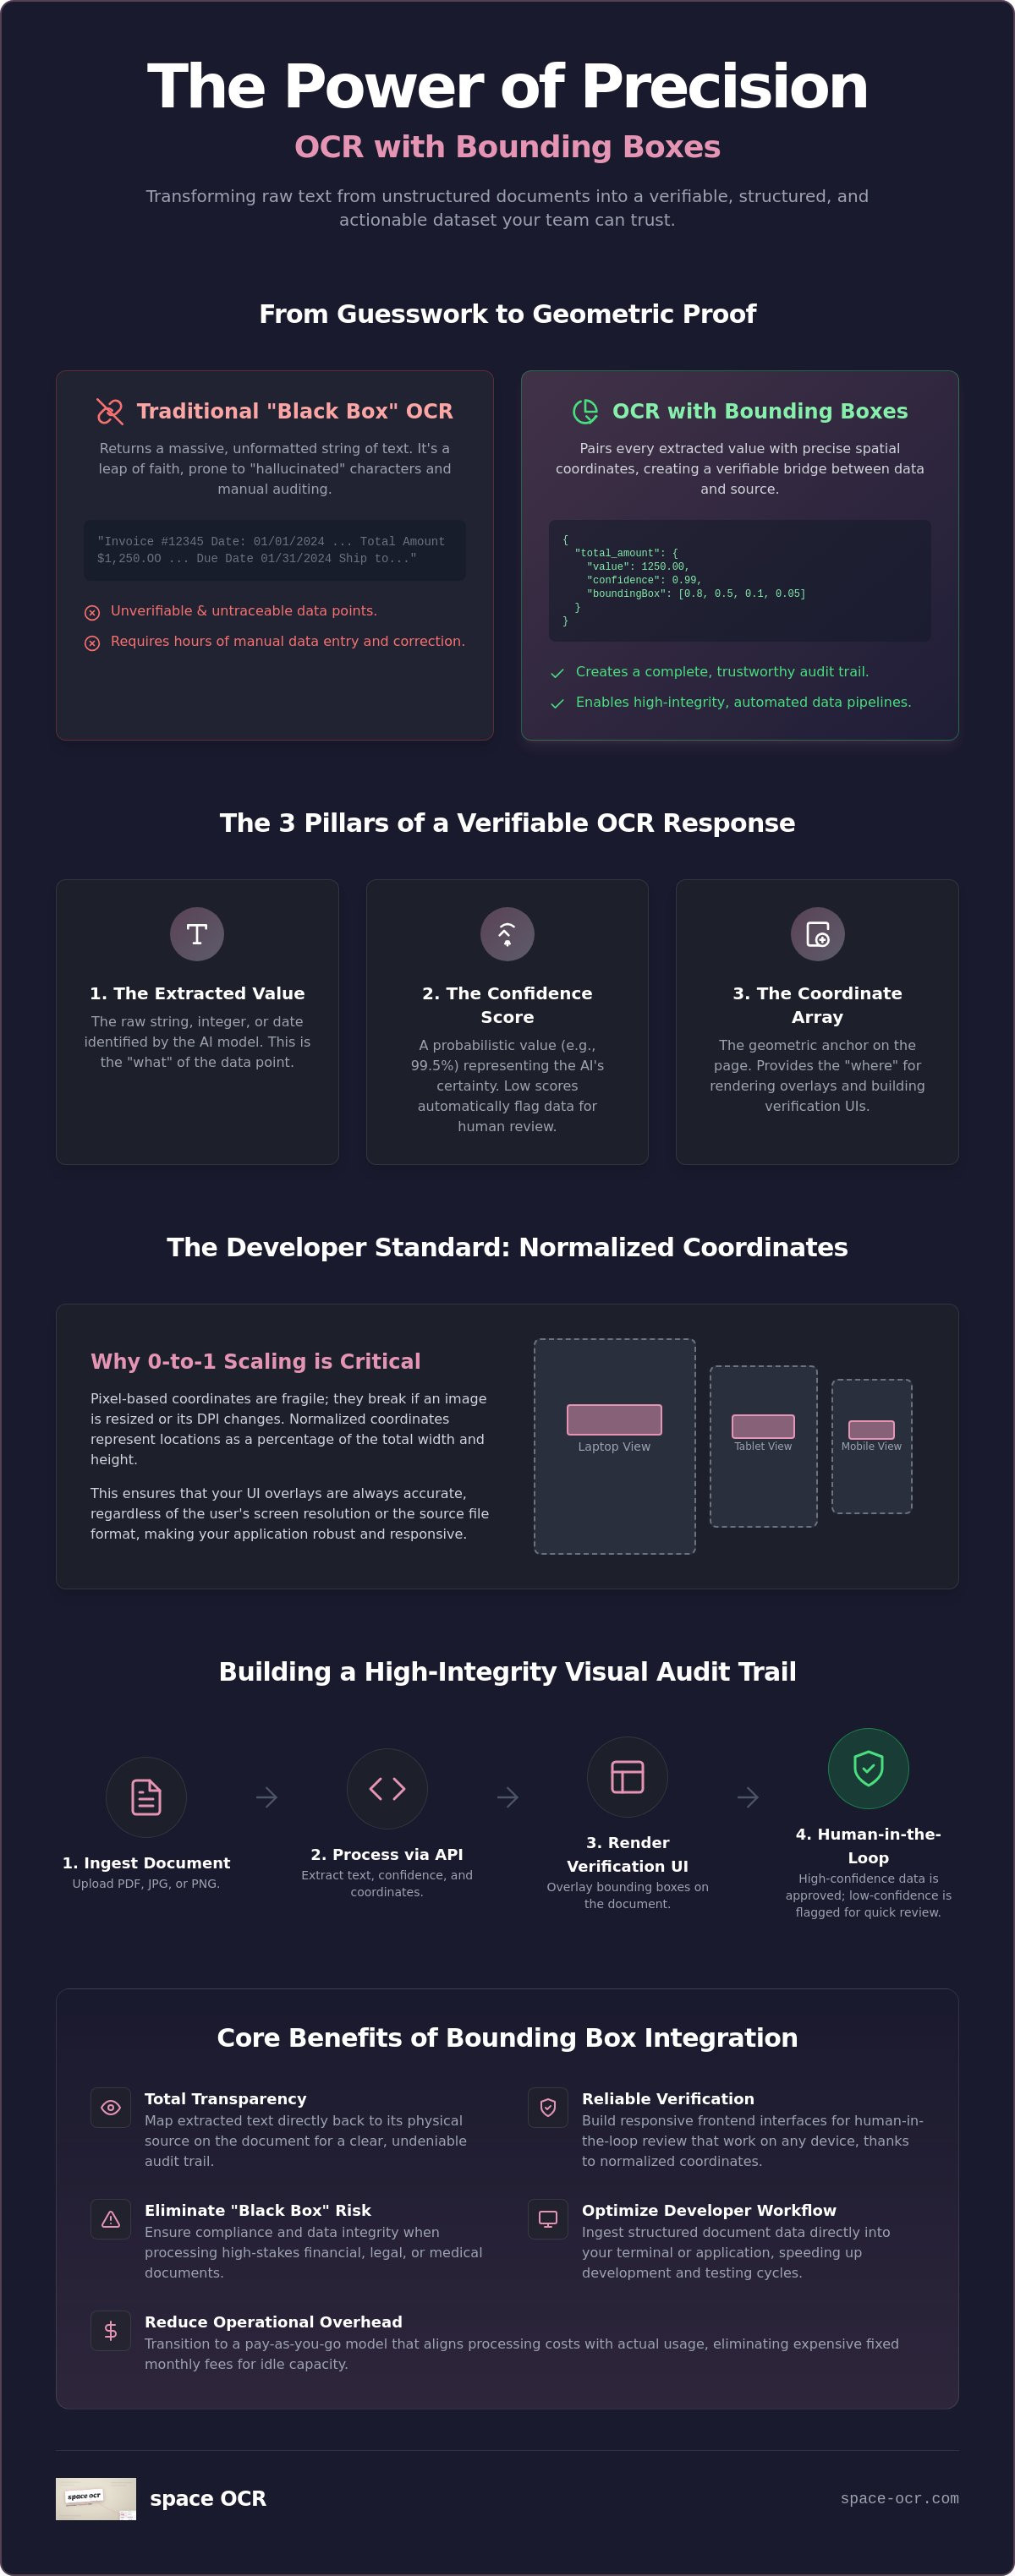
좌표가 없는 텍스트 문자열은 데이터가 아니라 추측에 가깝다. 블랙박스 추출기가 만들어낸 "환각" 문자를 손으로 몇 시간씩 대조해 본 적이 있다면, 프로덕션 수준 자동화에는 원문 텍스트만으로는 부족하다는 걸 이미 알 것이다. 데이터가 문서의 어디에서 나왔는지 정확히 볼 수 있어야 한다. 바운딩 박스가 붙은 OCR API를 붙이면 워크플로가 "믿고 넘기는" 단계에서 "검증 가능한 감사 기록"으로 바뀐다. 고정 구독료와 확장이 안 되는 경직된 처리 모델의 비효율에서 벗어나기 위한 기술적 토대이기도 하다.
이 글에서는 이런 공간 좌표를 활용해 무결성이 높은 구조화 데이터 파이프라인을 세우고, 사람이 최종 확인하는(human-in-the-loop) 검증을 안정적으로 붙이는 방법을 살펴본다. JSON 출력을 문서의 영역에 그대로 매핑하는 원리, 그리고 실제 작업량에 맞춰 확장되는 시스템을 어떻게 설계하는지를 짚는다. 구조화 필드 추출, 2026년 비전-언어 모델로의 전환, 그리고 수기 입력을 "검토만" 하면 되는 수준까지 줄이는 데 필요한 로직을 정리한다. 다 읽고 나면 비정형 문서를 팀이 실제로 신뢰할 수 있는 정확하고 실행 가능한 데이터셋으로 바꾸는 설계도가 손에 남을 것이다.
핵심 요약
- 바운딩 박스가 붙은 OCR API가 정밀한 공간 좌표로 추출 텍스트를 실제 원문 위치에 그대로 매핑해 완전한 투명성을 확보하는 방식을 이해한다.
- 0–1000 정규화 좌표 그리드가 화면 크기와 이미지 DPI에 상관없이 프론트엔드 검증 오버레이를 안정적으로 유지해 주는 이유를 파악한다.
- 시각적 감사 기록을 구현해 "블랙박스" 위험을 없애고, 금액·법률처럼 부담이 큰 문서 처리를 감사 가능하게 유지한다.
- Claude Code 플러그인으로 터미널에서 바로 REST API를 호출한다 — 의존성 없는 Python 클라이언트를 두 줄로 설치한다.
- 고정 월정액 대신 실제 처리량에 비용을 맞추는 종량제로 옮겨 운영 부담을 줄인다.
목차
- 바운딩 박스가 붙은 OCR API란?
- 기술 아키텍처: 좌표, JSON, 신뢰도
- 왜 검증 가능성이 문서 데이터의 새 기준인가
- 개발 워크플로에 바운딩 박스 통합하기
- space-ocr: 마찰 없는 종량제 구조화 데이터
바운딩 박스가 붙은 OCR API란?
일반적인 광학 문자 인식(OCR) 엔진은 보통 형식 없는 거대한 텍스트 문자열을 돌려준다. 단순 검색 색인에는 쓸 만하지만 자동화된 데이터 파이프라인에서는 무너진다. 바운딩 박스가 붙은 OCR API는 추출한 필드마다 문서상의 정확한 공간 위치를 함께 붙여 주는 특화 인터페이스다. 모든 값에 대해 좌표 — 0–1000 정규화 그리드 위의 xmin, ymin, xmax, ymax 정수 박스 — 를 돌려주면서, 디지털 데이터와 물리적 원문 사이에 다리를 놓는다. 단순히 "$1,250.00" 같은 값만 받는 게 아니라, 그 값이 페이지의 어디에 있는지까지 받는 것이다.
이 차이가 구조화 추출에서는 결정적이다. 전통적 OCR은 문서를 평평한 텍스트 파일로 다룬다. 구조화 OCR은 문서를 데이터 객체의 모음으로 다룬다. 2026년 들어 업계는 원문 텍스트를 통째로 쏟아 내는 방식에서 검증 가능한 데이터 구조 쪽으로 옮겨 갔다. 시스템이 사업자번호를 추출한다면, 검증 UI에서 그 필드를 프로그램적으로 강조 표시할 수 있어야 한다. 바운딩 박스가 없으면 페이지 전체를 다시 읽는 것 말고는 모델의 작업을 감사할 방법이 없다. 부담이 큰 워크플로에서 좌표 없는 텍스트 문자열은 책임 리스크가 된다.
바운딩 박스 vs. 바운딩 리전
대부분의 구현은 표준 4점 사각형을 쓴다. 이런 바운딩 박스는 계산 비용이 낮고 디지털 원본 페이지나 깔끔하게 스캔된 양식에서 잘 작동한다. 하지만 실제 문서는 기울거나 회전하거나 구겨진 채로 들어오는 경우가 많다. 그런 경우 축에 정렬된 단순 박스만으로는 부족하다. space-ocr은 축 정렬 box(정수 xmin/ymin/xmax/ymax)와, 문서의 기울기를 따라가는 4점 방향성 quad(좌상·우상·우하·좌하 순서) 두 가지를 함께 돌려준다. 덕분에 왜곡되거나 회전된 레이아웃에서 단순 박스로는 낼 수 없는 정밀도를 얻으면서, 나머지 경우에는 단순 박스를 그대로 쓸 수 있다.
현대 OCR 응답의 핵심 구성 요소
POST /ocr/fields 가 돌려주는 data 는 네 개의 층으로 되어 있다. 층마다 대답하는 질문이 다르고 그중 그대로 데이터베이스에 들어가는 것은 하나뿐이라, 나눠서 볼 값어치가 있다.
data.values— 업무 데이터 그 자체다. 선언한 스키마와 같은 모양이고 예약 키가 섞이지 않아 그대로 저장할 수 있다. 다만 인쇄물의 바이트 단위 복사본은 아니고, 모델이 페이지를 읽은 문자열이다. 정확 일치로 대조할 때는cells[path].evidence.printed_text(그 좌표에서 OCR 패스가 읽은 글자)를 쓴다.data.cells[path]— 값마다 어디에서 왔고 검사가 무엇을 결론했는지를, path 를 키로 늘어놓은 층이다.total,items[0].amount처럼 조회한다. 각 항목은box(정수xmin/ymin/xmax/ymax)와 4점quad, 판정인verified,null이거나{ reasons }인review, 그리고 근거인evidence(text_match·source·match_ratio·ocr_confidence·printed_text)를 담는다.data.review— 문서 한 장 분의 집계이고,flagged가 기계가 그대로 읽는 검토 목록이다.[{ path, reasons }]형태이고 path 문법은cells의 키와 같다. 검토 건수는flagged.length자체이며 별도 카운터는 없다.by_reason은 검토에 오른 필드의 사유를 전부 세므로, 그 합은 건수보다 클 수 있다.data.normalized— 결정론적으로 해석한 타입 표현이다. 스칼라 타입(number·integer·date)이나pattern·enum을 준string을 선언한 필드에만 붙는다.values와 완전히 같은 모양의 성긴 트리라normalized.total이values.total옆에 놓인다. 해석은 결정론적이고 추가 모델 호출이 없으며, 해석하지 못한 리프는null이 되고 이유는cells[path].normalized.error에 남는다.
이 넷 옆에 data.image(픽셀 단위 width·height)가 있고, 모든 좌표는 이것을 기준으로 잰 값이다.
추출이 투명해지는 것은 층을 이렇게 갈라 놓았기 때문이다. 로직의 게이트로 삼을 것은 조정해야 하는 임계값이 아니라 조건 하나다 — 셀의 review 가 null 이면 돌아간 검사를 전부 통과한 것이고, verified: true 가 말하는 것도 같은 사실이다. match_ratio 가 사라진 것은 아니다. 판정 뒤편의 evidence 안에 신호 하나로 남아 있을 뿐, 판정 자체는 아니다. 값이 페이지의 어느 자리에서 와야 하는지를 지정하고 싶다면 요청 쪽에서 말할 수 있다. label 은 지정한 라벨 옆 등장에 좌표를 앵커하고, near / not_near 는 값 옆에 인쇄돼 있어야 할(또는 있으면 안 되는) 어휘를 선언한다. 이 정도의 제어가 단순 문자 인식과 구조화 필드 OCR API 를 가르는 지점이다.
기술 아키텍처: 좌표, JSON, 신뢰도
문서 파이프라인을 세우려면 문자 감지 이상이 필요하다 — 데이터에 대한 공간적 이해가 있어야 한다. 바운딩 박스가 붙은 OCR API를 붙일 때 가장 중요한 아키텍처 결정은 좌표를 어떻게 다룰지다. 원시 픽셀 좌표는 취약하다. 전처리 과정에서 원본 이미지를 리사이즈하거나 재인코딩하거나 DPI를 조정하면 절대 픽셀 값은 쓸모없어진다. 그래서 space-ocr은 픽셀 대신 0–1000 정규화 그리드로 좌표를 돌려준다. (0,0)이 좌상단, (1000,1000)이 우하단이며, 이미지의 실제 픽셀 크기와 무관하다. 박스를 그리려면 다시 스케일업하면 된다 — pixel_x = xmin / 1000 * image_width — 그래서 프론트엔드는 기저 기하 계산을 다시 하지 않고도 어떤 해상도에서든 오버레이를 렌더링할 수 있다. 이 식의 image_width 는 data.image 에서 가져온다. 여기는 정확히 짚어 둘 값어치가 있다 — data.image 는 실제로 판독된 페이지의 크기다. EXIF 방향이 픽셀에 반영된 뒤(4000×3000 으로 보내도 3000×4000 으로 돌아올 수 있다), 서버 축소가 들어간 뒤의 값이고, 보낸 파일 자체가 아니다. data.image 를 기준으로 그리면 윤곽이 맞고, 원본 파일 크기로 그리면 회전·축소분만큼 어긋난다. 기울기 보정도 하지 않으므로, 기울어진 사진의 quad 는 기울기를 그대로 따라간다.
엔진과 API는 PDF 바이트가 아니라 래스터 이미지 위에서 동작한다. space-ocr 웹앱에 멀티페이지 PDF를 떨어뜨리면 pdf.js로 각 페이지를 PNG로 렌더링한 뒤 그 페이지 이미지들에 OCR을 돌린다. API를 직접 호출할 때는 요청당 이미지 하나를 보내며, PDF 페이지는 먼저 이미지로 변환한다. 모든 좌표는 자기가 나온 페이지 이미지를 기준으로 하므로, 페이지 인덱스가 중첩된 페이로드를 풀어헤칠 일이 없다. 잘못된 데이터가 DB에 들어가지 않게 하려면 수치가 아니라 판정에 게이트를 건다. 셀의 review 가 null 이면(즉 verified: true) 돌아간 검사를 전부 통과한 것이고, 사유가 붙은 것은 data.review.flagged 에 그 사유와 함께 실린다. 사유 어휘는 정해져 있고 문서화돼 있어서(text_mismatch·low_ratio·weak_source·nobox·missing 등) 큐를 점수가 아니라 사유로 나눌 수 있다. 판정의 근거는 evidence 에 들어간다 — source(예: vision_symbol_match), ocr_confidence, 그리고 match_ratio, 즉 그 값의 문자 중 OCR 패스가 페이지에서 검출한 심볼 사이에서 다시 찾아낸 비율(0.0~1.0)이다. 이 비율은 페이지 대비 커버리지이지 모델 자체의 확신도 점수가 아니다. 0.85 이상은 확신 매칭으로 취급하지만, 이것은 판정에 들어가는 입력 하나이지 게이트 그 자체는 아니다. 이렇게 게이트를 두면 검증되지 않은 값은 DB로 들어오지 못하게 막으면서, 커버리지가 높은 추출은 자동으로 흘려보낼 수 있다.
구조화 JSON 응답의 구조
필드 단위 추출은 청구서 번호나 사업자번호 같은 특정 키를 정밀한 기하 앵커에 매핑한다. 표 안의 라인 아이템에서는 이게 좀 더 복잡해진다. 배열 필드가 행으로 펼쳐지고 셀마다 data.cells 안에 첨자 경로로 자기 항목을 갖게 되므로, 행과 열의 관계가 온전히 유지된다. items[0] 같은 행 경로는 그 행 전체의 union box 이고, 그 안의 한 칸이 items[0].amount 다. 이 문법은 review.flagged[].path 와 같아서, 검토에 올라온 경로가 곧 cells 조회 키가 된다.
네 층이 한 번에 보이는 응답을 하나 둔다. 요청에서 선언한 것은 invoice_no·date·items[]·total 이고, cells 는 경로마다 항목을 하나씩 갖기 때문에 여기서는 이야기하는 두 개로 줄였다.
{
  "status": "success",
  "data": {
    "values": {
      "invoice_no": "",
      "date": "2025-04-10",
      "items": [
        { "name": "우유", "qty": "1", "amount": "₩1,980" }
      ],
      "total": "₩4,780"
    },
    "cells": {
      "items[0].amount": {
        "box": { "xmin": 693, "ymin": 460, "xmax": 738, "ymax": 488 },
        "quad": [{ "x": 693, "y": 460 }, { "x": 738, "y": 460 }, { "x": 738, "y": 488 }, { "x": 693, "y": 488 }],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": { "text_match": false, "source": "vision_symbol_match", "match_ratio": 0.62, "ocr_confidence": 0.88 }
      },
      "total": {
        "box": { "xmin": 380, "ymin": 720, "xmax": 530, "ymax": 742 },
        "quad": [{ "x": 380, "y": 720 }, { "x": 530, "y": 720 }, { "x": 530, "y": 742 }, { "x": 380, "y": 742 }],
        "verified": true,
        "review": null,
        "evidence": { "text_match": true, "source": "vision_symbol_match", "match_ratio": 1.0, "ocr_confidence": 0.98 },
        "normalized": { "value": 4780, "type": "number", "method": "deterministic" }
      }
    },
    "review": {
      "unit": "field",
      "declared": 6,
      "returned": 5,
      "boxed": 5,
      "verified": 4,
      "flagged": [
        { "path": "items[0].amount", "reasons": ["text_mismatch"] },
        { "path": "invoice_no", "reasons": ["missing"] }
      ],
      "by_reason": { "text_mismatch": 1, "missing": 1 }
    },
    "normalized": { "total": 4780 },
    "image": { "width": 1654, "height": 2339 }
  }
}
순서대로 읽으면 계약이 보인다. values 는 데이터 그 자체다. cells 는 각 값이 어디에 있고 검사가 무엇을 결론했는지 말한다 — items[0].amount 는 인쇄물과 어긋나 verified: false 와 사유 text_mismatch 로 돌아왔고, total 은 일치해서 근거를 달고 있다. review.flagged 는 작업 목록이다. 그 금액에 더해, required 로 선언했는데 한 번도 돌아오지 않은 invoice_no 가 올라간다. 돌아온 적 없는 값은 대조할 상대가 없어서, 문자 대조가 원리적으로 닿지 못하는 유일한 클래스다. 그리고 normalized 는 values 의 문자열을 건드리지 않은 채 total 의 타입 표현을 담는다. 애플리케이션이 문서를 평면 이미지가 아니라 질의 가능한 데이터셋으로 다룰 수 있는 건 이 모양 덕분이다.
검증은 추출 옆에 있다
좌표는 값이 어디에서 왔는지는 말하지만, 그 값이 그 칸에 들어갈 값인지는 말하지 못한다. 뒤쪽 질문에 답하는 것은 필드를 요청하는 바로 그 요청이다. FieldSpec 은 name·type 옆에 선언을 받고, 선언마다 review 에 대응하는 사유가 준비돼 있다.
required— 빈 값으로 오거나 응답에서 아예 빠진 항목은 사유missing으로 올라온다. 문자 대조가 원리적으로 닿지 못하는 유일한 클래스다.label— 값 옆에 인쇄된 라벨이다. 같은 값이 페이지에 여러 번 찍혀 있을 때 좌표를 그 라벨 옆 등장에 앵커한다. 라벨이 페이지에 정확히 한 번 인쇄됐을 때 작동하고, 못 찾으면 기존 탐색으로 돌아가면서 그 사실이review.notes에label_unresolved로 실린다.pattern— 값이 만족해야 할 정규식이다(string 타입 전용. JSON Schema 와 같은 부분 일치라 값 전체를 보려면^…$를 붙인다). 어기면pattern_mismatch.enum— 업무측이 이미 갖고 있는 값의 집합이다(거래처 마스터, 품목 마스터, 단위 목록). 집합 밖이면pattern_mismatch가 선다. 두 엔진이 같은 오독에 합의해 버리는 클래스에 듣는 유일한 수단이기도 하다 — 글자끼리 맞춰 보는 검증은 양쪽이 같은 실수를 하면 구조적으로 아무 말도 못 한다.min/max—number/integer의 범위다(양끝 포함). 정규화된 수치에 대해 판정하고, 벗어나면out_of_range.near/not_near— 값 옆에 인쇄돼 있어야 할(또는 있으면 안 되는) 어휘다. 수신처면["御中", "様"], 발행원 블록이면["登録番号", "〒", "TEL"]같은 식이다. 사유는near_mismatch·near_ambiguous·near_conflict이고, 모델이 완벽하게 읽고도 다른 자리의 값을 골랐다는 클래스에 닿는다. 선택을 옳게 만드는 게 아니라 틀린 선택을 보이게 만든다.
이 선언들은 어느 것도 모델에게 전달되지 않는다. 선언했다고 추출이 정확해지는 게 아니라, 값은 선언하든 안 하든 같은 것이 돌아온다. 생기는 것은 검토 신호이고(label 의 경우에는 좌표 앵커), 프로그램이 다룰 수 있는 쪽은 그것이다.
비동기 작업 처리 구현하기
대량의 문서를 처리하려면 타임아웃과 리소스 고갈을 피할 비동기 경로가 필요하다. 문서 처리용 REST API를 쓰면 파일을 한꺼번에 제출하고 이미지마다 작업 ID를 돌려받을 수 있다(각 작업은 status "pending"으로 시작). 완료 여부를 확인하는 데 폴링을 쓸 수도 있지만, 프로덕션 구성이라면 웹훅을 써야 한다. 웹훅은 처리가 끝나는 순간 모든 바운딩 박스 데이터를 포함한 최종 JSON 페이로드를 여러분의 서버로 밀어 준다. 이 이벤트 기반 방식이 종량제 아키텍처에서 수천 장 규모로 확장할 수 있게 해 준다. 선약정 없이 이런 워크플로를 시험해 보고 싶다면, space-ocr은 최소 사용량 조건 없이 변동하는 작업량을 처리한다.
왜 검증 가능성이 문서 데이터의 새 기준인가
모델을 맹목적으로 믿는 건 컴플라이언스 문제다. 시스템이 출처 참조 없이 데이터를 받아들인다면 블랙박스 안에서 굴러가는 셈이다. 바운딩 박스가 붙은 OCR API는 모델을 맹목적 신뢰에서 증거 기반 추출로 옮겨 준다. 데이터 포인트가 정확히 어디에서 나왔는지 보여 주는 시각적 감사 기록을 제공하기 때문이다. 이건 한 글자만 잘못 읽어도 실질적 책임이 생길 수 있는 금액·법률 문서에서 특히 중요하다. "총 청구액"이 페이지 어딘가의 엉뚱한 날짜 문자열이 아니라 우하단 구석에서 나왔다는 것을 알 수 있어야 한다.
human-in-the-loop UI에서는 이 박스들을 문서 이미지 위에 그대로 겹쳐, 담당자가 모델의 작업을 빠르게 확인할 수 있게 한다. 수기 데이터 입력은 대체로 한 자릿수 초반대의 오류율을 동반하는데, 박스 단위 검증은 그런 실수를 잡는 데 걸리는 시간을 줄여 준다. 청구서 번호나 사업자번호를 찾으려고 페이지 전체를 훑는 대신, 담당자는 강조된 영역으로 바로 건너뛴다. 단지 돌아가기만 하는 게 아니라 감사 가능한 시스템을 세우는 것이다. 그 투명성이 규제 환경에서 자동화 워크플로를 실현 가능하게 만든다.
금융 컴플라이언스용 OCR
감사관에게는 증거가 필요하다. 추출한 필드와 함께 바운딩 박스 메타데이터를 "Spaces"에 저장하면, 디지털 기록과 원본 이미지 사이에 영구적인 연결 — 감사 때 검증 가능한 증거 — 이 생긴다. 파이프라인을 안전하게 하려면 HMAC 서명 웹훅(서명 헤더 X-Spaceocr-Signature, HMAC-SHA256)으로 데이터를 받아, API와 내부 DB 사이에서 페이로드가 변조되지 않았음을 확인할 수 있다. 금융 인프라에서 신뢰성은 있으면 좋은 게 아니라 기본 전제다.
손글씨 텍스트를 구조화 데이터로
손글씨는 전통 엔진에게 악명 높게 어렵다. 손글씨 텍스트를 구조화 데이터로 뽑아내는 일은 비표준 레이아웃과 제각각인 필체 때문에 복잡하다. 여기서 바운딩 박스가 힘을 발휘한다 — 지저분한 손글씨 메모나 팩스를 헤쳐 나가는 모델의 경로를 시각화할 수 있게 해 준다. 복잡한 양식에서 어떤 필드가 엉뚱한 자리에 앉으면, 좌표 데이터로 정렬을 프로그램적으로 바로잡을 수 있다. 추측하는 게 아니라, cells 에 판정과 근거를 달고 있는 기하 앵커를 근거로 오류를 고치고 최종 데이터셋을 정직하게 유지하는 것이다. 페이지 위 위치에 끝내 붙이지 못한 값도 조용히 사라지지 않고, 사유 nobox 로 검토 목록에 올라온다.
개발 워크플로에 바운딩 박스 통합하기
원시 JSON은 시작일 뿐이다. 바운딩 박스가 붙은 OCR API의 가치를 온전히 뽑아내려면 기존 개발 환경에 통합해야 한다. 워크플로는 수동 파일 업로드에서 CLI 기반 자동화로 옮겨 갔다. 터미널에서 OCR을 호출하면 브라우저 탭과 IDE를 오가는 마찰이 줄고, 필드의 공간 좌표를 이용해 특정 값을 즉석에서 필터링하거나 변환할 수 있다.
이미지에서 구조화된 시트로 넘어가는 과정을 자동화하는 것은 대량 처리 팀에서 흔한 사용 사례다. PDF에서 표 데이터 추출 API로 행 경계와 열 헤더를 식별해 CSV나 DB 스키마에 매핑할 수 있다. 이건 텍스트만의 문제가 아니라 구조적 기하의 문제다. 스크립트가 표 셀의 박스 좌표를 알면, 어떤 값이 특정 열에 속하는지 검증할 수 있다. 서버 쪽에서는 GET /view API가 저장된 시트를 where, sort, select 필터로 질의하며 — OCR 재실행도, 추가 과금도 없다 — 앱 안의 "Spaces"는 전역 키워드 검색과 키보드 그리드 내비게이션을 갖춘 검색·편집 가능한 시트다.
Claude Code 플러그인
Claude Code 플러그인은 두 줄로 설치된다 — /plugin marketplace add oisidonut/claude-space-ocr-skill, 그다음 /plugin install space-ocr@space-ocr — 그리고 의존성 없는 Python 클라이언트를 세션에 넣어 준다. 클라이언트 자체를 돌리는 데 pip 설치도, SDK 도, MCP 서버도 필요 없다 — 표준 라이브러리만 쓰는 스크립트 하나가 REST API 를 직접 부른다. (에이전트를 MCP 로 붙이고 싶다면 space-ocr 은 https://mcp.space-ocr.com/mcp 에 엔드포인트를 공개하고 있다. 플러그인은 그 길을 지나지 않을 뿐이다.) 터미널에서 문서 이미지(청구서, 영수증, 명함, 신분증, 양식)를 space-ocr REST API로 보내면 값마다 cells 의 box·quad 와 verified 판정이 붙은 구조화 필드를 돌려받고, 이미 스캔한 문서에 질의할 수도 있다. 환경을 떠나지 않고 API를 쓰고 싶은 개발자에게 실용적인 도구다.
웹훅과 자동화
확장에는 이벤트 기반 로직이 필요하다. 웹훅을 쓰면 문서 처리가 끝나는 순간 후속 동작을 트리거할 수 있다. 예를 들어 "ocr.completed" 이벤트를 수신해 영수증 데이터 추출 API의 출력을 회계 워크플로로 넘길 수 있다. Zapier든 Make든 직접 만든 Node.js 백엔드든, 페이로드는 검증 층까지 달고 도착한다. review.flagged 가 이미 다시 볼 만한 경로의 목록이라, 스크립트는 자체 점수를 만들지 않고도 깨끗한 문서는 그대로 넣고 나머지만 사람에게 보낼 수 있다. 오늘 바로 이런 파이프라인을 만들기 시작하려면 space-ocr로 시작해 검증 가능한 데이터를 스택으로 흘려보내면 된다.
space-ocr: 마찰 없는 종량제 구조화 데이터
경직된 정액 전용 구독의 시대는 끝났다. 문서 물량이 오르내린다면 안 쓰는 용량에 돈을 내는 건 불필요한 부담이다. space-ocr은 성공한 이미지당 100원을 청구하므로, 비용이 실제 사용량에 선형으로 맞춰진다 — 그리고 결과가 나온 추출에 대해서만 과금한다. 이 실용주의는 기능 구성에도 이어진다. 일부 제공사는 공간 메타데이터를 프리미엄 부가 기능으로 취급하지만, space-ocr은 바운딩 박스가 붙은 OCR을 표준 기능으로 돌려준다. 검증 가능성은 데이터 무결성을 위한 기본 요건이지 등급 업그레이드가 아니다.
구조화 필드 OCR API에 닿는 데 구매 승인 절차 같은 장벽이 있을 이유는 없다. 무료 티어 — 매월 100회 스캔, 신용카드 불필요 — 로 시작해 자신의 문서 유형으로 좌표 정밀도를 시험해 볼 수 있다. 가입에서 첫 성공 JSON 페이로드까지의 경로는 짧다. 청구서 수백 장을 처리하는 스타트업이든 그보다 훨씬 많은 물량을 다루는 팀이든, 가격은 예측 가능하게 유지되고 데이터는 검증 가능한 상태로 남는다.
Spaces에서 데이터 관리하기
앱 안에서 "Spaces"는 원시 API 출력과 팀의 일상 업무 사이를 잇는 다리다. 추출된 모든 필드가 원본 문서 위 자기 박스에 연결된 채로 남는, 검색·편집 가능한 시트다. 추출 결과를 검토하고 수동으로 수정할 수 있으며, 값은 자기가 나온 박스에 연결된 채로 남는다. 전역 키워드 검색은 시트 전체에서 어떤 값이든 찾아내고, 키보드 그리드 내비게이션으로 빠르게 이동할 수 있다. 프로그램적 필터링이 필요할 때는 GET /view API가 저장된 시트를 서버 쪽에서 where, sort, select로 질의한다 — 예를 들어 total>=40000이나 vendor~ABC — 매칭되는 행만 돌려주며, OCR 재실행도 과금도 없다.
몇 분 만에 시작하기
통합은 바로 쓸 수 있게 만들어져 있다. API 키를 발급받고 몇 분 안에 첫 이미지를 처리할 수 있다. CLI 기반 추출이라면 Claude Code 플러그인으로 터미널에서 로컬 파일을 보내고 환경을 떠나지 않은 채 구조화 데이터를 받을 수 있다. 원시 이미지에서 검증된 데이터 객체까지의 경로는 짧다. 수기 입력을 줄이고 무결성 높은 파이프라인을 세울 준비가 됐다면, space-ocr에서 검증 가능한 바운딩 박스로 문서 처리를 무료로 시작하면 된다.
검증 가능한 문서 워크플로 확장하기
원시 텍스트 추출에서 무결성 높은 데이터 객체로 옮겨 가는 것은 프로덕션 수준 자동화에서 더는 선택이 아니다. 공간 좌표가 감사 기록으로 작동해 "블랙박스" 추출을 검증 가능한 기록으로 바꾸는 과정을 살펴봤다. 바운딩 박스가 붙은 OCR API를 구현하면, 빠른 human-in-the-loop 검증과 정밀한 필드 매핑에 필요한 기하 앵커를 팀에 쥐여 주게 된다. 이 전환은 비정형 데이터의 모호함을 걷어내고 수기 입력을 감사 가능한 파이프라인으로 대체한다.
신뢰성이 꼭 제약적인 정액 가격표와 함께 와야 하는 건 아니다. 성공한 이미지당 100원과 기본 제공되는 Claude Code 플러그인 지원으로, 이 기능들을 CLI나 백엔드 서비스에서 마찰 없이 호출할 수 있다. 검증 가능한 바운딩 박스는 현대 데이터 무결성의 표준 요건이므로 기본으로 포함되며, 모든 값은 페이지 대비 확인 가능한 상태로 남는다. 불투명한 인터페이스 뒤에 숨는 대신 검증을 초대하는 시스템을 세울 때다. space-ocr을 무료로 시작해 오늘부터 고정밀 추출을 배포해 보자.
자주 묻는 질문
OCR에서 바운딩 박스와 바운딩 리전의 차이는 무엇인가요?
바운딩 박스는 축에 정렬된 사각형입니다. space-ocr은 이를 0–1000 정규화 그리드 위의 네 정수 — xmin, ymin, xmax, ymax — 로 돌려주며, 효율적이고 깔끔한 디지털 원본 문서에서 잘 작동합니다. 기울거나 회전하거나 휘어진 스캔에 대해서는 문서의 기울기를 따라가는 4점 방향성 사각형(quad, 좌상·우상·우하·좌하 순서)도 함께 돌려줘, 물리적으로 왜곡된 페이지에서 단순 박스로는 낼 수 없는 정밀도를 제공합니다.
바운딩 박스 좌표로 Python에서 이미지 위에 그리려면 어떻게 하나요?
space-ocr은 좌표를 0–1000 그리드로 돌려주므로, 이미지 크기로 스케일해 픽셀로 바꾸면 됩니다. 폭 1000픽셀 이미지에서 xmin 500은 픽셀 500에 대응하고(pixel_x = xmin / 1000 * image_width), 폭 2000픽셀 이미지에서는 같은 xmin 500이 픽셀 1000에 대응합니다. 크기는 업로드한 파일이 아니라 data.image 에서 가져오세요 — EXIF 회전과 서버 축소가 반영된, 실제로 판독된 페이지의 크기입니다. xmin, ymin, xmax, ymax를 픽셀로 계산한 다음 Pillow나 OpenCV의 draw.rectangle을 호출해 시각 검증용 오버레이를 렌더링하면 됩니다.
바운딩 박스가 붙은 OCR API가 손글씨 텍스트도 인식하나요?
네. 손글씨 메모와 팩스도 인쇄 문서와 같은 구조화 필드 경로를 지나고, 필드마다 cells 에 좌표가 붙어 돌아오므로 지저분한 필체를 특정 키에 매핑할 수 있습니다. 손글씨는 앵커가 가장 어려운 영역인데, 응답은 그것을 감추지 않고 말합니다. 페이지 위 위치에 붙이지 못한 값은 사유 nobox 로 review.flagged 에 실리고, 글자가 인쇄물과 어긋나면 text_mismatch 가 붙습니다. 이 기하학적 맥락과, 확인되지 않은 것들의 명시적인 목록이 있어서 비표준 손기입 양식에서 흔한 정렬 어긋남을 잡아내고 바로잡을 수 있습니다.
space-ocr은 멀티페이지 PDF 문서를 지원하나요?
space-ocr 웹앱은 멀티페이지 PDF를 지원합니다. 각 페이지를 PNG로 렌더링한 뒤 그 페이지 이미지들에 OCR을 돌리므로, 각 페이지가 자기 자신의 래스터 이미지로 처리됩니다. OCR 엔진과 REST API는 PDF 바이트가 아니라 이미지 위에서 동작하므로, API를 직접 쓸 때는 PDF 페이지를 먼저 이미지로 변환해 요청당 하나씩 보냅니다. 좌표는 항상 자기가 나온 페이지 이미지를 기준으로 하므로, 페이지 인덱스 중첩을 맞춰 볼 일이 없습니다.
space-ocr API를 바운딩 박스와 함께 쓰면 비용이 얼마인가요?
space-ocr은 종량제입니다. 성공한 이미지당 100원이며, 결과가 나온 추출에 대해서만 과금됩니다 — 실패는 청구되지 않습니다. 모든 계정에 매월 무료 스캔 100회도 제공됩니다. 페이지당·필드당 가격이 없어, 비용이 고정 월 최소액이 아니라 실제 물량을 따라갑니다.
space-ocr용 Claude Code 플러그인이 있나요?
네. 두 줄로 설치됩니다 — /plugin marketplace add oisidonut/claude-space-ocr-skill, 그다음 /plugin install space-ocr@space-ocr — 그리고 space-ocr REST API 를 직접 호출하는 의존성 없는 Python 클라이언트를 추가합니다. 이 클라이언트를 돌리는 데 pip 설치도, SDK 도, MCP 서버도 필요 없습니다. (에이전트를 MCP 로 붙이고 싶다면 space-ocr 이 https://mcp.space-ocr.com/mcp 에 엔드포인트를 공개하고 있습니다. 플러그인은 다른 경로일 뿐입니다.) 터미널에서 문서 이미지를 구조화 필드로 바꾸거나 이미 스캔한 문서에 질의할 수 있으며, 브라우저로 전환할 필요가 없습니다.
제공되는 바운딩 박스의 정확도 수준은 어느 정도인가요?
값마다 맨 점수가 아니라 판정이 붙습니다. cells[path].verified 는 돌아간 검사가 모두 일치하면 true, 무언가가 서면 false, 대조할 상대가 없으면 null 이고, 같은 필드가 사유와 함께 review.flagged 에도 나옵니다. evidence 안의 match_ratio 는 그 값의 문자 중 OCR 패스가 페이지에서 검출한 심볼 사이에서 space-ocr 이 다시 찾아낸 비율(0.0~1.0)이며, 페이지 대비 커버리지이지 모델 자체의 확신도 점수가 아닙니다. 0.85 이상이면 확신 있는, 심볼 매칭에 앵커된 것으로 취급합니다. review 가 null 인 값은 자동으로 받아들이고, 검토에 올라온 것들을 검토 UI 로 보내시면 됩니다.
바운딩 박스가 붙은 데이터를 CSV나 JSON 파일로 내보내려면 어떻게 하나요?
API는 기본적으로 구조화 JSON을 돌려주므로 어떤 형식으로든 파싱할 수 있습니다. 노코드 경로라면 Spaces 웹앱이 문서를 검색 가능한 시트로 보여 주고 UTF-8 BOM이 붙은 CSV로 내보내므로, CJK 텍스트와 통화 문자가 Excel에서 제대로 열립니다. 배열(라인 아이템) 행은 하위 행으로 펼쳐집니다. CSV는 스프레드시트나 DB에 불러올 수 있는 범용 포맷이라 독점 종속이 없습니다.