確認できるデータに変える、日本語OCR
space-ocrで日本語の領収書・請求書・納品書を読み取ります。混在スクリプト、全角・縦書き、文字化けしないCSV書き出しに対応し、値は data.values、位置は data.cells、確認すべき項目は data.review.flagged で返ります。
日本語は、ふつうのOCRが静かに崩れる場所です。1枚の領収書に漢字・かな・半角カナ・全角数字、そしてときどき英語までが混ざり、合計は右端の縦書き列に並んでいたりします。多くのツールは先に言語を選ばせるか、レイアウトを失った平らなテキストの塊を返すかのどちらかです。本当に役立つ日本語OCRは、それを一度に読み、各数字がどこから来たのかを教えてくれる必要があります。
space-ocrは両方をこなします。JP書類を読んで構造化フィールドを data.values に返し、すべての値を、ページ上のどこから読み取ったかという正確な位置とともに返します——data.cells[path] にボックス・四頂点・判定・根拠が入ります。照合が通らなかったものは data.review.flagged に作業リストとして並ぶので、ページを読み直すのではなく短い待ち行列だけを見れば済みます。設定する言語はありません。日本語・韓国語・中国語・英語をひとつのエンジンがまとめて扱います。
その場で確認できる、実際の日本語抽出
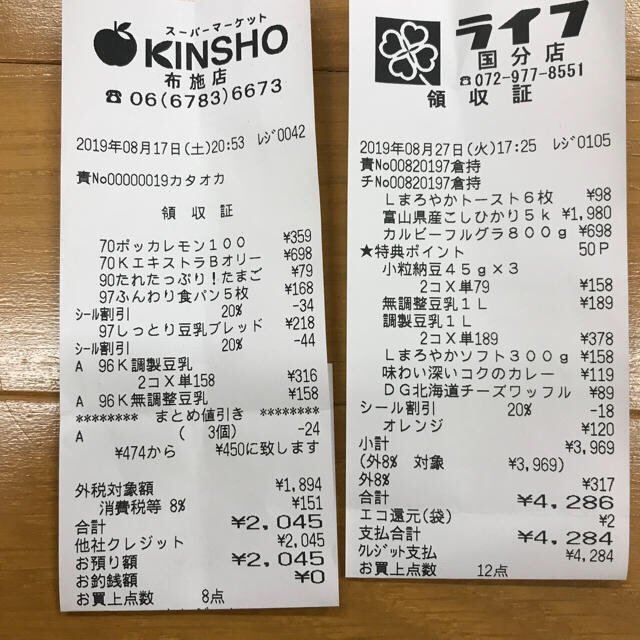
下のフィールドにマウスを合わせてみてください。ここで読んでいる2枚の領収書は本物です——合計2,045のKINSHO 布施店と、合計4,286のライフ 国分店、どちらも2019年8月の日付です。値とボックスはすべて実際の解析結果から読み込んだもので、モックアップではありません。ボックスは漢字・かな・数字が混ざった各行に沿います。行の横に出る文字一致の数値は補助的な根拠であって、合格ラインではありません。
Each value with a box carries a verified on-page location — in data.cells[path], that is box + 4-point quad + evidence.match_ratio — on a 0–1000 normalized grid (0,0 top-left → 1000,1000 bottom-right), the same shape the live API returns. Hover a field to trace it back to the pixels it came from.
space-ocrでの日本語OCRの仕組み
モデルは座標を作りません。書類を読んで値を返し、そのあと文字マッチャーが、その文字をOCRがページで実際に検出したシンボルと突き合わせます。この突き合わせがボックス・quad・各セルの根拠を生みます。verified は review の鏡になる判定です——理由がひとつでも付けば false、照合が走って何も立たなければ true、照合できるものが無ければ null。文字照合そのものは evidence.text_match にあり、evidence.match_ratio は文字の被覆率を示す補助的な根拠で、合格ラインではありません。2つのエンジンが同じ誤読で一致してしまうこともあるので、この待ち行列は「まず見るべき場所」であって保証ではありません。
アプリにPDFをドロップすると、各ページがまず画像にレンダリングされてから読まれます——複数ページの請求書や納品書に便利です。APIを直接呼ぶ場合はラスターのページ画像をURLまたはbase64で送れば、返ってくる構造化結果は同じです。必要な fields を宣言するか、autoFields: true を送って提案させてください。明細行は children を持つ array フィールドで表し、items[0].amount のように指せます。
宣言は抽出のあとに検査され、モデルには渡りません。つまり読み取りではなく確認の信号を変えます。type: "date" は決定的な data.normalized の層を足し、令和8年8月16日 は 2026-08-16 になりますが data.values は印字どおりのままです。type: "number" は ¥13,220 を 13220 にします。pattern は全角を畳んだ値に対して照合するので、全角で印字された登録番号にも ^T[0-9]{13}$ が効きます。日本の帳票で起きやすい当事者の取り違えには、宛先に 御中 や 様 を near として、登録番号 / TEL / 〒 を not_near として宣言してください。取り違えは黙って通らず near_mismatch や near_conflict として見えるようになります。数量欄の 一式、支払期限の 翌月末払い のように値でない表記が正規に印字される項目は string のままにしてください——型を宣言すると、書類として正しいのに毎回確認リストに載ります。
curl -s https://api.space-ocr.com/ocr/fields \
  -H "Authorization: Bearer $SPACE_OCR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image": "https://example.com/invoice-jp.jpg",
    "imageType": "url",
    "fields": [
      { "name": "issuer", "type": "string", "required": true,
        "near": ["登録番号", "TEL", "〒"] },
      { "name": "bill_to", "type": "string",
        "near": { "terms": ["御中", "様"], "match": "suffix" },
        "not_near": ["登録番号", "TEL"] },
      { "name": "registration_no", "type": "string", "pattern": "^T[0-9]{13}$" },
      { "name": "issue_date", "type": "date", "required": true },
      { "name": "total", "type": "number", "required": true, "min": 0 },
      { "name": "items", "type": "array", "children": [
        { "name": "name", "type": "string" },
        { "name": "qty", "type": "string" },
        { "name": "amount", "type": "number" }
      ] }
    ]
  }'
日本語の書類をOCRする手順
- 書類を追加アプリに領収書・請求書・PDFをドロップすると、各ページが画像にレンダリングされOCR待ち行列に入ります。APIではラスターのページ画像(urlまたはbase64)を /ocr/fields に送ります。言語設定はありません。
- フィールドを宣言する必要な fields を並べるか、autoFields: true を送ってスキーマを提案させます。明細行テーブルには children を持つ array フィールドを使い、書類が支えられる範囲で type・pattern・near・not_near を足します。
- 構造化された結果を読む業務データは data.values にあります。data.cells[path] には box・quad・verified・review・evidence が入り、その座標の基準面が data.image、宣言したスカラー型の解釈値が data.normalized です。
- 確認の待ち行列を処理するdata.review.flagged を回します。各項目は path と、ランク順で先頭が代表になる reasons 配列を持ち、flagged.length が確認すべき件数です。対応するセルを開けば、その値を読み取った領域がハイライトされます。
- エクスポートまたはクエリCSV(UTF-8 BOMで日本語がきれいに開く、明細行は展開済み)をダウンロードするか、保存済みシートを GET /view で where・sort・select を使って読みます——保存済みの行を読むのにOCRは走らず、GET /view は課金されません。
シンプルで予測できる料金
1クレジット=1ページで ¥10(税込)、毎月100クレジットの無料枠付き、クレジットカードは不要です。失敗時は課金されません。定額プランは月間クレジット・シート数・ストレージを追加します。