同じ書類、同じスキーマ、違う答え: space-ocr vs Mistral
8ケース・書類7枚・463フィールド、エンジンごと3回の統制ベンチマーク。読取率、実行間の安定性、そしてスコア表に見えない座標の差。
space-ocr は私たちが作った書類読み取り API だ。写真と、そこから取り出したい値のリストを送ると、その値がデータとして返ってくる。値ごとに、ページのどこから読んだのかという位置が付いてくる。この記事は、その space-ocr を Mistral Document AI と並べて、実際に難しい書類で走らせた記録である。
OCR ベンダーのデモはどこも、きれいに印刷された請求書を完璧に読む。うちも同じで、それは導入判断には何の情報にもならない。判断に効く問いは三つだ。厄介な書類ではどうなるのか。同じページを二度走らせたら答えが変わるのか。間違った値を、全件を手で見直さずにどう見つけるのか。三つとも測った。以下に全部書いてある。こちらに不利な数字もそのまま置いた。
何を走らせたか
採点ケース 8 件、値 463 個、写真は 7 枚。日本語の納品書 3 枚、商品名が 1 行、数量と単価がその下の行に印字されるスーパーのレシート、チャットで届いた 24 行の注文、報酬明細書、そしてモニター画面を撮影した 22 行の卸売相場表。すべて自社の回帰テストに入っている写真、つまり自分たちが何かを壊したときに引っかかるように置いてあるセットだ。
写真が 7 枚でケースが 8 件なのは、二つのケースが同じチャット注文の写真・同じ正解データだからだ。内部の経路を分けて確かめるためにテスト上は別管理にしている組で、エンジンから見れば同じ画像を二度受け取っただけになる。この写真 1 枚が 463 個のうち 144 個を占めることは、頭に入れて読んでほしい。
アームは三つ。すべて同じ画像、同じフィールド一覧(名前も説明も同一)、「印字どおりに写せ」という同じ指示を受けている。
| アーム | 何を呼んだか | フィールドの渡し方 |
|---|---|---|
| space-ocr | 本番の POST /ocr/fields | 名前と説明の付いたフィールド一覧 |
| Mistral OCR | mistral-ocr-latest、/v1/ocr + document_annotation | 同じ一覧を strict な JSON スキーマで |
| Mistral ビジョン LLM | mistral-medium-latest、チャットに画像添付 | 同じ一覧を response_format: json_schema、temperature 0 |
書類ごとにアーム 3 回、合計 72 回、生の応答はすべて保存した。採点は三アーム共通のスクリプト 1 本。空白を落として手書きの正解と完全一致なら正解、そうでなければ不正解。2026 年 8 月。
結果と、一緒に見るべき但し書き
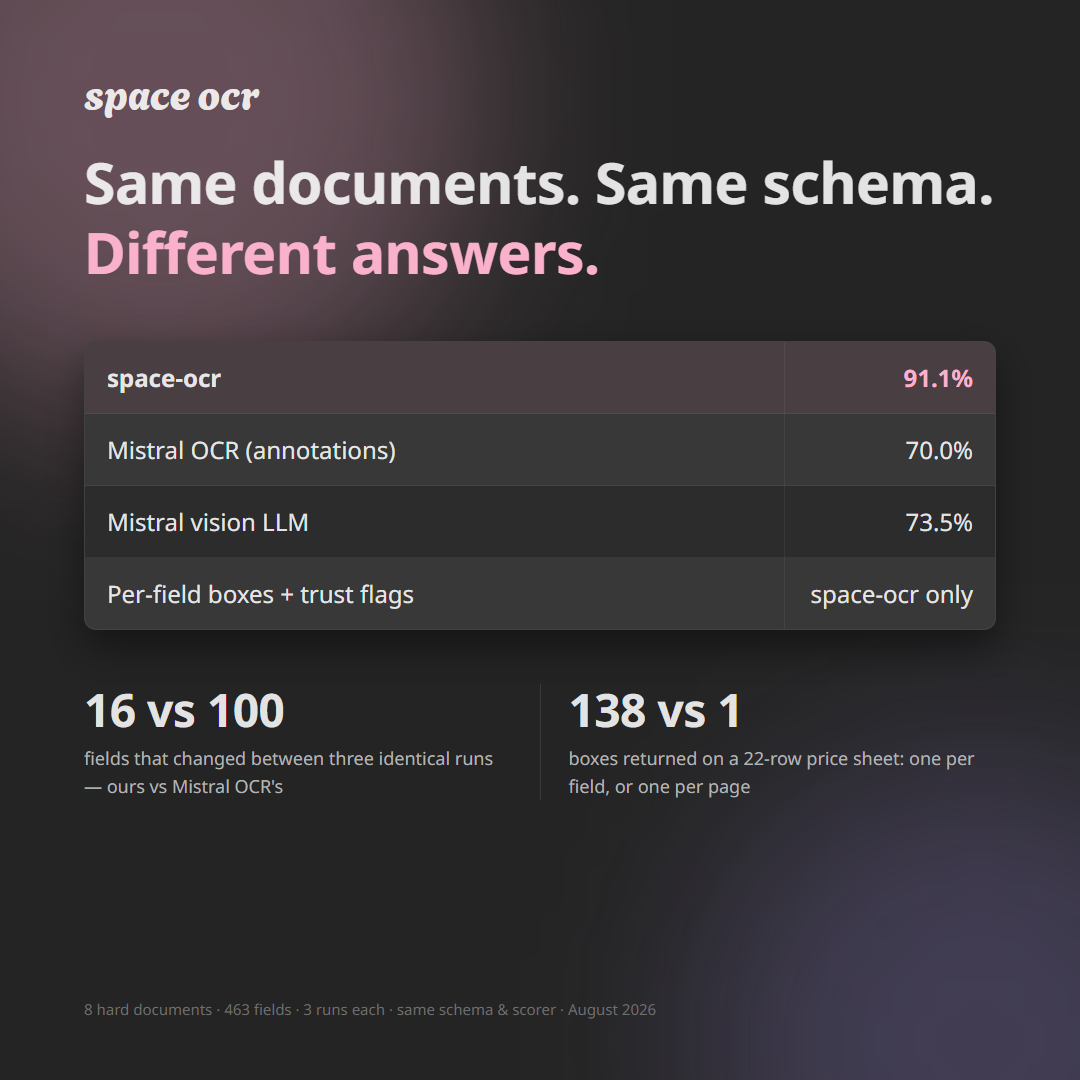
space-ocr は 463 個の値の 91.1% を完全一致で読んだ(3 回平均)。Mistral の OCR 注釈は 70.0%、ビジョン LLM は 73.5% だった。
どのエンジンでも、外れの一部は書式の問題だ。通貨記号を残した、数字に単位を付けた、その類である。そこで区切りや空白だけが違う不一致を全部取り除き、内容の誤りだけを数え直した。1 回あたり space-ocr 約 23 件に対し、Mistral OCR 119 件、ビジョン LLM 93 件。差は残る。
数字を見る前にもう一つ。正解データは、値の境目をどこで切るかというこちらのパイプラインの流儀で書き起こしてある。だから当社を含むすべてのエンジンが境界解釈の違いで点を落とす。読むべきはアーム間の差で、絶対値は成績ではなく下限だ。
全 8 ケース、点数のすべて
3 回平均で、正解した値の数 / 全体。
| 書類 | 値 | space-ocr | Mistral OCR | Mistral VLM |
|---|---|---|---|---|
| 相場表 22 行、モニター撮影 | 141 | 139.0 (98.6%) | 139.0 (98.6%) | 133.7 (94.8%) |
| 報酬明細書 | 44 | 42.7 (97.0%) | 39.0 (88.6%) | 34.7 (78.8%) |
| 納品書 C | 53 | 50.3 (95.0%) | 43.7 (82.4%) | 47.3 (89.3%) |
| 納品書 B | 37 | 34.3 (92.8%) | 18.0 (48.6%) | 24.3 (65.8%) |
| 2 行に分かれるレシート | 13 | 12.0 (92.3%) | 2.3 (17.9%) | 1.3 (10.3%) |
| チャット注文 24 行 (2 件中 2) | 72 | 61.0 (84.7%) | 21.3 (29.6%) | 41.7 (57.9%) |
| チャット注文 24 行 (2 件中 1) | 72 | 58.0 (80.6%) | 39.7 (55.1%) | 42.3 (58.8%) |
| 納品書 A | 31 | 24.7 (79.6%) | 21.0 (67.7%) | 15.0 (48.4%) |
| 全体 | 463 | 422.0 (91.1%) | 324.0 (70.0%) | 340.3 (73.5%) |
最初に見るべきは一番上の行だ。このセットで最もきれいな書類、値が 141 個詰まった密な印刷表で、Mistral OCR はこちらと同点を出した。文字を読む力はこれらのエンジンが分かれる場所ではないし、それを隠す比較は何かを売りつけようとしている比較である。
分かれるのは表の下の方で、方向は一貫している。レイアウトが厄介になるほど差が開く。チャット注文の 2 行も見てほしい。同じ写真、同じ正解、同じスキーマを二度送っただけで、こちらは 2 回の差が 3 個、Mistral OCR は 18 個だった。
同じページを 3 回走らせる
463 点満点、実行ごとの合計。
| アーム | 1 回目 | 2 回目 | 3 回目 | 振れ幅 |
|---|---|---|---|---|
| space-ocr | 430 | 414 | 422 | 16 |
| Mistral OCR | 322 | 275 | 375 | 100 |
| Mistral ビジョン LLM | 360 | 329 | 332 | 31 |
100 個の振れ幅は平均まわりのノイズではなく、事実上別の製品だ。ある Mistral OCR の実行は、1 時間前に 72 個中 58 個を当てた書類で 72 個中 3 個を返した。注釈層が 43 行の表の列割り当てを丸ごと入れ替えたからだが、応答を見てもその回と良い回の区別はつかない。
外すとき、実際にどう外れるのか
差が最も大きかった 2 行レシート、1 回目。このレシートは商品名を 1 行に、数量と単価を次の行に印字し、合計ブロックが同じ列の真下に続く。
| 値 | ページの印字 | space-ocr | Mistral OCR |
|---|---|---|---|
| 1 番目の商品名 | ポッカサッポロ果実の | 正解 | 006142 ポッカサッポロ 果実の |
| 1 番目の数量 | 12 | 正解 | 12コ |
| 1 番目の単価 | 98 | 正解 | 単98 ¥1,176 |
| 2 番目の商品名 | 塩パン | 正解 | 011102 塩パン |
| 日付 | 2017年07月30日(日) | 正解 | 2017年07月30日(日) No.2805 |
| 合計 | 1,451 | ¥1,451 | ¥1,451 |
最後の行から見てほしい。合計では両エンジンが同じ答えを返し、どちらも不正解になっている。正解データに通貨記号がないからだ。この種の外れが、当社を含むすべてのエンジンの誤り数を膨らませる。上の「内容の誤りだけ」の数字が生の数字より役に立つ理由がこれである。
残りの行は性質が違う。あそこで Mistral は文字を読み違えていない。棚コードを商品名にくっつけ、価格を数量の行にくっつけている。印字された 2 行が 1 レコードだと、最後まで捉えられなかったということだ。
24 行のチャット注文の失敗は、全体を見る価値がある。下流で最も高くつく失敗の型だからだ。
| 行 | 印字 | Mistral OCR の返答 |
|---|---|---|
| 1 行目 備考 | ヒチョウ | (空) |
| 2 行目 品目 | クエ | ヒチョウ |
| 2 行目 備考 | 頭落とし | 背 |
| 3 行目 品目 | ブリ | クエ |
| 3 行目 備考 | サクラブリ | (空) |
すべての行が 1 つ上にずれている。値の一つひとつはページに実在する文字列で、綴りも合っている。しかし表として見れば 2 行目から先が全部間違いで、応答の見た目に不審な点はない。
同じページでこちらも外している。規模が小さかっただけだ。ヒチョウ を ヒチョウ背、冷凍 を 冷凍 2L と読んだ。表をずらしたのではなく、隣のセルをくっつけて読んだ形だ。納品書 B では単価 1510 を 510 と読み、隣の列から寄ってきた 1 桁を落とした。
点数表に映らないもの
相場表で両エンジンに同じ 141 個の値を求めると、返ってくる二つの答えは同じくらい使えそうに見える。それぞれの値がどこから来たのかを尋ねるまでは。
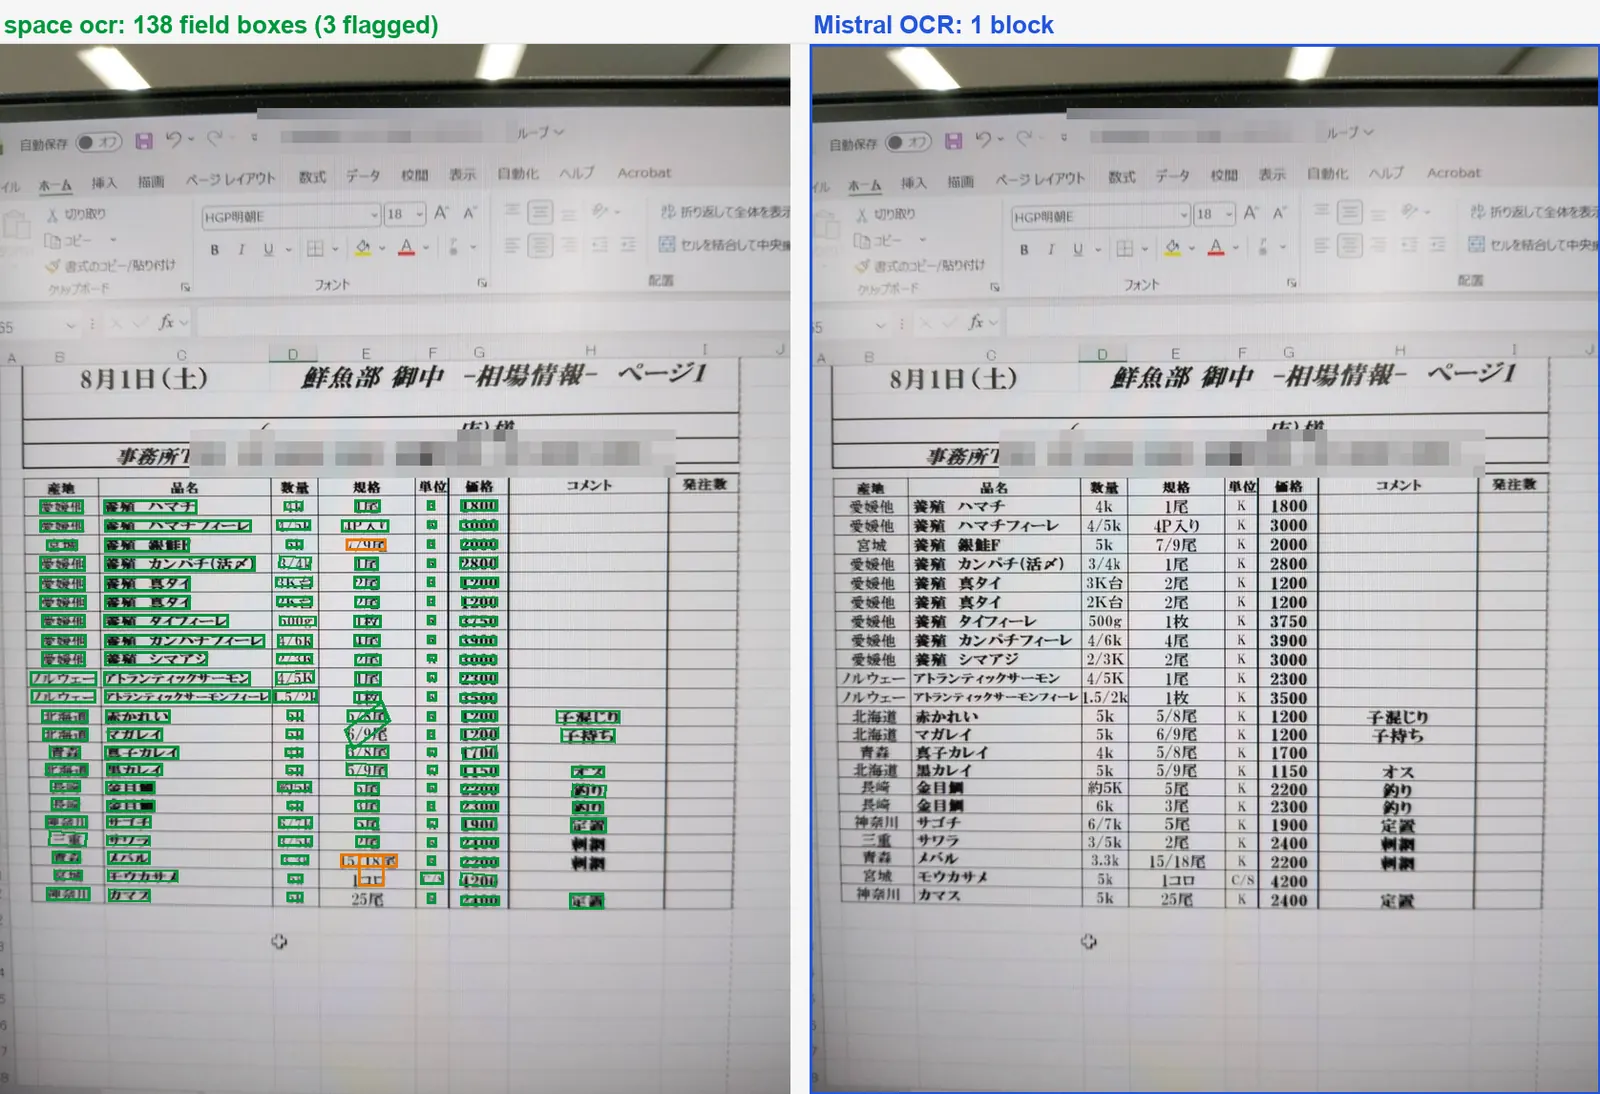
space-ocr は値ごとにボックスを返し、そのボックスは値を読んだ実際のピクセルに張り付いている。今回のベンチマークで保存した Mistral の応答(mistral-ocr-latest、2026 年 8 月)では、同じ相場表が表全体を覆う長方形 1 個で返ってきた。あの応答には値単位の座標が無く、こちらが見た最小の単位は段落ブロックだった。現在の API が何を返すかは、Mistral の最新ドキュメントで確かめてから設計に入ってほしい。
検証シグナルも、あの応答には無かった。space-ocr の値は data.cells[path] に入って返る。0〜1000 グリッドの box と quad、判定である verified、何が通らなかったかを機械可読なコードで並べる review.reasons、そして文字照合そのもの(text_match)とその裏付けの match_ratio、認識側が出せるときの ocr_confidence を持つ evidence だ。人の目が要る値は data.review.flagged の一箇所にまとまる。同じ値がページ内で繰り返されるときは、フィールド宣言の label がどの出現を取るかを固定する。verified: true は文字どおりに読んでほしい。走った検査が何も見つけなかったという判定であって、その値が求めていた値だという保証ではない。
これが仕事の中身を変える。ボックスと検討リストがあれば、静かに間違っている値の方が表に出てきて、人は 141 個を読み直す代わりにフラグの立った数件から始められる。すべてを掬う網ではない。二つの読みが同じ答えで一致した値には照合が立てるものが無く、上の合計行がまさにその形だ。それでも、フラグの付いた誤りは一瞥で済み、フラグの無い誤りはその上に積み上げたもの全部の値段になる。
セット全部、両エンジン
写真 7 枚すべて。左右は同じ画像で、ボックスはベンチマーク 1 回目の保存済み応答からそのまま描いた。緑が space-ocr の値 1 個、橙がその実行でエンジンが要確認に回した値、青が Mistral OCR のブロック 1 個。第三者の商号・住所・電話番号・口座番号・担当者名は公開前にモザイク処理してあり、そのためボックスが灰色の長方形の上に乗っている箇所がある。
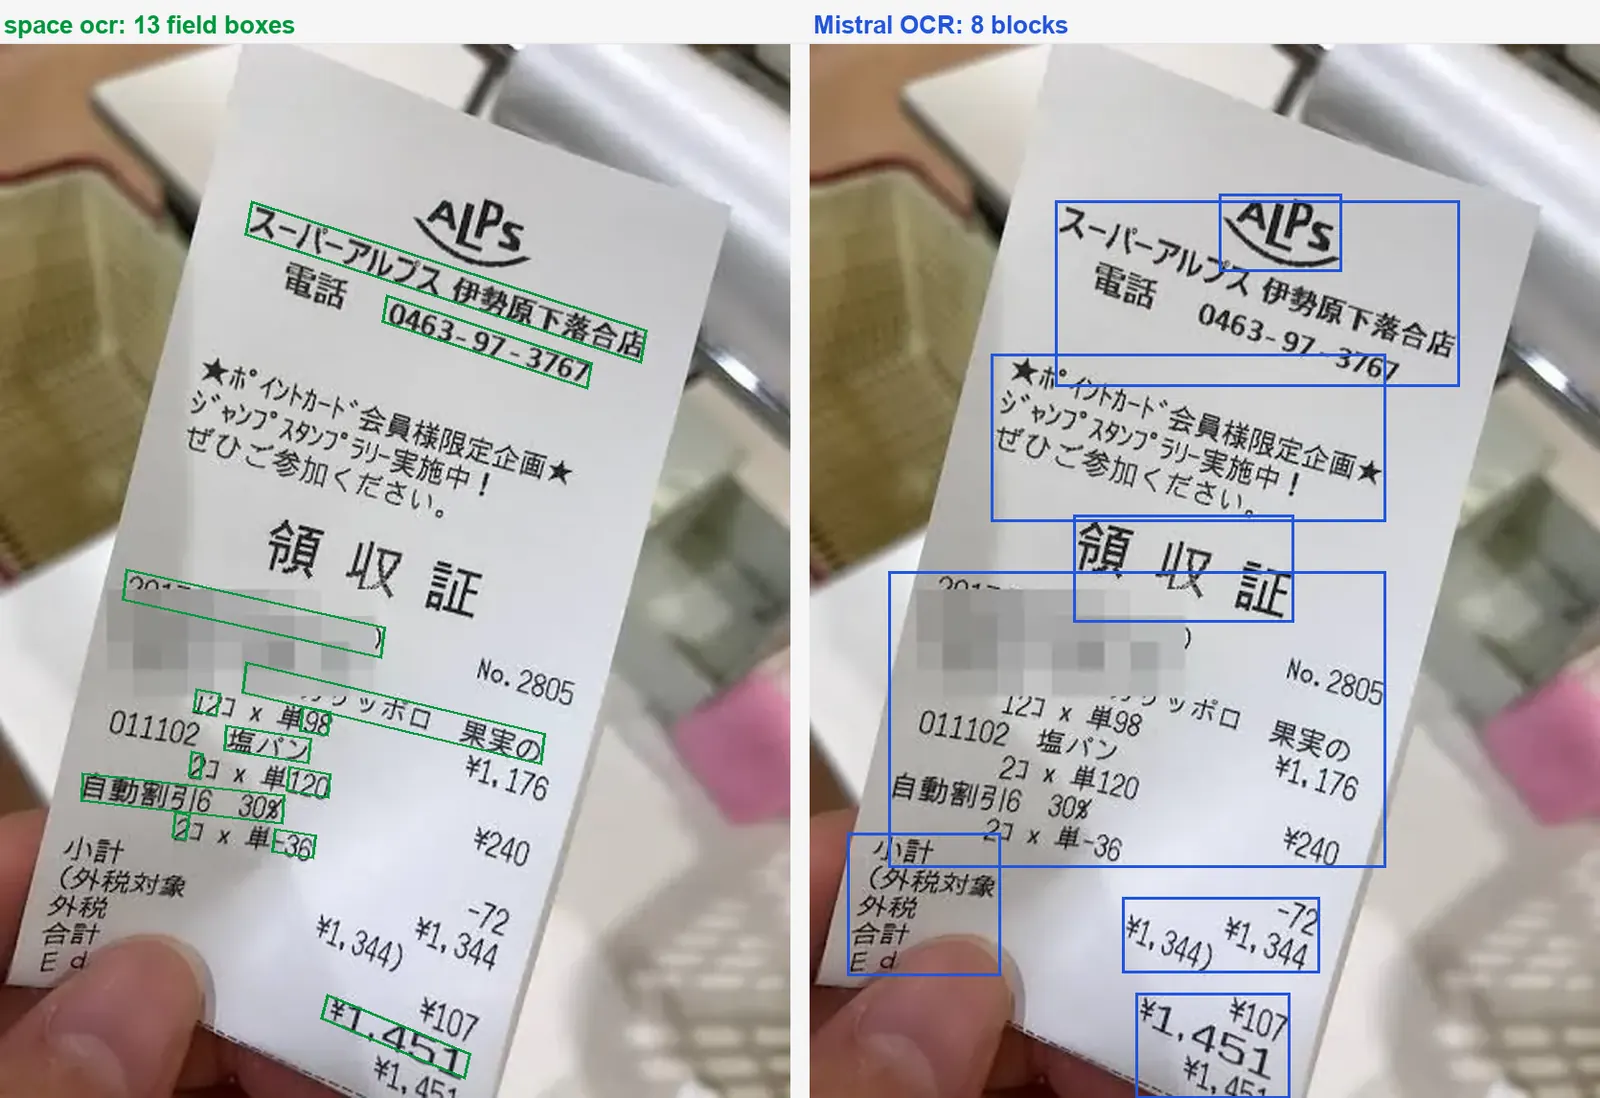
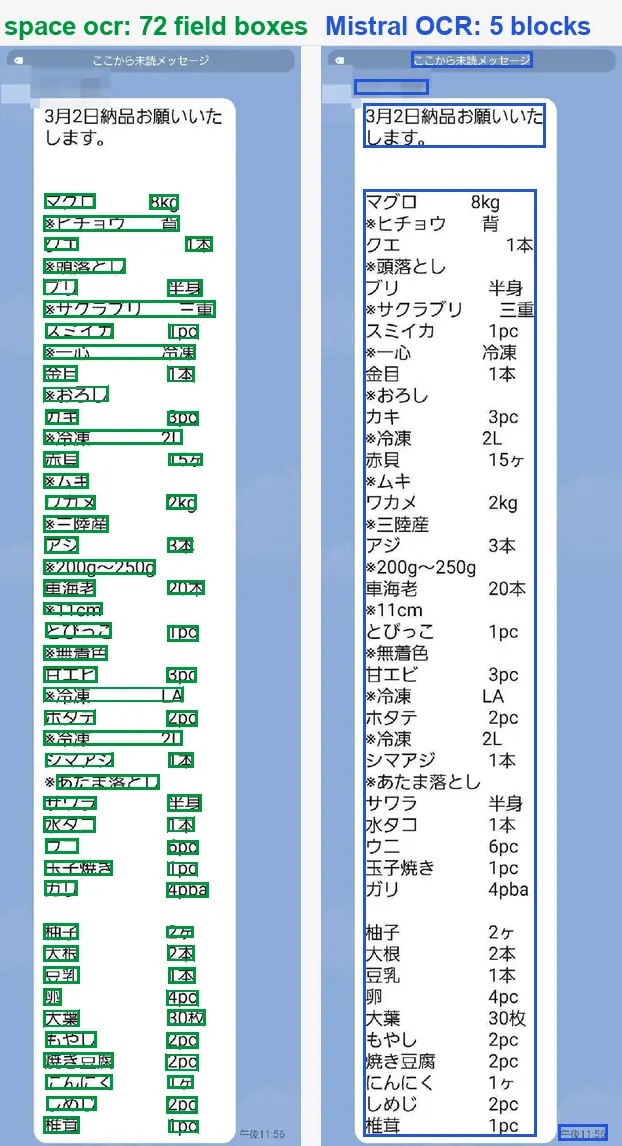
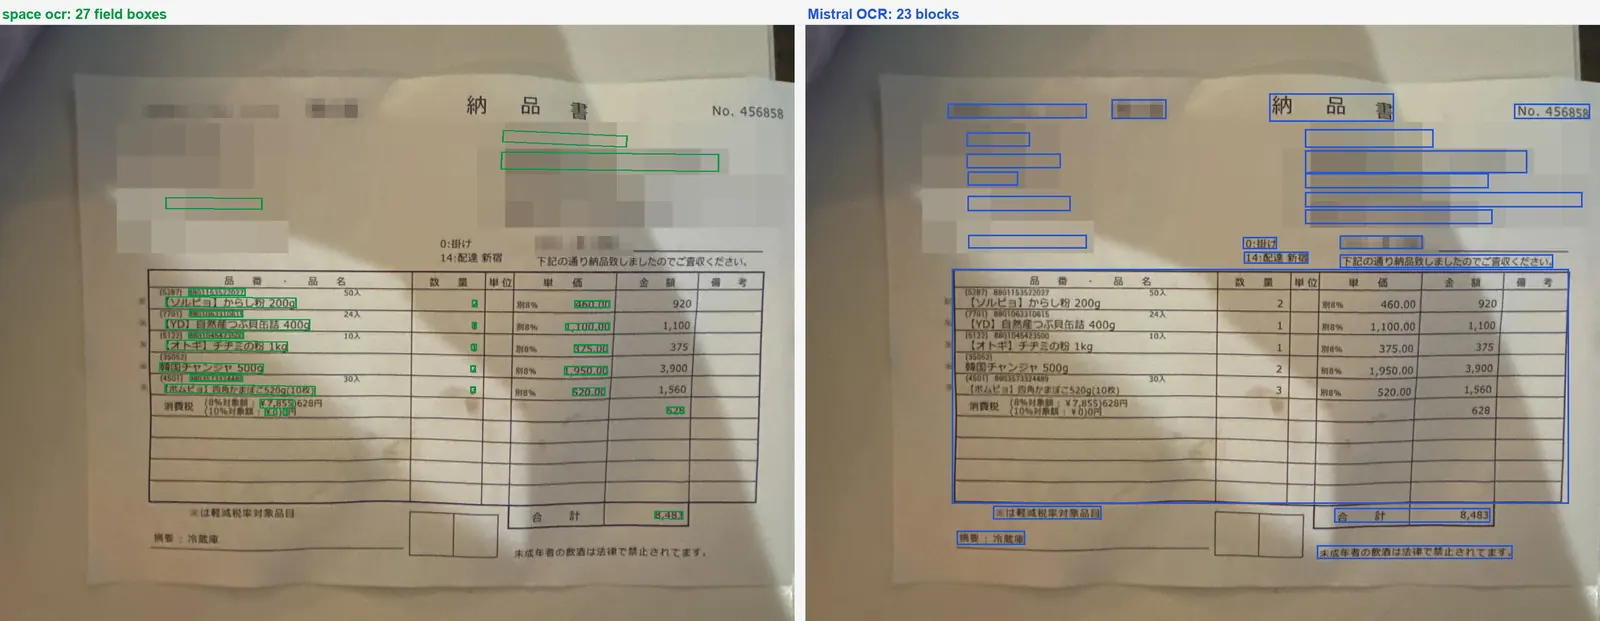
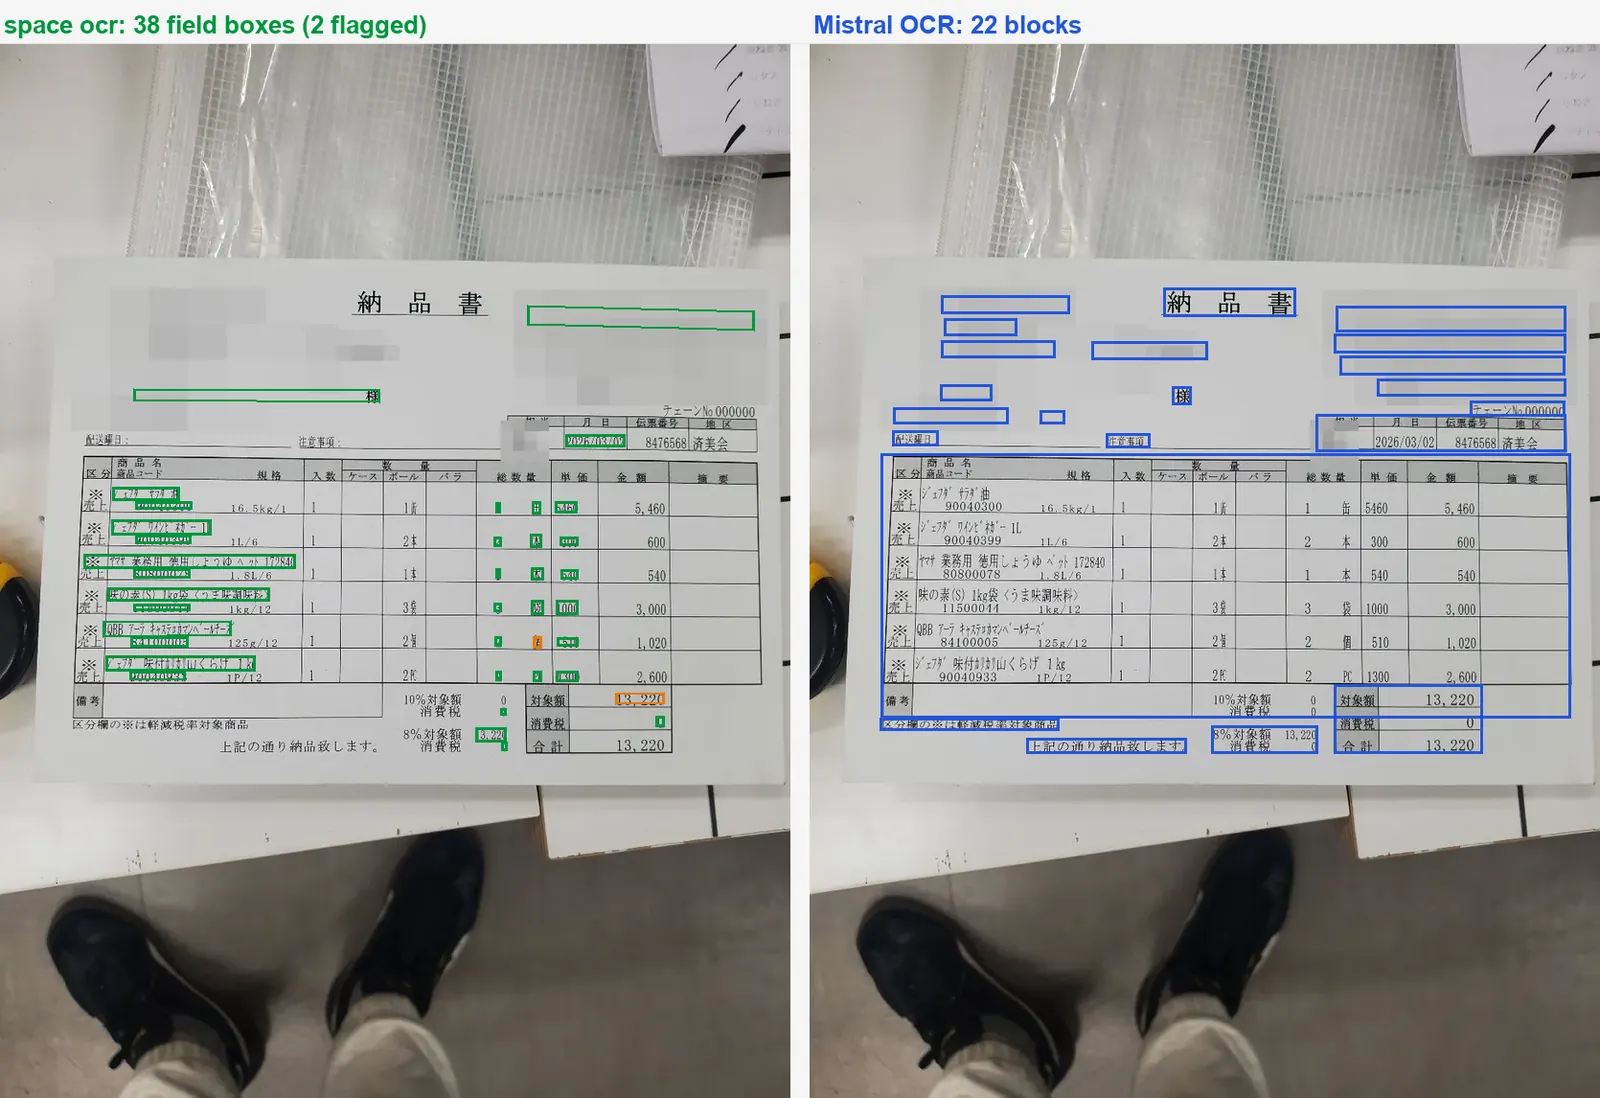
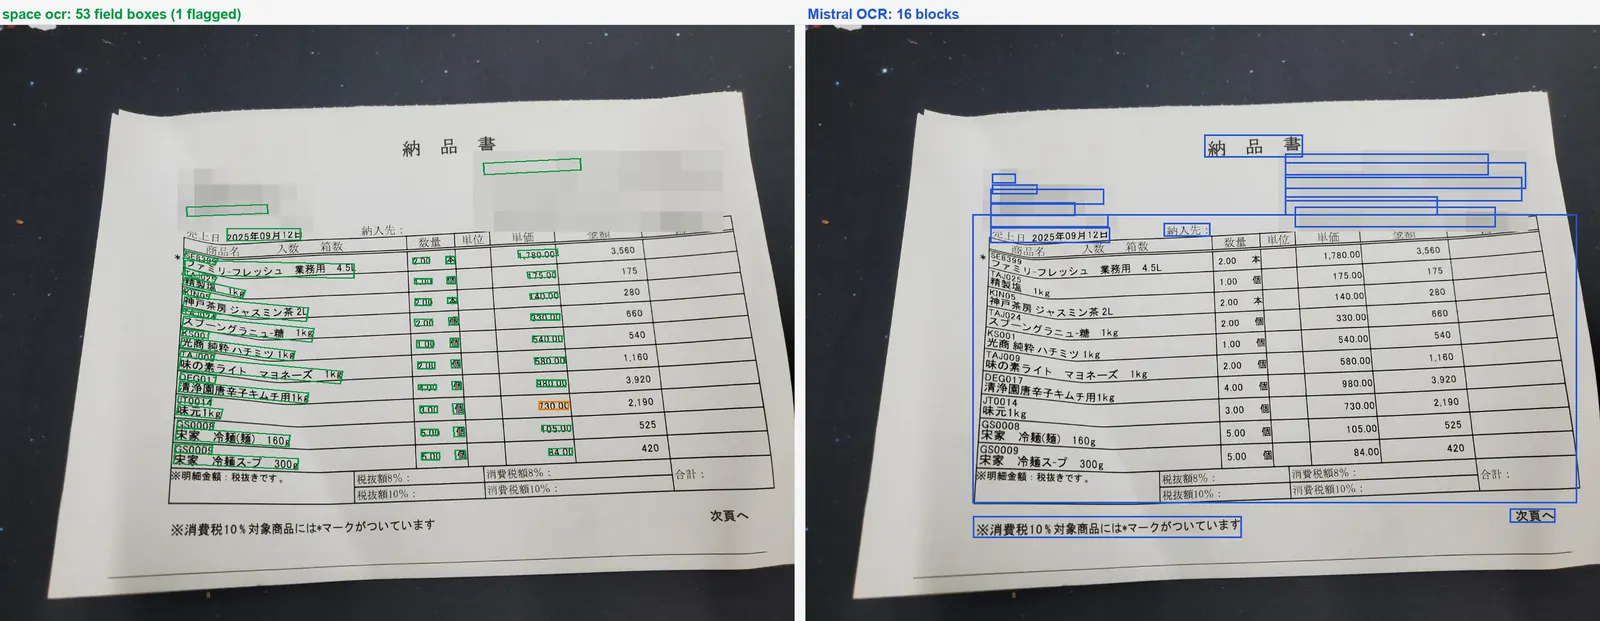
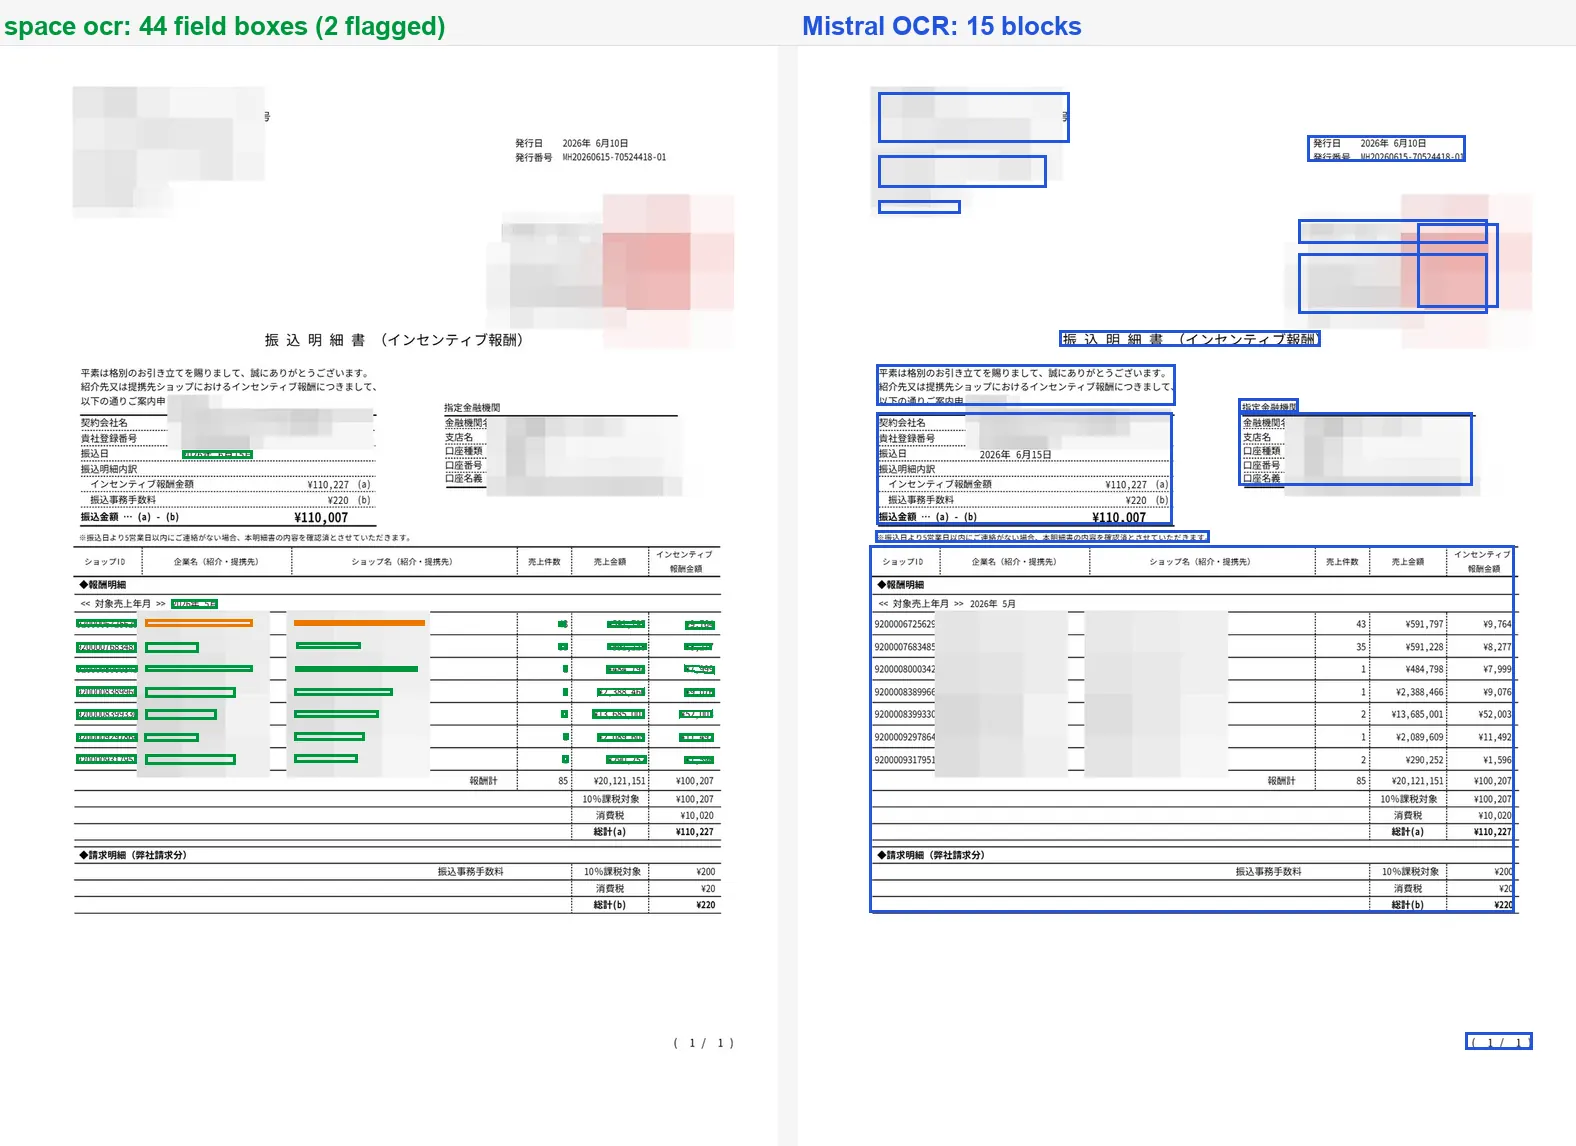
検証がどう回るかが、この記事の主張そのものだ。言語モデルは値と単語単位のヒントを返すだけで、座標は作らない。エンジンがその値を、ページで実際に検出された文字と 1 文字ずつ突き合わせ、ボックスをその文字の上に着地させ、どれだけ一致したかを evidence.match_ratio として点数化する(0.85 以上で確信一致)。この比率は判定を裏付ける証拠の一つであって、それ単独の関門ではない。二つの読みが食い違えば review.reasons に text_mismatch などの理由コードが立ち、verified は false になり、その値は見るべきものの一覧である data.review.flagged に入る。座標は値ごとに、0〜1000 のグリッド上の xmin/ymin/xmax/ymax を持つ box と、傾いたページ用に順序付きの 4 頂点を持つ quad として返ってくる。
この記事が測っていないもの
測ったのは 2026 年 8 月時点、8 ケースでのフィールド抽出だ。速度も価格も測っていない。Mistral のマークダウン変換も測っていない。あれは別の仕事をする別の製品で、今回の実行には一度も入っていない。書類読み取り一般の話でもない。一社の回帰セットから取った 8 ケースは小さく、わざと意地悪に選んだ標本で、日本語の業務帳票と照明の悪い写真に偏っている。
素材はすべて残してある。実行スクリプト、採点済みの 72 回、両ベンダーの生の応答、上の画像を描いたスクリプトまで。
それでも一番役に立つベンチマークは自分のものだ。いつも手こずる書類を 5 枚選び、正解を先に手で書き、同じフィールド一覧を両方の API に送り、それぞれ 3 回走らせてほしい。以下の手順がこちらのやり方そのままである。成功したスキャンは 1 枚 10 円、失敗時は課金なし、毎月最初の 100 ページは無料なので、自分で確かめる費用は実質かからない。
- デモではなく痛い書類を選ぶ複数行レコード、繰り返す値、画面を撮った写真、密な表など、実際に苦労させられるページを5〜10枚。きれいなサンプルではベンダーの差は出ません。
- スキーマと指示を1つに固定するフィールド一覧を一度だけ書き、同じ名前と説明で全エンジンに同一送信します。値は印字どおりに要求してください。
- 正解データは先に手で書く何かを走らせる前にフィールドごとの期待値を書き写し、その後は編集しません。
- 各エンジンを最低3回走らせる1回の実行は不安定さを隠します。すべての実行を同じスクリプトで採点し、平均ではなくばらつきを見てください。
- 静かな誤りを別に数える間違った値ごとに、エンジンがフラグを付けたかを記録します。フラグ付きの誤答は一瞥のコストですが、シグナルのない誤答はその上に築いたプロセス全体のコストです。