スマホ写真から、スプレッドシートの1行へ
レシートや請求書、あらゆる書類をスマホで撮るだけで、構造化されたデータがスプレッドシートに。傾いた写真や複数言語が混在した書類も自動で処理します。
山積みのレシート、スキャンされた請求書のフォルダ。目的は一つ、そこから主要な情報を抜き出してスプレッドシートにまとめること。しかし現実は、画像を開き、目を凝らし、項目を一つひとつ手で打ち込む地道な作業です。写真は急いで撮られたものが多く、少し傾いていたり、変な影が映り込んでいたり。時間もかかり、間違いも起きやすい、誰もが避けたい作業でしょう。
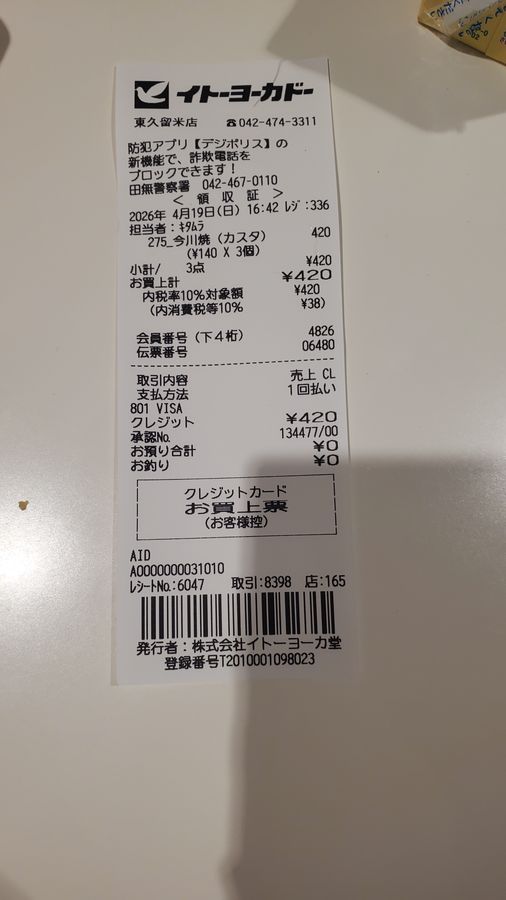
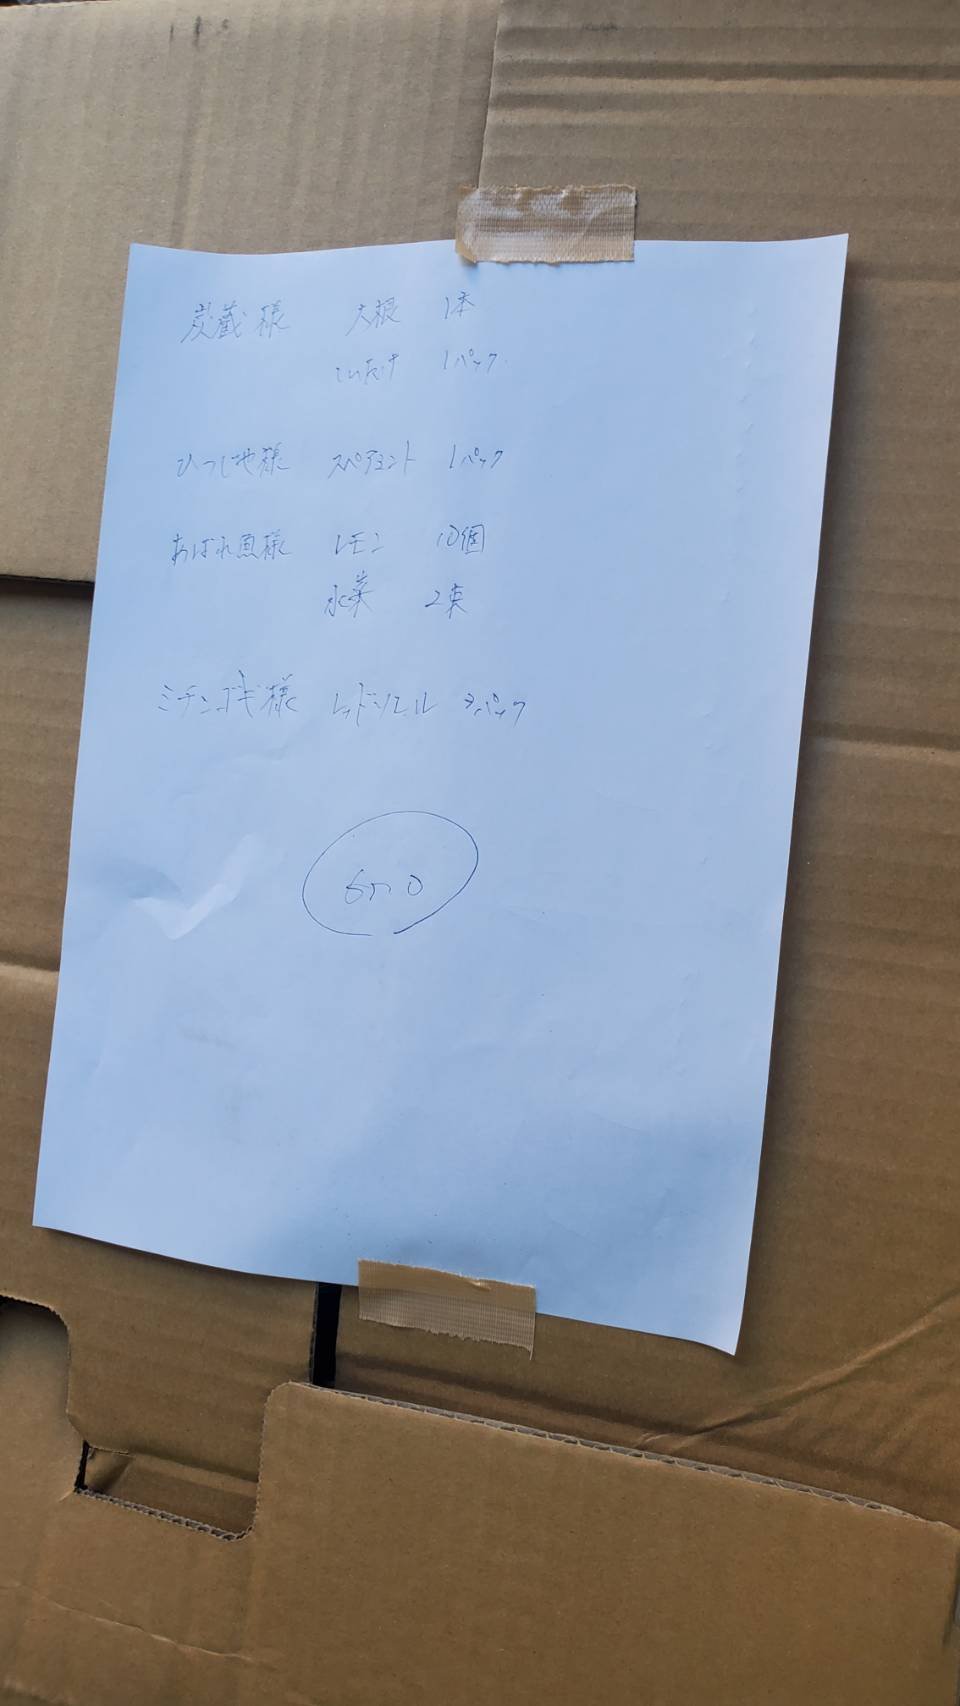
この手入力作業を、丸ごと省略できたらどうでしょう。space-ocrでは、まず取引先、請求日、合計金額といった必要な列を一度だけ定義します。どの列にするか決めかねる場合は、見本の写真から列を自動検出させ、提案された内容を手直しすることもできます(APIではautoFieldsに相当します)。あとは、レイアウトが異なる書類の画像でも、次々とアップロードするだけ。取引先ごとに形式が違う請求書やレシートも、すべて同じ構造のきれいな行データとして出力されます。スキャナやスマホのカメラで撮った、JPEG、PNG、GIF、WebPといった標準的な画像形式に直接対応しています。
スマホ写真特有のクセにも対応しています。スマートフォンを縦に持って撮影すると、画像ファイルには向きを補正するための回転情報(EXIF)が含まれることがよくあります。space-ocrはアップロード時にこのデータを読み取り、画像を自動で補正します。これにより、抽出されたテキストの座標は、画面で見ている画像と一致します。また、大きな写真は読み取りの前にサーバー側で縮小されることがあるため、座標は送信したファイルの画素数ではなく、実際に読み取った紙面を基準としています。言語を手動で選択する必要もありません。日本語、英語、韓国語など、複数の言語が同じ書類内に混在していても、システムが自動で検出し処理します。
space-ocrは値を読み取るだけでなく、その値がどこから来たのかを記録します。まずモデルがテキスト値を提案し、システムはその提案を、OCRがページ上で実際に検出した記号と一文字ずつ照合します。各値には写真上の位置が付きます。傾きのない矩形がbox、撮影時の傾きに沿う4点がquadです。座標はすべて0から1000のグリッドに正規化され、実際に読み取った紙面(data.image)を基準とするため、そのまま画像の上に描き戻せます。二つの読み取りが食い違った場合や、指定した項目がページ上に見当たらない場合、その値は黙って通過せず、確認対象の一覧(data.review.flagged)に載ります。両者が同じ誤読で一致する可能性は残るため、この一覧は確認すべき箇所を絞り込むものであり、確認そのものを不要にするものではありません。
料金体系はシンプルです。画像1枚あたり¥10(税込)。すべてのアカウントで、毎月100スキャン分を無料でご利用いただけます。また、技術的な理由でスキャンが結果を生成できなかった場合、その分の料金は発生しません。プランの詳細は料金ページをご覧ください。書類からデータを取り出し、より使いやすい形式に変換するための、シンプルな都度払いのユーティリティです。
- シートを作成「取引先」「日付」「合計」など、必要な列を定義します。これがシートのスキーマ(列定義)になります。決めかねる場合は、見本の写真から列を自動検出させ、手直しすることもできます。
- 写真を撮るスマートフォンでレシートや請求書など、任意の書類を撮影します。完全に平らでなくても問題ありません。
- 画像をアップロードJPEGやPNGファイルを、space-ocrウェブアプリ上のシートにドラッグ&ドロップします。
- データを確認抽出されたデータが正しい列に自動で入力され、新しい行として表示されます。各値は写真上の位置にリンクしており、簡単に検証できます。