バウンディングボックス付き構造化フィールドOCR APIを2026年に実装する
2026年版の実践ガイド。バウンディングボックス付きの構造化フィールドOCR APIで、検証可能で監査に耐える文書データパイプラインを構築する。
座標を持たない文字列は、データではなく推測にすぎない。ブラックボックスの抽出器が生んだ「幻覚」文字を何時間もかけて手作業で照合した経験があるなら、生のテキストだけでは本番運用の自動化には足りないと気づいているはずだ。データがどこから来たのかを、正確に目で確認できる必要がある。バウンディングボックスを返すOCR APIを組み込むと、ワークフローは「祈るような賭け」から、検証可能な監査証跡へと変わる。これは、固定サブスクリプション費用や硬直した拡張性のない処理モデルの非効率から抜け出すための、技術的な土台になる。
本稿では、こうした空間座標を使って、信頼できるヒューマン・イン・ザ・ループ検証を支える高い整合性の構造化データパイプラインを組み立てる方法を見ていく。JSON出力を文書上の領域へ直接マッピングする仕組みと、実際の処理量に合わせてスケールするシステムの作り方をたどる。構造化フィールド抽出、2026年に進んだビジョン言語モデルへの移行、そして手入力を「確認だけ」に減らすためのロジックを、順を追って分解する。読み終えるころには、非構造の文書を、チームが本当に信頼できる精密で実用的なデータセットへ変えるための設計図が手に入る。
この記事のポイント
- バウンディングボックス付きのOCR APIが、正確な空間座標を使って抽出テキストを物理的な出所へ直接マッピングし、完全な透明性をもたらす仕組みがわかる。
- 0〜1000の正規化座標グリッドが、なぜ画面サイズや画像DPIをまたいでもフロントエンドの検証オーバーレイを安定させるのかを理解する。
- 視覚的な監査証跡を実装し、「ブラックボックス」リスクを取り除いて、金額や法務など重要度の高い文書の処理を監査可能に保つ。
- Claude Codeプラグインを使い、依存関係ゼロのPythonクライアントを2行でインストールして、ターミナルから直接REST APIを呼び出す。
- 固定の月額ではなく、実際の処理量にコストを連動させる従量課金モデルへ移行し、運用オーバーヘッドを削る。
目次
- バウンディングボックス付きのOCR APIとは
- 技術アーキテクチャ:座標、JSON、そして信頼度
- なぜ「検証可能性」が文書データの新しい標準なのか
- 開発ワークフローへのバウンディングボックス統合
- space-ocr:摩擦ゼロの従量課金・構造化データ
バウンディングボックス付きのOCR APIとは
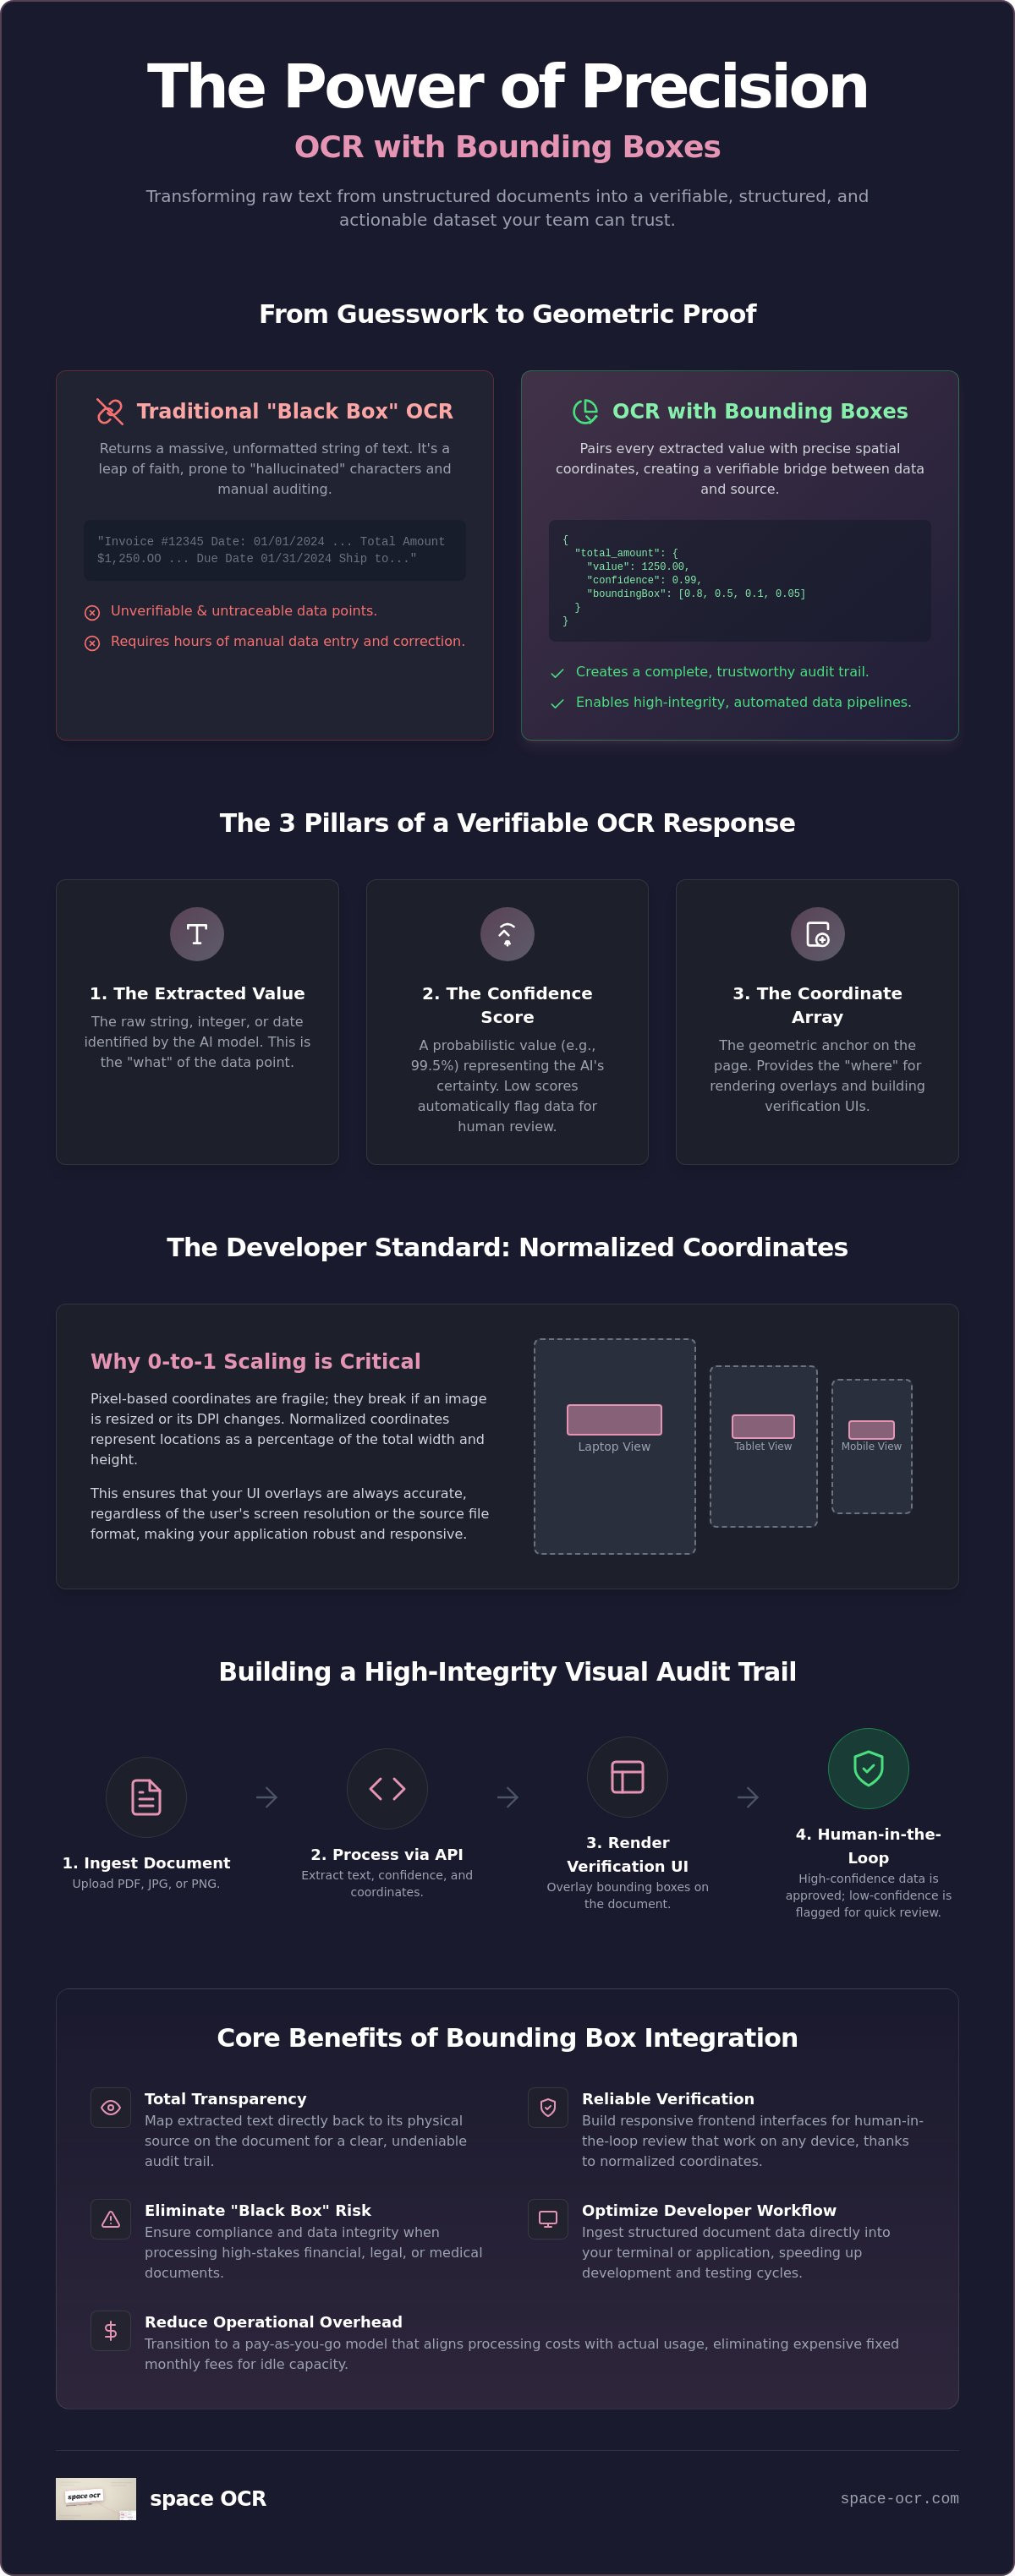
一般的な光学文字認識(OCR)エンジンは、たいてい整形されていない大量のテキスト文字列を返す。単純な検索インデックス作成にはそれで十分だが、自動化されたデータパイプラインでは破綻する。バウンディングボックス付きのOCR APIは、抽出した各フィールドを、文書上の正確な空間位置と対にする専用インターフェースだ。すべての値に対して座標を返すことで——0〜1000の正規化グリッド上のxmin、ymin、xmax、ymaxという整数ボックスとして——デジタルデータと物理的な出所を橋渡しする。「$1,250.00」のような値が得られるだけでなく、その値がページ上のどこにあるかという正確な位置まで手に入る。
この違いは構造化抽出において決定的だ。従来のOCRは文書をフラットなテキストファイルとして扱う。構造化OCRは、それをデータオブジェクトの集合として扱う。2026年、業界は生テキストのダンプから、検証可能なデータ構造へと軸足を移した。システムが税務IDを抽出するなら、そのフィールドを検証UI上でプログラム的にハイライトできる必要がある。バウンディングボックスがなければ、モデルの仕事を監査する手段はページ全体を読み直すことしか残らない。座標を持たないテキスト文字列は、重要度の高いワークフローでは負債になる。
バウンディングボックス vs. バウンディングリージョン
多くの実装は、標準的な4点の長方形に依存している。こうしたバウンディングボックスは計算コストが低く、デジタルネイティブなページやきれいにスキャンされたフォームではうまく機能する。とはいえ現実の文書は、傾いたり回転したり、しわが寄ったりして届くことが多い。そうしたケースでは、軸に平行なボックスだけでは足りない。space-ocrは、軸平行の box(整数のxmin/ymin/xmax/ymax)と、文書の傾きに追従する4点の向き付き quad——頂点は左上、右上、右下、左下の順——の両方を返す。これにより、ゆがんだり回転したりしたレイアウトに対しても、単純なボックスでは出せない精度が得られ、それ以外のすべてには単純なボックスをそのまま使える。
現代的なOCRレスポンスの主要な構成要素
POST /ocr/fields が返す data は、4つの層でできている。層ごとに答えている問いが違い、そのままデータベースに入るのは1つだけなので、分けて見ておく価値がある。
data.values—— 業務データそのもの。宣言したスキーマと同じ形で、予約キーは混ざらないため、そのまま保存できる。ただしこれは印字のバイト単位の複製ではなく、モデルがページを読んだ文字列だ。完全一致で突き合わせるならcells[path].evidence.printed_text(その座標でOCRパスが読んだ文字)を使う。data.cells[path]—— 値ごとの出所と検査の結論を、パスをキーにして並べた層。total、items[0].amountのように引ける。各エントリはbox(整数のxmin/ymin/xmax/ymax)と4点のquad、判定のverified、nullか{ reasons }のreview、そして根拠のevidence(text_match・source・match_ratio・ocr_confidence・printed_text)を持つ。data.review—— 文書1枚分の集計と、flaggedに入る機械可読の要確認リスト。[{ path, reasons }]という形で、パスの文法はcellsのキーと同じだ。確認すべき件数はflagged.lengthそのもので、別のカウンタは無い。by_reasonは要確認になった各フィールドの理由をすべて数えるので、その合計は件数より大きくなり得る。data.normalized—— 決定的に解釈した型付きの読み。スカラー型(number・integer・date)か、pattern・enumを付けたstringを宣言したフィールドにだけ付く。valuesとまったく同じ形の疎なツリーで、normalized.totalがvalues.totalの隣に並ぶ。解釈は決定的で追加のモデル呼び出しは無く、解釈できなかった葉はnullになり、理由はcells[path].normalized.errorに入る。
この4つの隣に data.image(ピクセル単位の width と height)があり、すべての座標はこれを基準に測られている。
抽出が透明になるのは、この層の分け方があるからだ。ロジックの門にするのは、調整の要るしきい値ではなく条件1つでいい —— セルの review が null なら、走った検査はすべて通っている。verified: true が言っているのと同じことだ。match_ratio が消えたわけではない。判定の裏側にある evidence の中の信号の1つとして残っているだけで、判定そのものではない。値がページのどこから来るべきかを指定したいなら、リクエスト側で言える。label は指定したラベルの隣の出現に座標をアンカーし、near / not_near は値のそばに印字されているべき(あるいは、あってはならない)語彙を宣言する。この制御の水準こそが、基本的な文字認識と構造化フィールドOCR APIを分けるものだ。
技術アーキテクチャ:座標、JSON、そして信頼度
文書パイプラインの構築には、文字検出以上のものが要る。データの空間的な理解が必要だ。バウンディングボックス付きのOCR APIを組み込むとき、もっとも重要なアーキテクチャ上の判断は、座標をどう扱うかだ。生のピクセル座標はもろい。前処理でソース画像がリサイズ・再エンコード・DPI調整されると、絶対ピクセル値は使い物にならなくなる。だからspace-ocrは、ピクセルではなく0〜1000の正規化グリッド上で座標を返す。(0,0)が左上、(1000,1000)が右下で、画像の実ピクセル寸法とは独立している。ボックスを描くときは元のスケールへ戻す——pixel_x = xmin / 1000 * image_width——ので、基礎となる幾何を再計算せずに、フロントエンドは任意の解像度でオーバーレイを描画できる。この式の image_width は data.image から取る。ここは正確に押さえておきたい —— data.image は実際に読まれたページの寸法で、EXIFの向きがピクセルに焼き込まれた後(4000×3000で送っても3000×4000で返ることがある)、サーバ側の縮小が入った後の値だ。送信したファイルそのものではない。data.image を基準に描けば枠は合い、元ファイルの寸法で描くと、回転や縮小の分だけずれる。傾き補正も行わないので、傾いた写真の quad は傾きをそのまま追う。
エンジンとAPIはPDFバイトではなく、ラスター画像を扱う。space-ocrのウェブアプリに複数ページのPDFをドロップすると、pdf.jsで各ページをPNGにレンダリングし、そのページ画像に対してOCRを実行する。APIを直接使う場合は、1リクエストにつき1画像を送る形になり、PDFのページはあらかじめ画像へ変換しておく。座標はすべて、それが由来したページ画像を基準にしている——ページインデックスがネストしたペイロードを解きほぐす必要はない。不正なデータをデータベースに入れないためには、数値ではなく判定を門にする。セルの review が null(つまり verified: true)なら、走った検査はすべて通っている。理由が付いたものは data.review.flagged に、その理由ごと並ぶ。理由の語彙は決まっていて文書化されている(text_mismatch・low_ratio・weak_source・nobox・missing など)ので、キューはスコアではなく理由で振り分けられる。判定の裏側は evidence に入る —— source(例: vision_symbol_match)、ocr_confidence、そして match_ratio、すなわちその値の文字のうちOCRパスがページ上で検出したシンボルの中から再び見つかった割合(0.0〜1.0)だ。この比率はページに対するカバレッジであって、モデルの自己確信度スコアではない。0.85以上は確信のある一致として扱うが、これは判定への入力の1つであって門そのものではない。こうして門を置けば、未検証の値をデータベースに入れずに、カバレッジの高い抽出は自動的に流していける。
構造化JSONレスポンスの構造
フィールド単位の抽出は、請求書番号や税務IDといった特定のキーを、正確な幾何アンカーへマッピングする。表の明細行になると、これはもう少し込み入る。配列フィールドは行へ展開され、各セルが data.cells の中に添字付きパスで自分のエントリを持つので、行と列の関係が保たれる。items[0] のような行パスは行全体のユニオンボックスで、その中の1セルが items[0].amount だ。この文法は review.flagged[].path と同じなので、要確認に挙がったパスはそのまま cells の参照キーになる。
4つの層が一度に見えるレスポンスを1つ置く。リクエストで宣言したのは invoice_no・date・items[]・total で、cells はパスごとに1エントリ持つため、ここでは話題にしている2つに絞ってある。
{
  "status": "success",
  "data": {
    "values": {
      "invoice_no": "",
      "date": "2025-04-10",
      "items": [
        { "name": "牛乳", "qty": "1", "amount": "¥198" }
      ],
      "total": "¥548"
    },
    "cells": {
      "items[0].amount": {
        "box": { "xmin": 693, "ymin": 460, "xmax": 738, "ymax": 488 },
        "quad": [{ "x": 693, "y": 460 }, { "x": 738, "y": 460 }, { "x": 738, "y": 488 }, { "x": 693, "y": 488 }],
        "verified": false,
        "review": { "reasons": ["text_mismatch"] },
        "evidence": { "text_match": false, "source": "vision_symbol_match", "match_ratio": 0.62, "ocr_confidence": 0.88 }
      },
      "total": {
        "box": { "xmin": 380, "ymin": 720, "xmax": 530, "ymax": 742 },
        "quad": [{ "x": 380, "y": 720 }, { "x": 530, "y": 720 }, { "x": 530, "y": 742 }, { "x": 380, "y": 742 }],
        "verified": true,
        "review": null,
        "evidence": { "text_match": true, "source": "vision_symbol_match", "match_ratio": 1.0, "ocr_confidence": 0.98 },
        "normalized": { "value": 548, "type": "number", "method": "deterministic" }
      }
    },
    "review": {
      "unit": "field",
      "declared": 6,
      "returned": 5,
      "boxed": 5,
      "verified": 4,
      "flagged": [
        { "path": "items[0].amount", "reasons": ["text_mismatch"] },
        { "path": "invoice_no", "reasons": ["missing"] }
      ],
      "by_reason": { "text_mismatch": 1, "missing": 1 }
    },
    "normalized": { "total": 548 },
    "image": { "width": 1654, "height": 2339 }
  }
}順に読めば契約が見える。values はデータそのものだ。cells は各値がどこにあり、検査が何を結論したかを言う —— items[0].amount は印字と食い違ったので verified: false と理由 text_mismatch で返り、total は一致してその根拠を持っている。review.flagged は作業リストだ。その金額に加えて、required を宣言したのに一度も返ってこなかった invoice_no が載る。返ってこなかった値には照合する相手が無いため、文字照合が原理的に届かない唯一のクラスだ。そして normalized は、values の文字列に手を触れないまま total の型付きの読みを持つ。アプリケーションが文書をフラットな画像ではなくクエリ可能なデータセットとして扱えるのは、この形のおかげだ。
検証は抽出の隣にある
座標は値がどこから来たかを言えるが、その値がその欄に入るべきかどうかは言えない。後者に答えるのは、フィールドを求めるのと同じリクエストだ。FieldSpecは name や type の隣に宣言を取り、宣言ごとに対応する理由が review に用意されている。
required—— 空で返るか、レスポンスから丸ごと欠けた項目は、理由missingとして並ぶ。文字照合が原理的に届かない唯一のクラスだ。label—— 値の横に印字されているラベル。同じ値がページに複数回印字されているとき、座標をそのラベルの隣の出現にアンカーする。ラベルがページに正確に1回だけ印字されているときに働き、見つからなければ通常の探索に戻ったうえで、その事実がreview.notesにlabel_unresolvedとして載る。pattern—— 値が満たすべき正規表現(string型専用。JSON Schemaと同じ部分一致なので、値全体を見るなら^…$を付ける)。破るとpattern_mismatch。enum—— 業務側がすでに持っている値の集合(取引先マスタ、品目マスタ、単位の一覧)。集合の外ならpattern_mismatchが立つ。両エンジンが同じ誤読で一致してしまうクラスに効く唯一の手立てでもある —— 文字どうしの突き合わせは、両方が同じ間違いをしたときに構造的に何も言えない。min/max——number/integerの範囲(両端を含む)。正規化後の数値に対して判定し、外れるとout_of_range。near/not_near—— 値のそばに印字されているべき(あるいは、あってはならない)語彙。宛先なら["御中", "様"]、発行元ブロックなら["登録番号", "〒", "TEL"]といった具合だ。理由はnear_mismatch・near_ambiguous・near_conflictで、モデルが完璧に読んだうえで別の場所の値を選んだクラスに届く。選択を正しくするのではなく、間違った選択を見えるようにする。
これらの宣言はどれもモデルには渡らない。宣言したから抽出が正確になるわけではなく、値は宣言してもしなくても同じように返ってくる。生まれるのは検討の合図(label の場合は座標のアンカー)で、プログラムから扱えるのはそちらだ。
非同期ジョブ処理の実装
大量の文書をバッチ処理するには、タイムアウトやリソース枯渇を避けるための非同期経路が要る。文書処理向けのREST APIを使えば、ファイルを一括で送信し、画像ごとにジョブIDを受け取れる(各ジョブは最初status「pending」で始まる)。完了確認にはポーリングという単純な手もあるが、本番構成ではWebhookを使うべきだ。Webhookは処理が終わった瞬間に、すべてのバウンディングボックスデータを含む最終JSONペイロードをあなたのサーバーへプッシュする。このイベント駆動のアプローチこそが、従量課金アーキテクチャ上で数千枚の画像へスケールさせるための鍵になる。事前のコミットなしでこうしたワークフローを試したいなら、space-ocrは最低利用量なしで変動するワークロードを扱える。
なぜ「検証可能性」が文書データの新しい標準なのか
モデルを盲目的に信用することは、コンプライアンス上の問題だ。出所への参照なしにデータを取り込むシステムは、ブラックボックスの中で動いていることになる。バウンディングボックス付きのOCR APIは、モデルを盲目的な信頼から、証拠に基づく抽出へと移す。データポイントがどこから来たのかを正確に示す、視覚的な監査証跡を提供するからだ。これは、たった一文字の読み違いが実害につながりうる、重要度の高い金額・法務文書で意味を持つ。「合計金額」が右下の隅から来たのであって、ページのどこかにある無関係な日付文字列から来たのではない、と確認できる必要がある。
ヒューマン・イン・ザ・ループのUIでは、これらのボックスを文書画像に直接オーバーレイし、オペレーターがモデルの仕事を素早くチェックできるようにする。手作業のデータ入力は一般に数%前半のエラー率を伴い、ボックス単位の検証はそうしたミスを見つける時間を削る。請求書番号や税務IDを探してページ全体を走査する代わりに、オペレーターはハイライトされた領域へ直接ジャンプできる。あなたが作っているのは、単に機能するだけでなく、監査可能なシステムだ。その透明性こそが、規制のある環境で自動化ワークフローを成り立たせる。
金融コンプライアンスのためのOCR
監査人は証拠を求める。抽出したフィールドと一緒にバウンディングボックスのメタデータを「Spaces」に保存すると、デジタル記録と元画像のあいだに恒久的なリンク——監査時に検証可能な証拠——が生まれる。パイプラインを保護するには、HMAC署名付きWebhook(署名ヘッダーはX-Spaceocr-Signature、HMAC-SHA256)でデータを受け取り、APIと内部データベースのあいだでペイロードが改ざんされていないことを確認できるようにする。金融インフラにとって信頼性は「あれば嬉しい」ものではなく、前提条件だ。
手書きテキストから構造化データへ
手書きは、従来のエンジンにとって悪名高いほど難しい。手書きテキストを構造化データへ抽出するのは、非標準のレイアウトや筆致のばらつきのために複雑になる。ここでバウンディングボックスが効いてくる。乱雑な手書きメモやFAXを通るモデルの経路を可視化できるからだ。複雑なフォーム上でフィールドがずれた位置に落ちても、座標データがあれば、その配置をプログラム的に補正できる。推測しているのではなく、cells に判定と根拠を持つ幾何アンカーを使って、誤りを直し、最終データセットを誠実に保っている。ページ上の位置にどうしても結び付けられなかった値も黙って消えるのではなく、理由 nobox として要確認リストに出てくる。
開発ワークフローへのバウンディングボックス統合
生のJSONは出発点にすぎない。バウンディングボックス付きのOCR APIの価値を最大限に引き出すには、それを既存の開発環境に組み込む。ワークフローは、手作業のファイルアップロードから、CLI駆動の自動化へと移ってきた。ターミナルからOCRを呼び出せば、ブラウザのタブとIDEを行き来する手間が減り、空間座標を使って特定のフィールドをその場でフィルタ・変換できる。
画像から構造化されたシートへの移行を自動化することは、大量処理チームによくあるユースケースだ。PDFからの表データ抽出APIを使えば、行の境界と列ヘッダーを識別し、CSVやデータベーススキーマへマッピングできる。これはテキストだけの話ではなく、構造的な幾何の話だ。スクリプトがテーブルセルのボックス座標を知っていれば、ある値が特定の列に属することを検証できる。サーバー側では、GET /view APIが、where・sort・selectフィルタで保存済みシートをクエリする——OCRの再実行も追加課金もない——一方で、アプリ内の「Spaces」は、グローバルなキーワード検索とキーボードによるグリッドナビゲーションを備えた、検索可能・編集可能なシートになっている。
Claude Codeプラグイン
Claude Codeプラグインは2行でインストールでき——/plugin marketplace add oisidonut/claude-space-ocr-skill、続けて/plugin install space-ocr@space-ocr——依存関係ゼロのPythonクライアントをセッションに落とし込む。クライアント自体を動かすのに、pip installもSDKもMCPサーバーも要らない —— 標準ライブラリだけのスクリプト1本がREST APIを直接呼ぶ。(エージェントをMCPでつなぎたい場合、space-ocrは https://mcp.space-ocr.com/mcp にエンドポイントを公開している。プラグインはそこを通らないというだけだ。)ターミナルから文書画像(請求書、領収書、名刺、身分証、フォーム)をspace-ocrのREST APIへ送ると、cells の box・quad と verified 判定を添えた構造化フィールドが返ってくる。あるいは、すでにスキャン済みの文書に問い合わせることもできる。環境を離れずにAPIを使いたい作り手にとって、実用的な道具だ。
Webhookと自動化
スケールにはイベント駆動のロジックが要る。Webhookを使えば、文書の処理が終わった瞬間に下流のアクションをトリガーできる。たとえば「ocr.completed」イベントを購読することで、領収書からのデータ抽出APIの出力を経理ワークフローへ流し込める。Zapierでも、Makeでも、独自のNode.jsバックエンドでも、ペイロードは検証の層を伴って届く。review.flagged がすでに「見直す価値のあるパス」の一覧なので、スクリプトは独自のスコアを作らずに、きれいな文書はそのまま登録し、残りだけ人へ回せる。こうしたパイプラインを今日から作り始めるには、space-ocrを使い始めて、検証可能なデータをあなたのスタックへ流し込もう。
space-ocr:摩擦ゼロの従量課金・構造化データ
硬直した定額サブスクだけの時代は終わった。文書量が変動するなら、使わない容量に払うのは不要なオーバーヘッドだ。space-ocrは成功した画像1枚につき¥10を課金するので、コストは実際の使用量に比例して伸びる——しかも、結果を返した抽出に対してのみ請求される。この実利主義は機能セットにも及ぶ。空間メタデータをプレミアムなアドオンとして扱うプロバイダもあるなか、space-ocrはバウンディングボックス付きのOCR APIを標準機能として返す。検証可能性はデータ整合性の基本要件であって、上位ティアへのアップグレードではない。
構造化フィールドOCR APIにたどり着くのに、調達のハードルを越える必要はない。無料ティアから始められ——月100スキャン、クレジットカード不要——自分の文書タイプで座標の精度を試せる。サインアップから最初の成功JSONペイロードまでの道のりは短い。数百枚の請求書を処理するスタートアップでも、はるかに大量を扱うチームでも、価格は予測可能なまま、データは検証可能なままだ。
Spacesでのデータ管理
アプリ内の「Spaces」は、生のAPI出力とチームの日々の作業をつなぐ橋だ。すべての抽出フィールドが、元文書上のボックスにリンクされたまま残る、検索可能・編集可能なシートになっている。抽出結果をレビューし、手動で修正できる。どの値も、由来したボックスに結び付いたままだ。グローバルなキーワード検索でシート全体のどの値でも見つけられ、キーボードによるグリッドナビゲーションで素早く移動できる。プログラム的なフィルタリングが必要なときは、GET /view APIが保存済みシートをサーバー側でwhere・sort・selectでクエリする——たとえばtotal>=40000やvendor~ABC——ので、一致した行だけが返り、OCRの再実行も課金もない。
数分で始める
統合はすぐに使えるよう作られている。APIキーを生成し、最初の画像を数分で処理できる。CLIベースの抽出には、Claude Codeプラグインを使えば、環境を離れずにローカルファイルをターミナルから送り、構造化データを受け取れる。生画像から検証済みのデータオブジェクトまでの道のりは短い。手入力を削って高い整合性のパイプラインを作る準備ができたら、space-ocrで検証可能なバウンディングボックス付きの文書処理を無料で始めよう。
検証可能な文書ワークフローをスケールさせる
生のテキスト抽出から、高い整合性のデータオブジェクトへ移ることは、本番運用の自動化においてもはや任意ではない。空間座標が監査証跡として働き、「ブラックボックス」の抽出を検証可能な記録へ変えるさまを見てきた。バウンディングボックス付きのOCR APIを実装すれば、素早いヒューマン・イン・ザ・ループ検証と精密なフィールドマッピングに必要な幾何アンカーを、チームに与えられる。この転換は、非構造データの曖昧さを取り除き、手入力を監査可能なパイプラインで置き換える。
信頼性が、窮屈な定額の値札とセットである必要はない。成功した画像1枚につき¥10、そしてClaude Codeプラグインのネイティブサポートがあれば、摩擦なくCLIやバックエンドサービスからこれらの機能を呼び出せる。検証可能なバウンディングボックスは現代のデータ整合性における標準要件なので、デフォルトで含まれ、すべての値はページに対して照合可能なまま残る。不透明なインターフェースの陰に隠れるのではなく、検証を招き入れるシステムを作るときだ。space-ocrを無料で使い始めて、高精度な抽出を今日から展開しよう。
よくある質問
OCRにおけるバウンディングボックスとバウンディングリージョンの違いは何ですか
バウンディングボックスは軸に平行な長方形です。space-ocrはこれを、0〜1000の正規化グリッド上の4つの整数——xmin、ymin、xmax、ymax——として返します。効率的で、きれいなデジタルネイティブ文書ではうまく機能します。傾いた・回転した・ゆがんだスキャンに対しては、space-ocrは文書の傾きに追従する4点の向き付きクアッド(quad、頂点は左上、右上、右下、左下の順)も返し、物理的に歪んだページに対して単純なボックスでは出せない精度をもたらします。
バウンディングボックスの座標を使ってPythonで画像に描画するにはどうすればいいですか
space-ocrは0〜1000グリッド上で座標を返すので、画像の寸法でスケールしてピクセルに変換します。幅1000ピクセルの画像なら、xminの500はピクセル500に対応します(pixel_x = xmin / 1000 * image_width)。幅2000ピクセルの画像なら、同じxminの500はピクセル1000に対応します。寸法は送信したファイルではなく data.image から取ってください —— EXIFの向きとサーバ側の縮小が入った後の、実際に読まれたページの寸法です。xmin、ymin、xmax、ymaxをピクセルで計算し、PillowやOpenCVでdraw.rectangleを呼び出せば、視覚的な検証用のオーバーレイを描画できます。
バウンディングボックス付きのOCR APIは手書きテキストを認識できますか
はい。手書きのメモやFAXも、印刷された文書と同じ構造化フィールドの経路を通り、各フィールドは cells に座標を伴って返るので、乱れた筆致を特定のキーへマッピングできます。手書きはアンカーがもっとも難しい領域ですが、レスポンスはそれを隠さずに言います。ページ上の位置に結び付けられなかった値は理由 nobox として review.flagged に載り、文字が印字と食い違えば text_mismatch が付きます。この幾何的なコンテキストと、確認が取れなかったものの明示的なリストがあるからこそ、非標準の手書きフォームでよく起きる位置ずれを見つけて直せます。
space-ocrは複数ページのPDF文書に対応していますか
space-ocrのウェブアプリは複数ページPDFに対応しています。各ページをPNGにレンダリングし、そのページ画像に対してOCRを実行するので、各ページはそれぞれ独立したラスター画像として処理されます。OCRエンジンとREST APIはPDFバイトではなく画像を扱うため、APIを直接使う場合はPDFのページをあらかじめ画像へ変換し、1リクエストにつき1枚ずつ送ります。座標は常にそれが由来したページ画像を基準にしているので、ページインデックスのネストを整合させる必要はありません。
バウンディングボックス付きのspace-ocr APIを使うといくらかかりますか
space-ocrは従量課金です。成功した画像1枚につき¥10で、結果を返した抽出に対してのみ請求されます——失敗分は課金されません。すべてのアカウントに毎月100回の無料スキャンも付きます。ページ単位やフィールド単位の価格はないので、コストは固定の月額最低料金ではなく、実際の量に連動します。
space-ocr用のClaude Codeプラグインはありますか
はい。2行でインストールでき——/plugin marketplace add oisidonut/claude-space-ocr-skill、続けて/plugin install space-ocr@space-ocr——space-ocrのREST APIを直接呼ぶ、依存関係ゼロのPythonクライアントを追加します。動かすのにpip installもSDKもMCPサーバーも要りません。(エージェントをMCPでつなぎたい場合は、space-ocrが https://mcp.space-ocr.com/mcp にエンドポイントを公開しています。プラグインは別の経路というだけです。)ターミナルから、文書画像を構造化フィールドに変えたり、すでにスキャン済みの文書に問い合わせたりでき、ブラウザに切り替える必要はありません。
提供されるバウンディングボックスの精度はどれくらいですか
各値には、素のスコアではなく判定が付きます。cells[path].verified は、走った検査がすべて一致すれば true、何かが立てば false、照合する相手が無ければ null になり、同じフィールドが理由とともに review.flagged にも現れます。evidence の中の match_ratio は、その値の文字のうち、OCRパスがページ上で検出したシンボルの中からspace-ocrが再び見つけられた割合(0.0〜1.0)です。ページに対するカバレッジであって、モデルの自己確信度スコアではありません。0.85以上なら、確信のある、シンボル一致にアンカーされたものとして扱います。review が null の値は自動で受け入れ、要確認に挙がったものをレビューUIへ回してください。
バウンディングボックス付きのデータをCSVやJSONファイルにエクスポートするにはどうすればいいですか
APIはデフォルトで構造化JSONを返すので、任意のフォーマットへパースできます。ノーコードの経路としては、Spacesウェブアプリが文書を検索可能なシートとして表示し、UTF-8 BOM付きでCSVにエクスポートします。これによりCJKテキストや通貨記号がExcelで正しく開けます。配列(明細行)の行はサブ行に展開されます。CSVは汎用フォーマットなので、スプレッドシートやデータベースに読み込めます——独自形式によるロックインはありません。